
 语音小管家
随着用户量的快速增⻓,语音识别性能问题凸显,CPU推理方案在峰值场景TP99延时较高,且难以满足高算力的业务场景。为确保良好的用户体验、进一步提升产品及服务质量,性能优化、降本增效势在必行。
vivo 自研语音识别流式推理引擎
wenet解码器,包括前端处理(特征、VAD等)->encoder->语言模型(wfst)->decoder流程。 数据调度,动态batching、分桶排序等。 Runtime适配层,抽象模型推理接口,便于适配不同推理后端。 Runtime层,后端推理层包括onnxruntime、GPU、昆仑芯的XpuRT等。
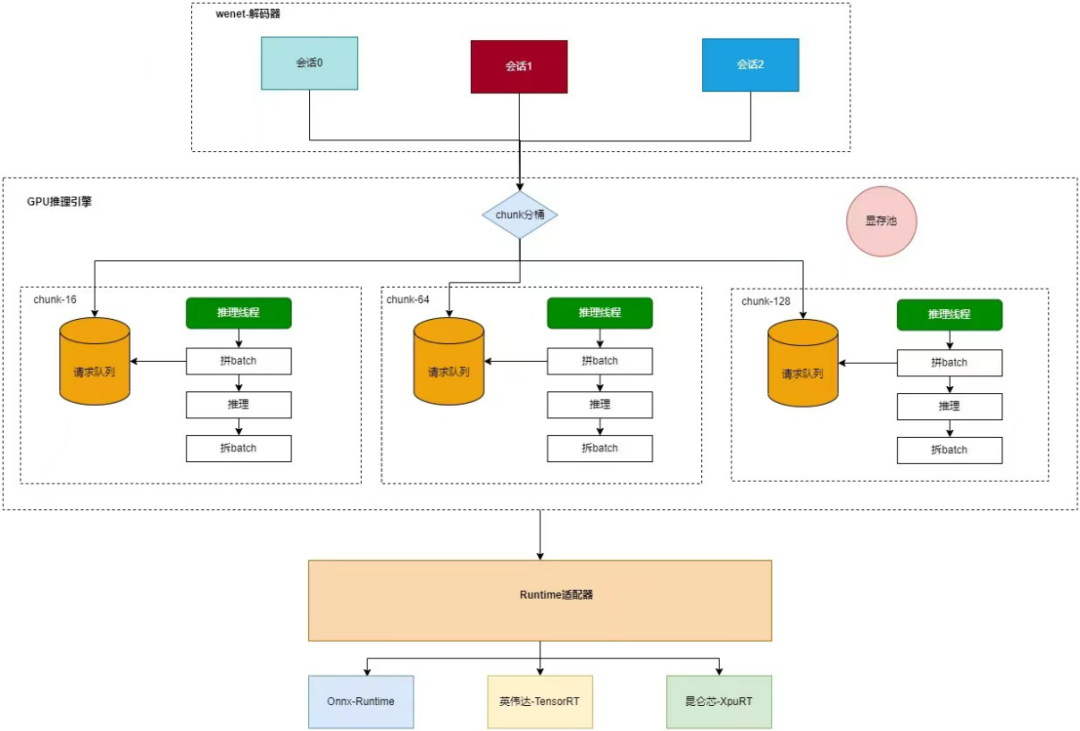
支持多batch流式请求,多batch能充分发挥硬件计算性能。 动态batchting,根据实际请求会在一定时间自动组装batch,便于提升引擎的并发吞吐能力。 分桶排序,减少多batch的无效padding,减少无效计算量。 显存池,高并发下流式识别缓存会频繁申请和释放,通过显存池优化了这部分开销,提高性能。
语言模型的lattice-faster-decoder过程有千万/秒的小对象内存申请(ForwardLink和BackpointerToken),通过将小对象合并大对象的池化方案,一次wfst的search从14ms减少到5ms。 线程模型优化。默认的线程模型是一个会话一个pthread线程,在GPU方案中,每秒数千线程创建系统负载较大,通过将pthread线程优化为bthread。 对象复用。将AsrDecoder池化复用,减少内存的动态申请,CPU性能提升27%。
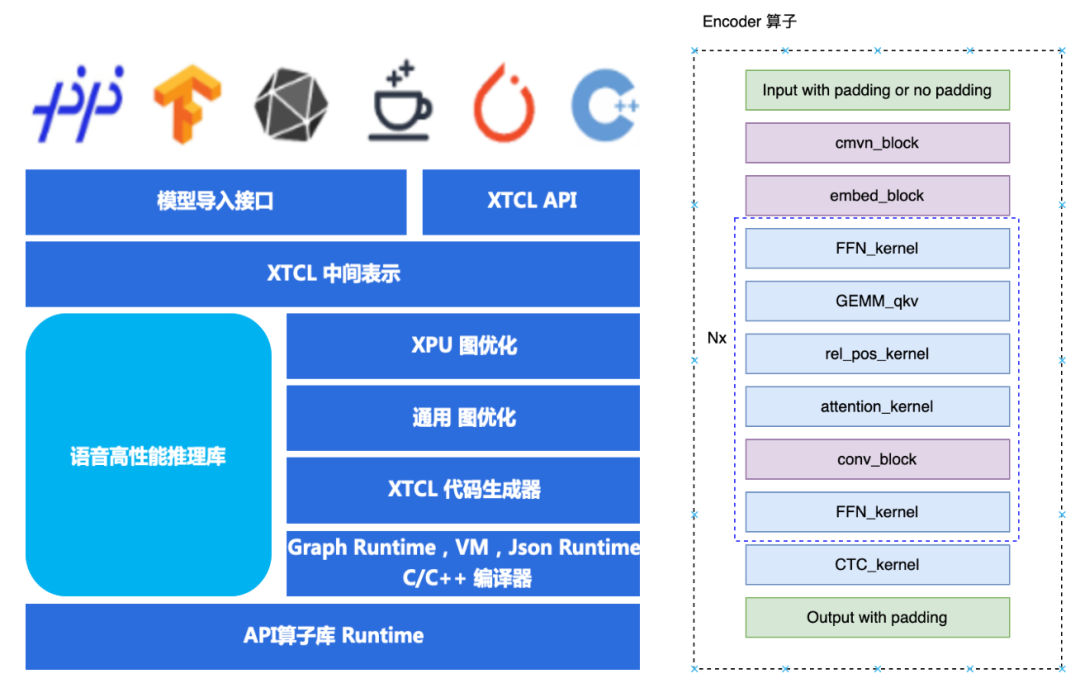
昆仑芯高性能推理库方案
支持动态shape,性能与静态shape无异,相比”静态模拟动态“可节省大量宝贵的显存资源。 支持多batch流式推理,解决流式推理一大难题,特别是cache管理。 深度图优化,使用了昆仑芯丰富的图融合优化,如:ffn_kernel_fusion、attention_fusion等,可变长优化技术等。 不同量化策略,FP16/INT8动态静态量化以及混合量化。 定制算子融合,如ConforermEncoder的RelPos相关计算可以融合为rel_pos_fusion_kernel等。 自动化工具,模型一键导入等。
性能测试
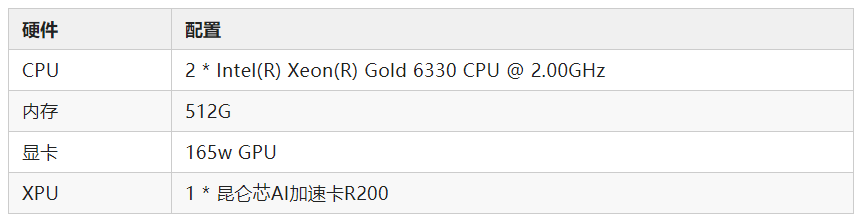
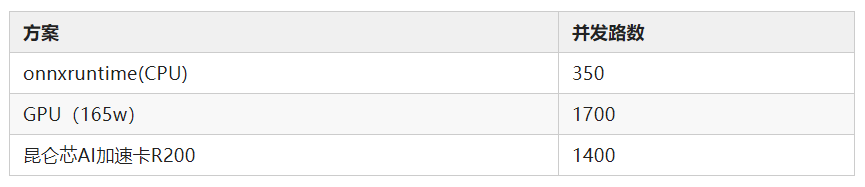
对比不同后端的性能数据onnxruntime(CPU)、GPU(165w)、昆仑芯XPU(R200),具体硬件配置如下:
最大并发数测试
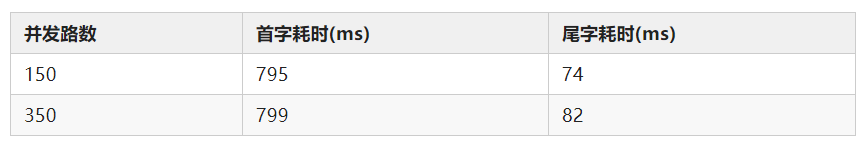
onnxruntime(CPU)首尾字耗时
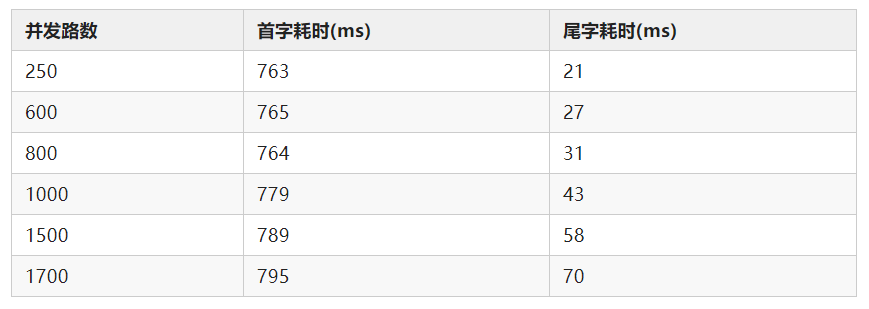
GPU(165w) FP16 首尾字耗时
昆仑芯AI加速卡 R200 FP16 首尾字耗时
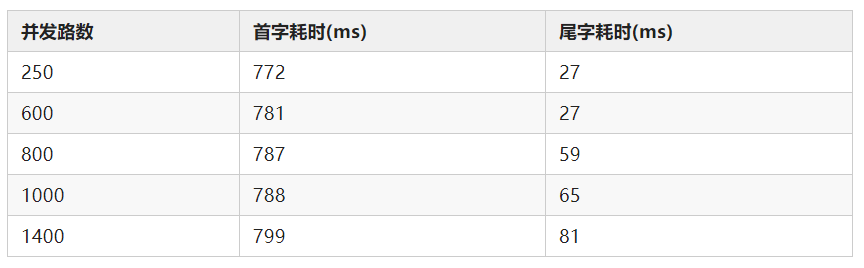
整体来看,在FP16量化后不同后端均达到精度无损,昆仑芯高性能推理库方案单卡并发达到了1400路,相比CPU的350路的最大并发,性能提升约4倍,首字和尾字耗时也大大降低,降本增效明显。单机单卡的测试外,也进行了单机4卡的压测,单机4卡GPU(165w)和4卡R200均达到了4000路并发。
相对主流 165w GPU,昆仑芯语音识别高性能推理库方案通过构建大算子的方式也为业务根据自身特性做针对性融合、量化、裁剪提供了更加便捷、更加有用的工具。
昆仑芯在wenet 中开源 XPU 支持
未来,昆仑芯科技将持续发挥在推理生态的领先优势,助力语音业务用户体验不断优化,同时也将与社区紧密合作,协力共建wenet国产生态。
关于vivo人工智能研究院
参考链接
vivo官网:https://www.vivo.com/
wenet官网:https://github.com/wenet-e2e/wenet
昆仑芯科技官网:https://www.kunlunxin.com.cn/
昆仑芯在wenet开源链接:https://github.com/wenet-e2e/wenet/tree/main/runtime/kunlun
