
你是否想过,未来的音频编辑可以像修改文字一样自然?只需一句话,就能从现场录音中移除观众掌声,同时保留演讲者的声音与空间感;替换歌曲中的一句歌词,同时保持歌手音色与伴奏结构不变;甚至通过多轮指令,逐步完成复杂的音频修改。
然而,真正可靠的音频编辑不仅要生成“听起来不错”的声音,还需要准确理解用户意图、精准执行编辑操作,并保留所有不应被改变的内容。现有系统在复杂指令执行、非目标内容保留与整体音质维持方面仍存在明显不足,可靠的通用音频编辑仍面临较大挑战。
赛事简介
ICASSP 2027 Audio Editing Challenge 由上海交通大学跨媒体语言智能实验室发起,并由来自国内外高校、科研机构及产业界的研究者共同组织。挑战聚焦通用音频编辑,考察系统能否听懂音频、理解自然语言指令、完成目标修改,并尽可能保留非目标内容并维持整体音质。挑战覆盖语音、音乐、环境声音及其混合内容,面向端到端生成模型(Single Model Track)与智能体(Agent Track)两类技术路线。
成绩优异的队伍将有机会受邀提交 ICASSP 2027 两页挑战赛论文和获得由腾讯赞助的现金奖励。论文经审稿录用后,将收录于 ICASSP 会议论文集,作者须按要求完成会议注册并进行现场报告。在 ICASSP 2027 现场报告工作的团队,还将获邀向 IEEE Open Journal of Signal Processing(OJ-SP)提交完整研究论文,稿件须经过期刊同行评审。
赛道设置
单模型赛道(Single Model Track)
参赛者需要构建统一的端到端音频编辑模型,根据输入音频和自然语言指令直接生成编辑结果。任务覆盖 MMAE 中的各类音频模态,复杂度限定为 MMAE 的 single 类别。推理阶段不得调用额外的 ASR、声源分离、规划或编辑工具,也不得使用商业 API 或人工后处理。
智能体赛道(Agent Track)
参赛者需要构建自主音频编辑智能体,自主规划并调用本地部署的开源模型或信号处理工具,检查中间结果并迭代修正。该赛道支持单步任务以及多部分、多指令、多音频、多轮交互和多跳任务;推理过程中不得有人参与。Agent系统所有模型组件的具体版本及权重须于 2026 年 10 月 1 日前公开发布,禁止使用闭源模型。系统中需要的大语言模型可在本地部署,也可通过云端 API 调用,但调用版本须对应已公开的模型权重,禁止使用闭源大语言模型;其他模型与工具须在本地运行。参赛队伍须提供模型版本、权重链接及公开发布时间依据,并提交部署与调用配置、运行记录,以供复现与审计。
数据与评测
开发阶段和排行榜阶段使用公开的 MMAE benchmark,包含 2,000 条样例和 17,741 条原子级评测标准,覆盖多种音频类型、编辑操作和任务复杂度。下图展示了 MMAE benchmark 的代表性任务,涵盖不同音频模态、任务复杂度与编辑操作,并列出了对应的评测要点。
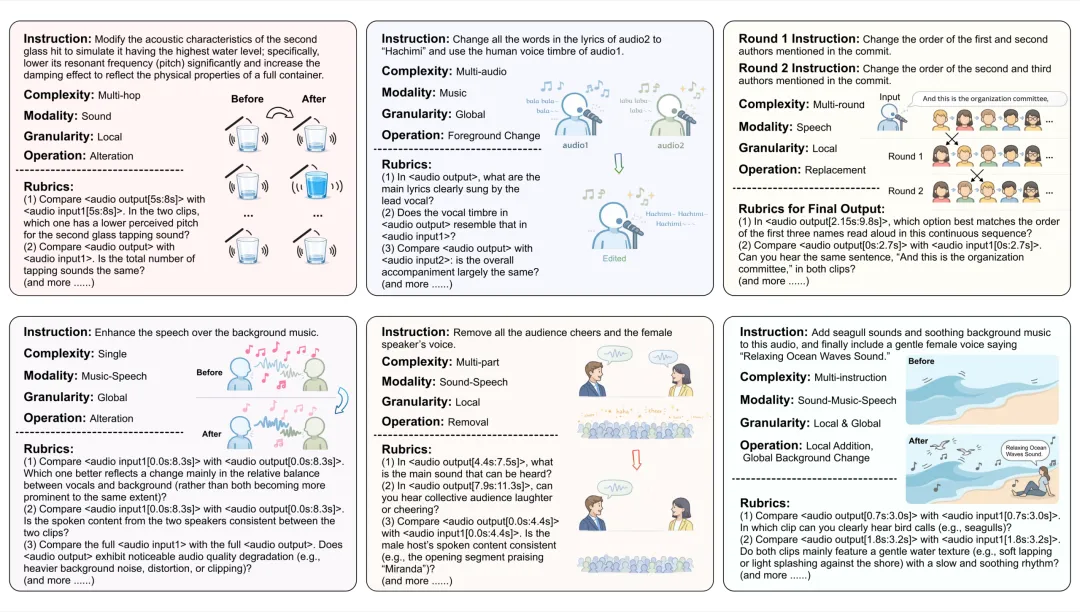
图 1|MMAE 代表性任务及对应评测要点
最终评测中,单模型赛道与智能体赛道各使用组委会保留的 500 条未公开测试样例。两个赛道分别排名,主要依据 Overall EMR(Exact Match Rate)排序;若 EMR 相同,则依次比较 IFR(Instruction Following Rate)和 CR(Consistency Rate)。
评测采用 Qwen3-Omni 作为评审模型,流程如下:
- 根据每条原子级评测标准,向评审模型提供所需的原始音频、编辑后音频及对应的评测问题与选项。
- 由 Qwen3-Omni 根据评测标准,检查目标修改是否完成、无关内容是否保留及音质是否受到影响。
- 对每条评测标准独立评测三次,通过多数投票确定结果。
- 汇总评测结果,并计算 EMR、IFR 与 CR。
基线系统
本次挑战赛为 Single Model 和 Agent 两个赛道分别提供了开源基线,作为可复现的技术起点与实验对照,帮助参赛者跑通全流程。
- Single Model 赛道:基于 AuK 的端到端音频编辑。 该基线采用 AuK 基础模型,直接根据输入音频和自然语言指令生成编辑结果。为保持单模型设置,基线关闭了 Prompt Enhancer(提示词增强模块),并保持输出音频与输入音频时长一致,为探索单一模型的指令理解与音频编辑能力提供参考。
- Agent 赛道:由大语言模型(LLM)调度多种音频工具。 该基线默认以 DeepSeek-V4-Flash作为调度器,根据编辑指令选择合适的处理工具:速度、音量和音高调整由数字信号处理工具完成,声源分离由 SAM-Audio-Large 完成,生成式音频编辑则调用启用 Prompt Enhancer的 AuK。
代码地址:https://github.com/Audio-Editing-Challenge/Audio-Editing-Challenge-Baseline
重要时间节点
- 2026 年 9 月 1 日:报名开启,发布挑战指南
- 2026 年 10 月 1 日:挑战正式开始
- 2026 年 11 月 10 日:数据发布,排行榜开放提交
- 2026 年 11 月 25 日:最终提交截止,排行榜冻结
- 2026 年 12 月 7 日:评测与可复现性检查完成
- 2026 年 12 月 8 日:公布最终排名及受邀队伍
- 2027 年 1 月 7 日:受邀队伍提交 ICASSP 两页论文
注:以上截止时间均为美国太平洋时间当日 23:59;具体安排可能根据 ICASSP 2027 会议日程调整。
奖项设置
本次挑战赛奖金由腾讯赞助,总奖金为 7,000 美元。 单模型赛道与智能体赛道分别评选前三名,每个赛道的奖金设置如下:
- 一等奖(第 1 名):2,000 美元
- 二等奖(第 2 名):1,000 美元
- 三等奖(第 3 名):500 美元
感谢腾讯对本次挑战赛及音频编辑技术研究的支持。
报名与官方网站
本次挑战赛已于 2026 年 9 月 1 日开放报名,目前报名进行中,欢迎高校、科研机构及产业界团队参与。报名时需填写机构或公司名称、队伍代表姓名、邮箱、国家或地区,并选择参赛赛道(可同时报名两个赛道)。
更多赛道说明、数据、提交要求及最新通知,请访问挑战赛官方网站:
https://audio-editing-challenge.github.io/
也可扫描下方二维码进入报名表、访问官网或加入交流社区。
报名表(Google Forms)
赛事官网
Slack 社区
微信交流群
如有任何问题,欢迎通过以下邮箱联系:zhikangniu@sjtu.edu.cn / tuwenming@sjtu.edu.cn
组织者
- Zhikang Niu (Shanghai Jiao Tong University)
- Wenming Tu (Shanghai Jiao Tong University; Beijing Institute for General Artificial Intelligence)
- Ziyang Ma (Shanghai Jiao Tong University; Nanyang Technological University)
- Ruiyang Xu (Shanghai Jiao Tong University)
- Hankun Wang (Shanghai Jiao Tong University)
- Bohan Li (Shanghai Jiao Tong University)
- Ruiqi Yan (Shanghai Jiao Tong University)
- Zilong Zheng (Beijing Institute for General Artificial Intelligence)
- Chunxiang Jin (Inclusion AI, Ant Group)
- Pengcheng Zhu (Ant Group)
- Hung-yi Lee (National Taiwan University)
- Jinyu Li (Microsoft Corporation)
- Carlos Busso (Carnegie Mellon University)
- Kai Yu (Shanghai Jiao Tong University)
- Eng Siong Chng (Nanyang Technological University)
- Xie Chen (Shanghai Jiao Tong University)