
我们生活在一个"声画一体"的世界
闭上眼,你能从脚步声判断有人走近;看不到音源时,你也会下意识去寻找声音的来处。对人类而言,看与听从来不是两件事——它们在同一个场景里彼此印证、互相补全。
可是在AI 的世界里,长期以来"看"和"听"却被拆成了两条平行赛道:视觉模型只盯着像素,音频模型只关心波形,声音常常沦为视频里"可有可无的附属通道"。当视频生成、数字人、全模态大模型接连爆发,一个事实越来越清晰:下一代多媒体智能,必须同时学会聆听、观看、推理与创造。
一个把"音视频联合"当作整体的研讨会
为推动这一方向,首届音视频联合理解与生成国际研讨会(JAV-CG,The 1st International Workshop on Joint Audio-Video Comprehension and Generation)将作为ACM Multimedia 2026官方研讨会,于 2026年11月10–14日在巴西里约热内卢举行。
JAV-CG 想做的,是把"音视频联合"从零散的子任务,重新组织成一个完整的研究问题,让多媒体、音频与语音、计算机视觉、多模态基础模型等社区坐到同一张桌子前。
我们关心三类问题
让AI 真正"看懂也听懂"——视听理解与推理。 声源在画面的哪个位置?这段视频里先后发生了什么事件?面对一段长视频,模型能不能可信地回答关于声音与画面的问题?
让AI 把声音和画面一起"造"出来——音视频生成。 给一段无声视频自动配上贴合的音效与配乐,用一段音频驱动出自然的说话人脸,或者让一句文本同时生成彼此同步的声音与画面。
让一个模型同时胜任理解与生成——统一视听框架。 any-to-any 的多模态生成、联合的表征与对齐、统一的大模型架构,以及配套的基准、数据集、评测与安全。
如果你在做这些,欢迎投稿
我们欢迎技术、立场与观点类论文(ACM 格式,正文至多 8 页,双盲评审,英文),分为可进入论文集的 archival 与用于现场展示的 non-archival 两类,并将评选最佳论文奖。
🕖关键时间
- 投稿截止:2026年7月16日
- 录用通知:2026年8月6日
- 终稿 Camera-ready:2026年8月20日
- 会议时间:2026年11月10–14日·里约热内卢
🎯投稿与主页
- 主页:https://javisverse.github.io/Workshop-MM26/
- 投稿(OpenReview):https://openreview.net/group?id=acmmm.org/ACMMM/2026/Workshop/JAV-CG
🚀特邀报告与组织者
首批公布的特邀报告人包括Yapeng Tian(University of Texas at Dallas)与 Chenliang Xu(University of Rochester),更多嘉宾陆续揭晓。
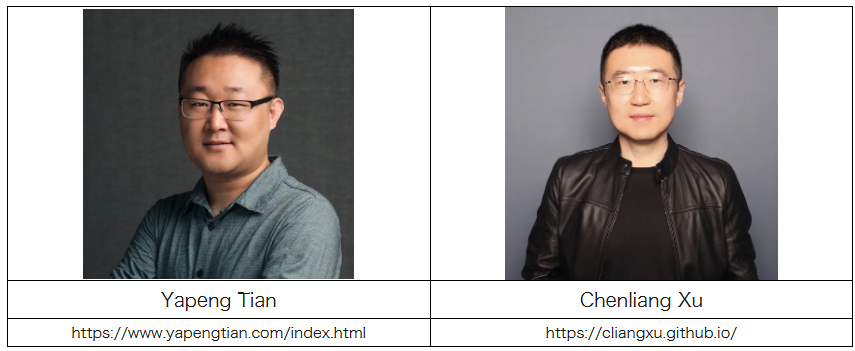
研讨会由来自新加坡国立大学、浙江大学、牛津大学、南京大学、澳大利亚国立大学、罗切斯特大学等机构的学者联合组织:You Qin、Kai Liu、Shengqiong Wu、Wei Ji、Hao Fei、Liang Zheng、Roger Zimmermann、Jiebo Luo、Tat-Seng Chua。
📎扫码了解更多
无论你深耕视听理解,还是在生成式AI 的边界上探索,JAV-CG 都期待你的研究。相约里约,一起让AI 学会"边看边听"。