
 语音小管家
人类语音远不止文字内容——笑声、叹气、喘息、咳嗽等非言语发声(Nonverbal Vocalization, NVV)传递着情感态度与交互信息,是语音理解、富有表现力的语音生成和语音编辑的重要线索。然而,现有研究大多将NVV简单表示为转录文本中的离散标签(如 [Laughter]),虽然保留了类别信息,却无法反映这些声音事件在波形上的精确起止时间和持续时长。转录级标签与物理声学边界之间的鸿沟,长期制约着细粒度NVV时序定位的发展。
近期,西工大音频语音与语言处理研究组(ASLP@NPU)联合南京大学、上海玲光乍现科技有限公司完成的论文 "NVV-Locator: From Transcript Tags to Acoustic Boundaries for Fine-Grained Nonverbal Vocalization Grounding" 被NCMMSC 2026录用。论文针对非言语发声的细粒度时序定位问题,构建了统一的26类副语言分类体系和四阶段自动数据构建流水线,引入基于非自回归slot-filling架构的NVV-Locator模型,实现NVV类别识别与声学边界定位的联合预测。
论文题目: NVV-Locator: From Transcript Tags to Acoustic Boundaries for Fine-Grained Nonverbal Vocalization Grounding
作者列表: 曹雨昂, 穆秉甡, 林振楠, 李国健, 詹皓粤, 刘杰, 谢川, 张强, 薛浏蒙, 谢磊
合作单位: 南京大学、上海玲光乍现科技有限公司
论文预印版:https://arxiv.org/pdf/2609.09940
Demo页面:https://nvv-locator.github.io/Demo-Page/
背景动机
早期非言语发声(NVV)研究主要关注片段级或话语级的声学事件分类,如ESC-50[1]和VocalSound,仅能判断音频中是否存在某类NVV,无法定位其精确时间位置。近期工作开始收集合成或人工标注的NVV语料(如NonverbalTTS、SynParaSpeech、MNV-17[2]等),但这些资源在类别数量、标注粒度和声学自然度上参差不齐,且多以转录级标注为主。
已有的benchmark也进一步推动了NVV生成与转录级理解的发展:NVV-SuperBench[3]评测可控NVV生成,NV-Bench[4]评估生成语音中NVV的转录级位置。然而,这些工作仍将NVV视为转录文本中的离散语义标签,仅标注其"出现在哪个词旁边",并未显式建模其在波形上的起始时刻、偏移量或持续时长。
细粒度波形级NVV定位面临三重挑战:
- 传统forced alignment难以扩展: 基于Kaldi的蒙特利尔强制对齐工具(MFA)[5]能给出精确的词级边界,但依赖发音词典,难以扩展到词典外的NVV类别。NeMo和WhisperX等神经对齐系统虽降低了对词典的依赖,但主要面向词汇语音设计,在NVV事件上表现不佳。
- 自回归时间戳生成存在时间不一致: 近期语音大模型(Speech-LM)虽已探索时间戳预测,但自回归式的逐token生成会沿输出序列传播误差,在长序列上产生时间累积偏差。LLM-ForcedAligner[6]通过全局条件并行预测来缓解这一问题,但其设计初衷是联合词汇与NVV的时间定位。
- 高精度边界标注稀缺: NVV的声学边界标注昂贵且难以大规模获取,现有转录级标注无法直接用于波形级grounding的监督。
NVV-Locator的核心思路是:先建统一分类体系和大规模带精确时间戳的训练数据,再用非自回归架构一次性预测所有时间边界,从数据和模型两个层面同时解决"标注从哪来"和"边界怎么准"的问题。同时,本文还构建了人工椒盐与精修的 NVV-TimeBench 基准,为细粒度 NVV 时序定位提供统一的评测标准。
方法概览
统一的26类NVV分类体系
现有NVV资源在类别命名、标注粒度和声学相似事件划分上差异显著——声学上相似的事件可能因表层音素形式不同而被打上不同标签,而功能相近的感叹词又可能因语调差异被拆分为多个类别。这种不一致阻碍了数据聚合和跨语料泛化。
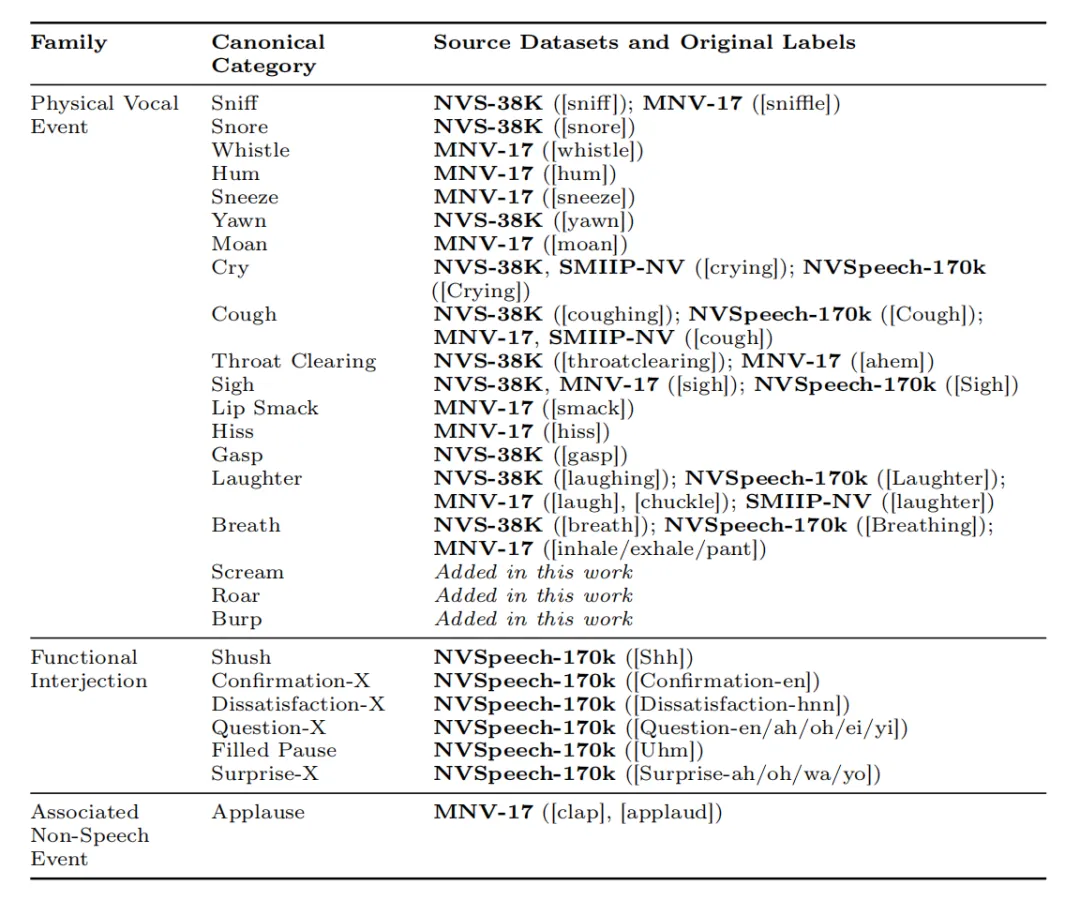
我们协调了NVSpeech-170k、MNV-17[2]、NVS-38K和SMIIP-NV四个公开资源,构建了统一的26类NVV分类体系,遵循两条原则:
- 物理事件的声学归一化: 将声学可识别或生理同源的标签合并为统一类别。例如,[Throat Clearing]整合了NVS-38K的[throatclearing]和MNV-17的[ahem];[Sniff]合并了[sniff]和[sniffl];[Laughter]、[Cough]、[Sigh]、[Breath]等跨数据集出现的事件也被对齐为标准类别。
- 词汇化感叹词的功能抽象: 将仅表层语音实现不同但语用功能一致的感叹词合并。例如NVSpeech-170k中分别标注的[Surprise-ah]、[Surprise-oh]、[Surprise-wa]、[Surprise-yay]统一映射为[Surprise-X];[Confirmation-en]和[Confirmation-han]统一映射为[Confirmation-X]。这种做法减少了音素变体导致的数据稀疏,鼓励功能一致的表示。
此外,分类体系还新增了[Scream]、[Roar]和[Burp]三个类别以拓展覆盖范围。最终我们的NVV分类体系如表1所示。
表1 统一26类NVV分类体系及各来源数据集映射
四阶段自动数据构建流水线
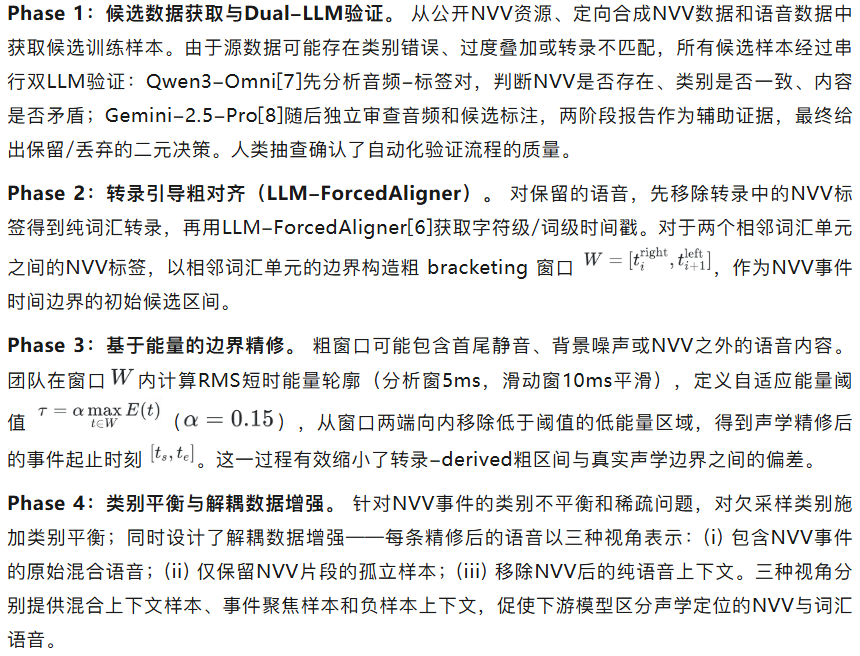
为获取大规模带精确时间戳监督的NVV训练数据,如图1所示,研究团队设计了四阶段自动化数据构建流水线。
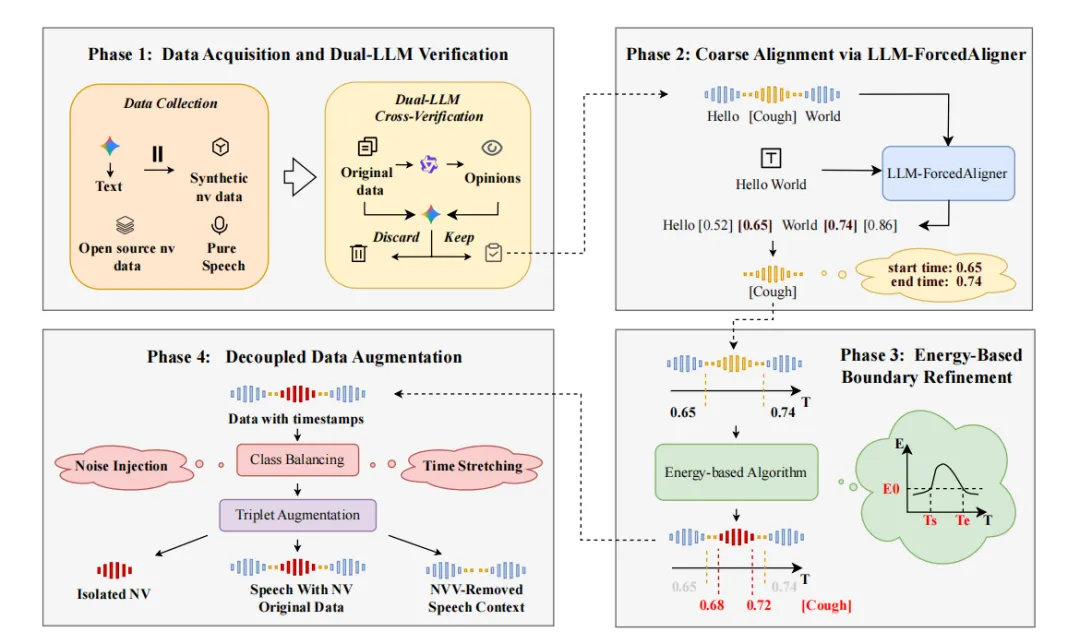
图1 四阶段自动数据构建流水线总览
NVV-Locator:非自回归Slot-Filling模型
如图2所示,NVV-Locator基于Qwen3-ASR-0.6B[7]构建,包含预训练音频编码器和0.6B参数语言模型解码器。模型将连续时间定位重新表述为转录对齐序列上的结构化slot填充任务:在每个文本单元后插入五个slot模板,分别编码起始时刻、结束时刻、NVV类型、事件起始偏移和事件结束偏移。
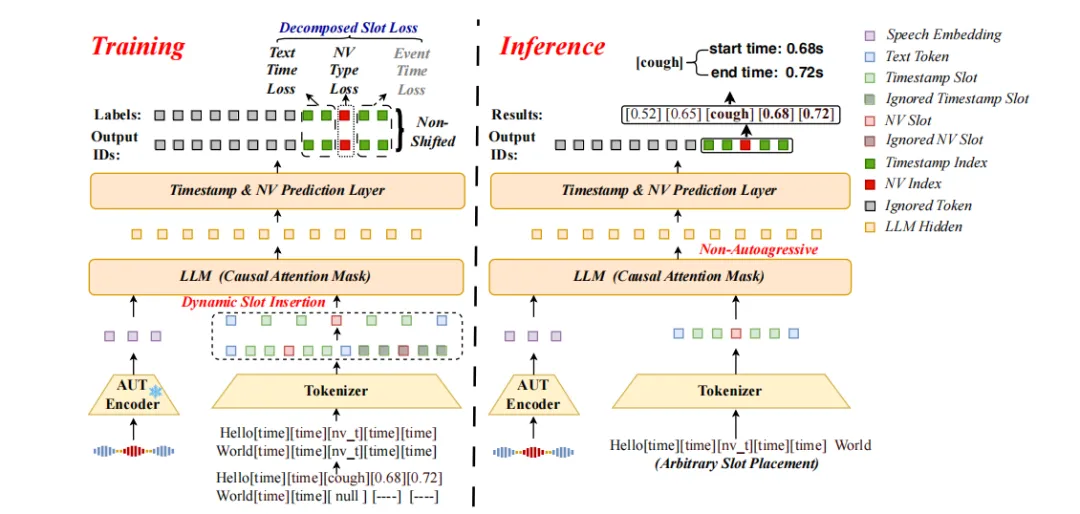
图2 NVV-Locator模型架构
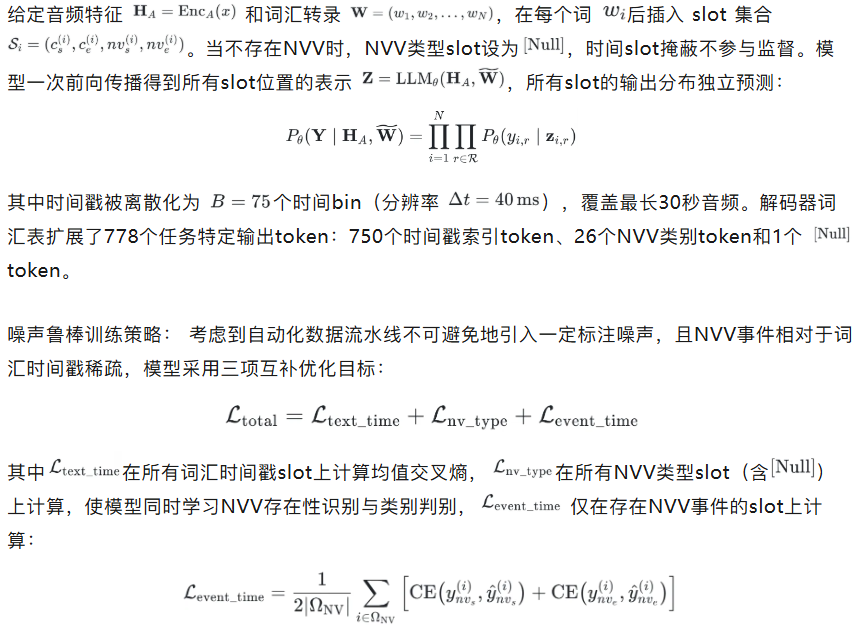
条件掩蔽(conditional masking)使梯度仅来源于声学上真实的NVV事件,避免模型在不存在NVV的位置学到任意时间戳。
事件级匈牙利匹配验证: Token级交叉熵不能直接衡量话语级的事件对应质量。团队在验证集上预留类别感知的匈牙利匹配成本做checkpoint选择:将预测和真实事件做二分图最优匹配,以事件级时间重叠IoU(t-IoU)≥ 0.5 为匹配标准,通过匹配对的Macro F1和边界平均绝对误差(MAE)选择模型,而非仅依赖token级精度。
实验设置
- 训练数据: 经前三阶段流水线获得283.20小时候选音频;其中7.49小时用于验证/评估(1.88小时经专家精修为benchmark,5.61小时用于开发验证),剩余275.71小时经Phase 4解耦增强后用于训练,最终训练集规模551.42小时。
- 评测基准:本文提出并构建的 NVV-TimeBench—— 专家精修的细粒度 NVV 时序定位基准,包含 667 条语音、1,094 个事件、约 112.6 分钟音频,覆盖全部 26 类 NVV,类别数从 22 到 159 不等,事件平均时长 0.52 秒、中位数 0.40 秒,标注者间边界差异小于 20ms。
- 对比系统: 四个代表性音频大模型(LAM)零样本评测:Gemini-2.5-Pro[8]、Qwen3-Omni[7]、Step-Audio、MOSS-Audio-Instruct,均提示其输出统一26类标签及起止时间。
- 评价指标: 事件级F1(t-IoU ≥ 0.5)为主指标;mIoU(%)和Macro mMAE(ms)衡量边界精度。同时报告Micro和Macro均值。
实验结果与分析
主实验结果
如表2所示,在NVV-TimeBench上,NVV-Locator在三项指标上均取得最优结果。
表2 NVV-TimeBench上的主实验结果
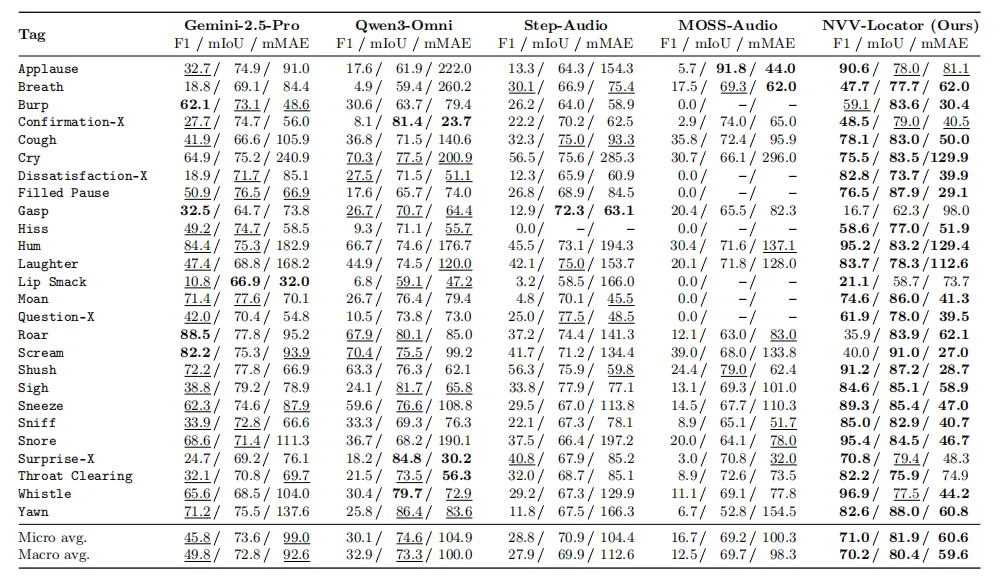
在LAM基线中,Gemini-2.5-Pro[8]取得最强综合表现(Macro F1 49.8%,mIoU 72.8%,mMAE 92.6ms),但仍远低于NVV-Locator。NVV-Locator达到Micro F1 71.0%、Macro F1 70.2%、Macro mIoU 80.4%和Macro mMAE 59.6ms,比最强基线分别提升25.2和20.4个百分点的F1、7.6个百分点的mIoU,边界误差降低33.0ms。这表明尽管通用LAM偶尔能给出个别NVV事件的大致位置,但在可靠识别和时序定位细粒度NVV事件方面仍存在明显局限。
分类别分析:声学特性决定定位难度
26个类别间性能差异显著,反映了声学显著性和边界模糊度的不同:
- 高精度类别: Whistle(96.9% F1,44.2ms mMAE)、Cough(78.1%,50.0ms)、Sneeze(89.3%,47.0ms)和Shush(91.2%,28.7ms)的事件级F1和边界精度均较高。这些事件声学转变突然、频谱特征独特(谐波或宽带谱峰),为事件识别和起止估计提供了清晰线索。
- 中等等级: Laughter(83.7% F1,112.6ms mMAE)和Hum(91.2% F1,129.4ms mMAE)表现出周期性重复事件的典型特征——事件识别较好但边界误差较大。其周期性逐渐变化的声学结构使精确起止时刻难以界定。Applause(90.6% F1,81.1ms mMAE)和Yawn(82.6%,60.8ms)也呈现类似模式。
- 高难度类别: 简短、低能量、语音邻近的事件更具挑战性。Lip Smack(21.1% F1)是典型的超短暂瞬态事件,常短于50ms,易被混响或背景噪声掩蔽。Gasp(16.7%)和Breath(47.7%)缺乏清晰的谐波结构,与本地噪声区分度低;呼吸事件常出现在词边界附近,可能与相邻语音或构音准备融合,增加了起止歧义。相比之下,Sniff达到85.0% F1和40.7ms mMAE,其独特的频谱轮廓提供了稳定的判别线索。
消融实验:各阶段数据流水线缺一不可
为量化各阶段流水线组件的贡献,团队在保持模型架构和训练协议不变的前提下,逐一移除各阶段进行消融,结果如表3所示。
表3 各阶段数据构建流水线消融实验
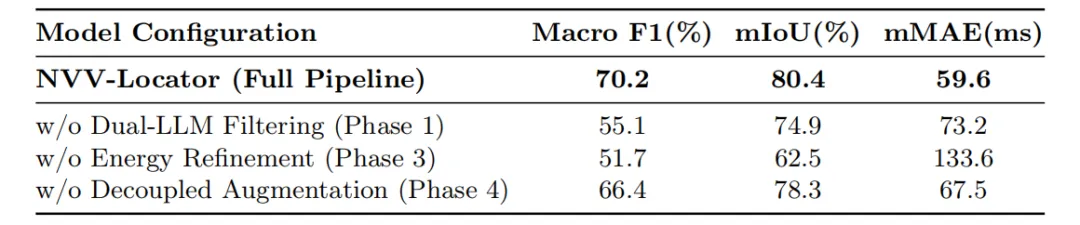
- 移除Dual-LLM验证(Phase 1): Macro F1从70.2%降至55.1%,mMAE从59.6ms升至73.2ms。未经质量控制的样本包含错误标签、背景干扰、重叠语音或声学模糊的NVV,会引入虚假的声学-标签关联,同时削弱类别判别和边界学习。
- 移除能量边界精修(Phase 3): mMAE从59.6ms恶化至133.6ms,mIoU从80.4%降至62.5%,Macro F1降至51.7%。转录引导窗口可能包含静音、背景噪声或语音邻近内容,导致事件起止被高估,提供不精确的监督。能量精修对于将粗转录区间转化为声学对齐的NVV边界至关重要。
- 移除解耦数据增强(Phase 4): Macro F1降至66.4%,mMAE升至67.5ms。三种训练视角(原始混合语音、孤立NVV片段、去除NVV的上下文)为欠采样类别提供了互补的声学多样性,帮助模型区分真实NVV与词汇语音及语音邻接的声学变异。
跨语料泛化能力
团队进一步在WESR-Bench[9]上评测NVV-Locator的跨语料迁移能力。WESR-Bench包含约900条话语和多样的NVV事件。将标签映射到统一26类体系后,NVV-Locator以零样本方式(无语料特定微调)评测,取得Micro F1 70.2%、Macro F1 45.7%。作为参考,原始WESR研究中训练后的系统取得Micro F1 70.5–71.4%、Macro F1 37.7–38.0%。尽管评测涉及不同的体系映射和语料,严格比较并不完全对等,但零样本结果表明NVV-Locator在NVV-TimeBench分布之外仍保持了有效的NVV事件识别能力。
总 结
NVV-Locator 针对非言语发声的细粒度时序定位问题,从分类体系、数据构建、评测基准和模型架构四个层面提出了系统化方案:
- 统一 26 类分类体系:整合四个现有资源构建统一分类体系,通过声学归一化和功能抽象解决类别碎片化问题,支持跨语料数据集成与细粒度时序定位;
- 四阶段自动数据构建流水线:Dual-LLM 验证、转录引导粗对齐、能量边界精修和解耦数据增强相结合,实现从转录标签到声学边界的可扩展自动标注;
- NVV-TimeBench 评测基准:专家精修的细粒度 NVV 时序定位基准,标注者间边界差异小于 20ms,为领域提供统一的评测标准;
- 非自回归 Slot-Filling 模型:基于 Qwen3-ASR-0.6B 构建,联合预测词汇时间戳、NVV 类别和事件起止边界,通过并行预测避免自回归时间戳的累积误差,在 NVV-TimeBench 上大幅超越音频大模型基线。
参考文献
[1] K. Piczak, "ESC: Dataset for Environmental Sound Classification," in Proc. ACM MM, 2015.
[2] J. Mai et al., "MNV-17: A High-Quality Performative Mandarin Dataset for Nonverbal Vocalization Recognition in Speech," in Proc. ICASSP, 2026.
[3] L. Xue et al., "NVV-SuperBench: Beyond Words, Beyond Quality—Benchmarking Nonverbal Vocalizations in Speech Generation," arXiv:2504.11150, 2025.
[4] Q. Ni et al., "NV-Bench: Benchmark of Nonverbal Vocalization Synthesis for Expressive Text-to-Speech Generation," arXiv:2603.15352, 2026.
[5] M. McAuliffe et al., "Montreal Forced Aligner: Trainable Text-Speech Alignment Using Kaldi," in Proc. Interspeech, 2017.
[6] B. Mu et al., "LLM-ForcedAligner: A Non-Autoregressive and Accurate LLM-Based Forced Aligner for Multilingual and Long-Form Speech," arXiv:2601.18220, 2026.
[7] X. Tian et al., "Qwen3-Audio Technical Report," arXiv:2601.21337, 2026.
[8] G. Comanici et al., "Gemini 2.5: Pushing the Frontier with Advanced Reasoning, Multimodality, Long Context, and Next Generation Agentic Capabilities," arXiv:2507.06261, 2025.
[9] C. Cheng et al., "WESR: Scaling and Evaluating Word-Event-Level Speech Recognition," in Proc. ACL, 2026.
