
 阿里语音AI
文章来源于阿里语音AI,作者达摩院语音实验室
作者:张庆林、陈谦、刘嘉庆、王雯、邓憧
▎研究背景
此外,缺乏结构化分割信息对于语音转写稿下游自然语言处理(NLP)任务的性能也有较大影响。比如文本摘要和机器阅读理解之类的下游 NLP 应用通常在带有段落分割、格式良好的文本上进行训练和使用才能保证较好的效果和用户体验。
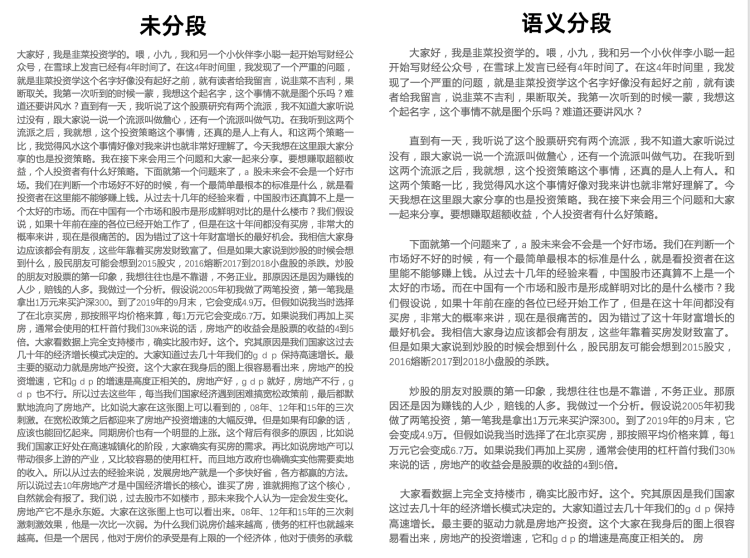
图一 未分段ASR输出文本和分段之后的结果展示
▎研究方法
No.1 基于句级序列标注的文本分割模型
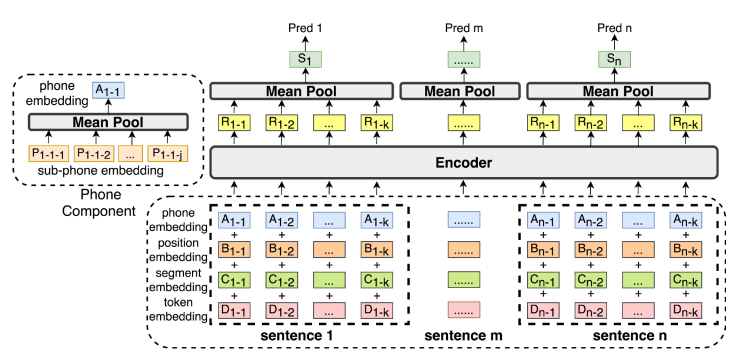
图二 SeqModel 模型结构
我们提出的 SeqModel 模型[2]将文档分割建模为句子级序列标记任务。该模型结构如图二所示。
首先对输入文档进行分句,每个句子通过分词器分词并添加一个特殊标记。分割后的字符序列通过输入表示获得字向量,并与位置向量和段向量进行元素求和获取最终的字符表征。紧接着,将该字符表征输入到 BERT 编码器,并将编码器输出的字符表征映射到每个句子,对应于每个句子的 k 个字符输出表征通过均值池化操作来获得最终的句子表征。最后,每个句子编码通过输出层以及 softmax 层映射,从而分类每个句子是否是段落边界。该模型的训练目标为最小化交叉熵损失。
相比 cross-segment 模型,我们的 SeqModel 可以同时处理更多句子,通过自注意力机制建模更长上下文和句子间的依赖关系。因此,在强依赖长文篇章信息的分段任务上,seqModel 建模更长文本的语义信息可以有效地提高分割精度。
此外,将分割任务建模为句级的长序列标注任务,可以同时对多个句子同时进行预测,有效提高了模型的推理速度,相比层次模型也有明显的效率优势。
No.2 基于自适应滑窗提升模型推理效率和性能
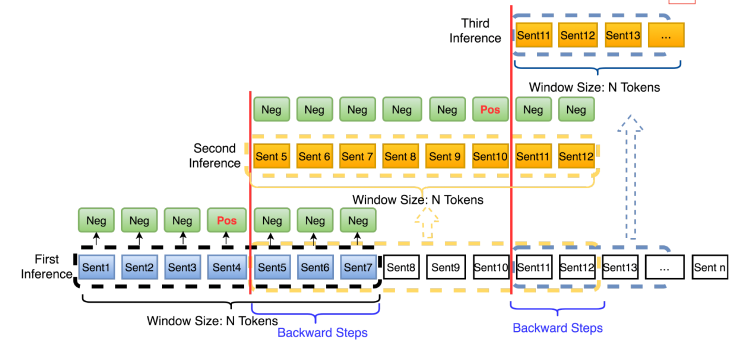
图三 自适应滑窗
为了进一步提升模型的推理效率和效果,我们还提出了一种自适应滑动窗口方法[2],该方法可以在不降低模型效果的基础上进一步加快推理速度,如图三所示。
以往的方法,在面对超过模型处理长度的超长文本输入时,通常用于使用固定步长的滑窗逻辑。然而固定步长的滑窗逻辑会极大地降低模型的推理效率,同时也会轻微影响模型的性能。
在我们提出的自适应滑动窗口方法中,模型前向推理时,从前一个窗口中的最后一句开始往前滑动,找到模型预测的分割点做为下一次模型预测推理的起始点(有最大步数约束)。
考虑到已有段落分割点的历史文本信息对下一个分割点预测的影响相对较小,这个策略有助于减少滑动窗口内不相关的文本信息对于分段点预测的影响。因此,自适应滑动窗口既可以加快推理速度,又可以提高分割精度。
No.3 结合发音信息的口语文本分割优化
在口语场景下,输入分割模型的文本通常是由 ASR 系统给出的转写稿。受限于 ASR 系统在某些场景下的识别效果问题,该转写稿经常存在较多的 ASR 错误,比如发音相似但含义不同的声学混淆词等。
为了提高存在 ASR 错误情况的文本分割性能,我们提出通过使用发音信息来增强文本分割模型输入的表征向量,从而提高文本分割模型在口语场景下的鲁棒性[2]。具体细节如图二中的输入嵌入层以及左侧放大的 “Phone Component“ 所示。
▎实验结果
No.1 实验数据和指标
我们主要使用三个数据集来验证我们方法的有效性,包括英文维基数据 (Wiki-727K)、中文维基数据 (Wiki-zh) 以及内部中文口语数据(包括多说话人口语数据 SD-zh-MP 和单说话人口语数据 SD-zh-SP)。
其中,由于学术界缺乏中文书面化文档段落分割的 benchmark, 我们参照英文维基段落分割数据集的构造方式,构造了中文维基段落分割数据集,并且公开发布[2]。
数据集的统计特性如表一所示,#S/doc 表示每篇文档的平均句子数。SLen 表示平均句长。#P/doc 表示每篇文档的平均段落数。#S/P表示每段的平均句子数。
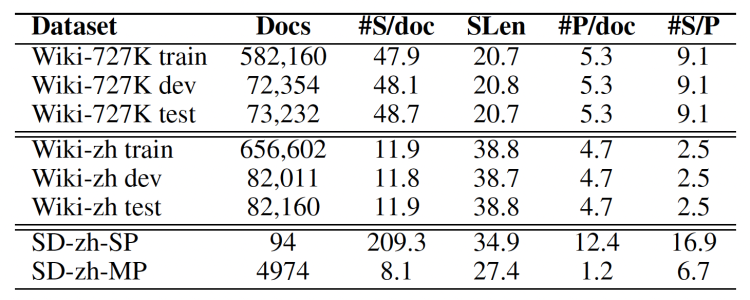
表一 实验数据的统计特性
我们选择 positive precision、positive recall、 positive F1作为客观评价指标。
No.2 实验结果和分析
如表二、表三所示,相比每个表格里面第一组的基线模型,SeqModel 模型在中英文数据上都有着明显性能优势。同样的模型参数下,SeqModel 在英文数据集上有 F1 绝对提升 4.2 的性能优势;在中文维基数据上有 F1 绝对提升 4.3 的性能优势。
口语数据下,SeqModel 相比 cross-segment 模型相比有着更明显的性能优势,在单人数据和多人数据下,F1 绝对提升分别有 8.8 和 10.1。
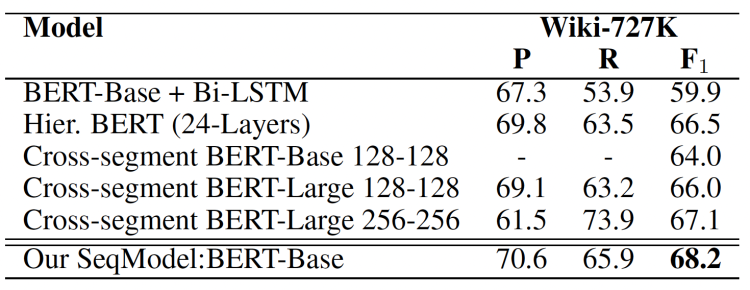
表二 英文数据实验结果(SeqModel:XX 表示使用XX作为SeqModel 的预训练模型)
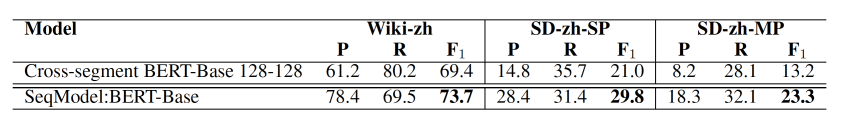
表三 中文数据实验结果一, SeqModel和Cross-segment 模型的性能对比
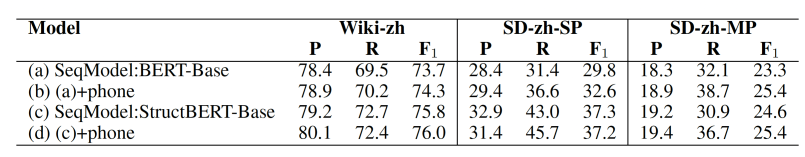
表四 中文数据实验结果二,发音信息对于文本分割性能的影响
自适应滑窗对文本分割模型性能的影响如图四所示。分割效果方面,如图四左图所示,固定滑窗的方法随着步数的增大,分割性能受到明显的负面影响;而自适应滑窗的方法由于可以减少已分割文本对未来预测的影响,性能随着步数的增大,反而有着轻微提升。
在运行效率方面,固定滑窗随着步数的增大,效率急剧下降,而自适应滑窗方法下,推理效率受到的影响很小。同时,相比 cross-segment 模型,结合自适应滑窗的 SeqModel 模型有着显著的效率优势(只需要不超过 cross-segment 模型1/6的运行耗时)。
此外,我们的中文模型还实验了融合中文词汇信息的 pooling 结构,将模型建模的粒度从字转变为词,降低序列中长度。该方法在模型效果基本无损下,可以进一步相对提升大约 30% 的运算效率。
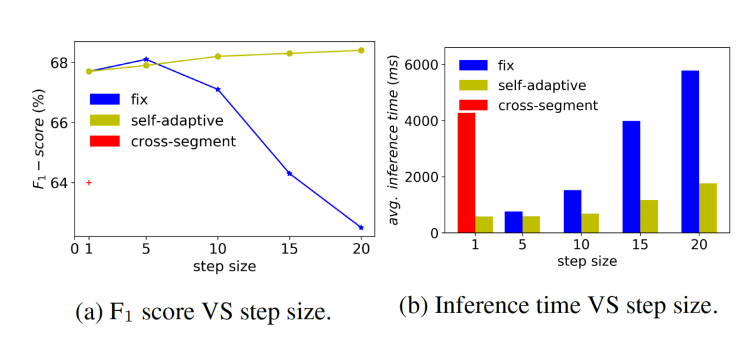
图四 固定滑窗和自适应滑窗的效果(左)和效率(右)对比
