 阿里语音AI
分享8篇通义实验室在 INTERSPEECH 2024 和 ACL 2024 中稿的论文,涵盖音频理解与生成、语音情感表示、语音合成、语音分离、说话人验证、自动语音识别等多个技术方向。
INTERSPEECH是国际语音通讯协会(ISCA)组织的年度会议,为全球语音处理和通讯领域最重要的会议之一。ACL是自然语言处理领域的旗舰会议之一,致力于促进计算语言学及其相关领域的研究。
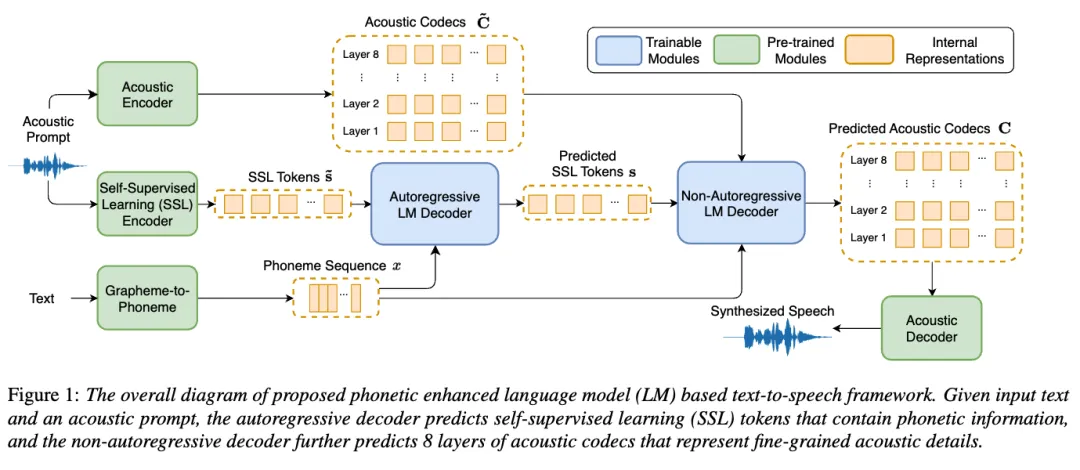
Phonetic Enhanced Language Modeling for Text-to-Speech Synthesis
论文作者:Kun Zhou, Shengkui Zhao, Yukun Ma, Chong Zhang, Hao Wang, Dianwen Ng, Chongjia Ni, Nguyen Trung Hieu, Jia Qi Yip, Bin Ma
ERes2NetV2: Boosting Short-Duration Speaker Verification Performance with Computational Efficiency
论文作者:Yafeng Chen, Siqi Zheng, Hui Wang, Luyao Cheng, Qian Chen, Shiliang Zhang, Junjie Li
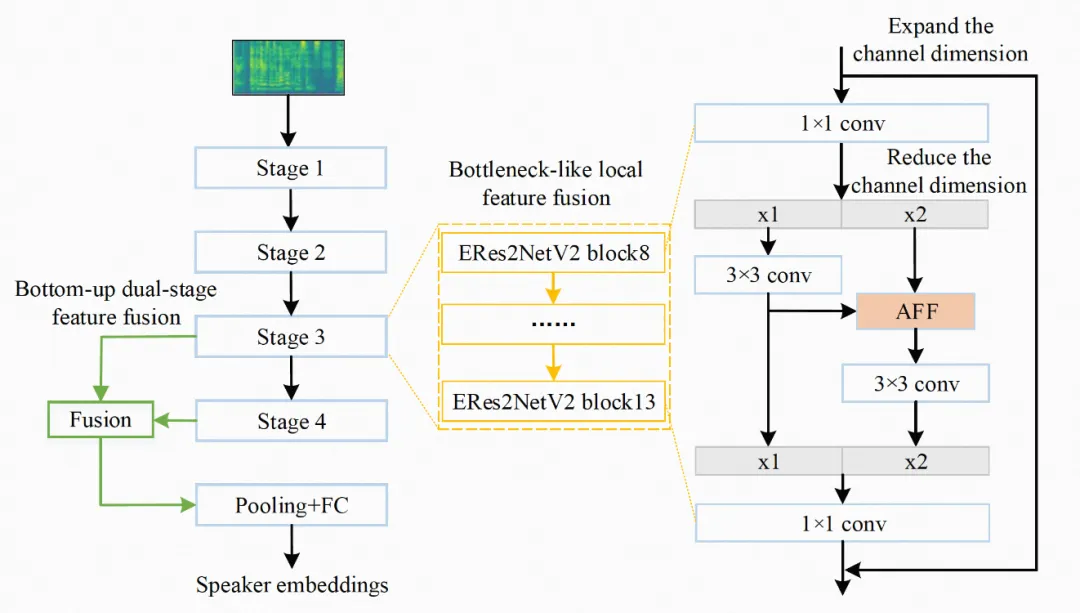
源代码:https://github.com/modelscope/3D-Speaker
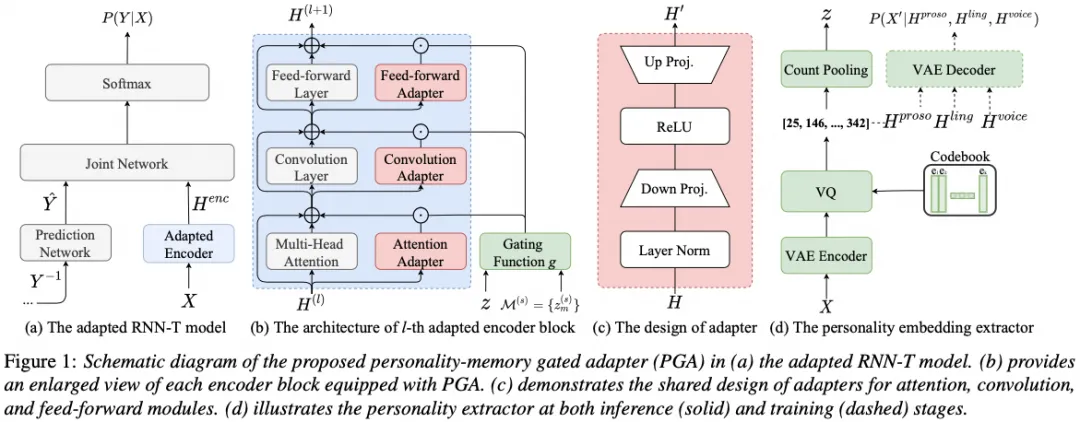
Personality-memory Gated Adaptation: An Efficient Speaker Adaptation for Personalized End-to-end Automatic Speech Recognition
论文作者:Yue Gu, Zhihao Du, Shiliang Zhang, Jiqing Han, Yongjun He
CodeScope: An Execution-based Multilingual Multitask Multidimensional Benchmark for Evaluating LLMs on Code Understanding and Generation
为了弥补现有基准与实际应用期望之间的差距,我们引入了CodeScope,这是一个基于执行、支持多语言、多任务、多维度的评估基准,用于综合评估LLMs的编码任务能力。CodeScope覆盖43种编程语言和八种编码任务,从长度、难度和效率三个维度评估LLMs的编码性能。为了简化基于执行的代码生成评估,我们开发了MultiCodeEngine,这是一种支持14种编程语言的自动化代码执行引擎。最后,我们系统地评估和分析了八个主流LLMs,并展示了CodeScope在评估LLMs代码理解和生成任务方面的广度和挑战性优于其他基准测试。
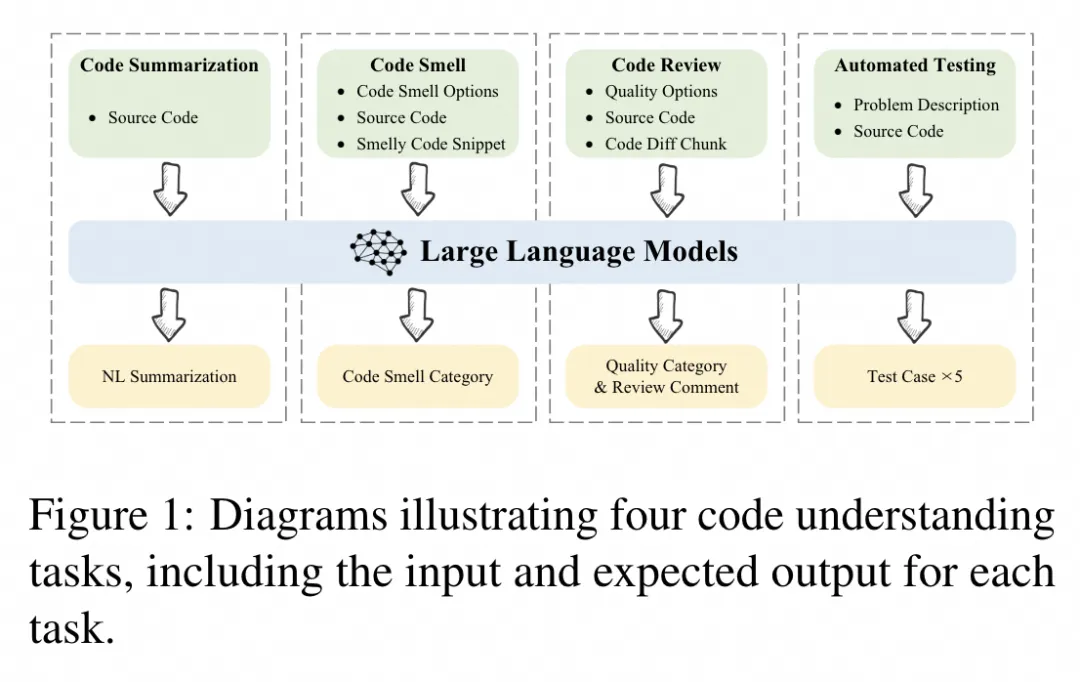
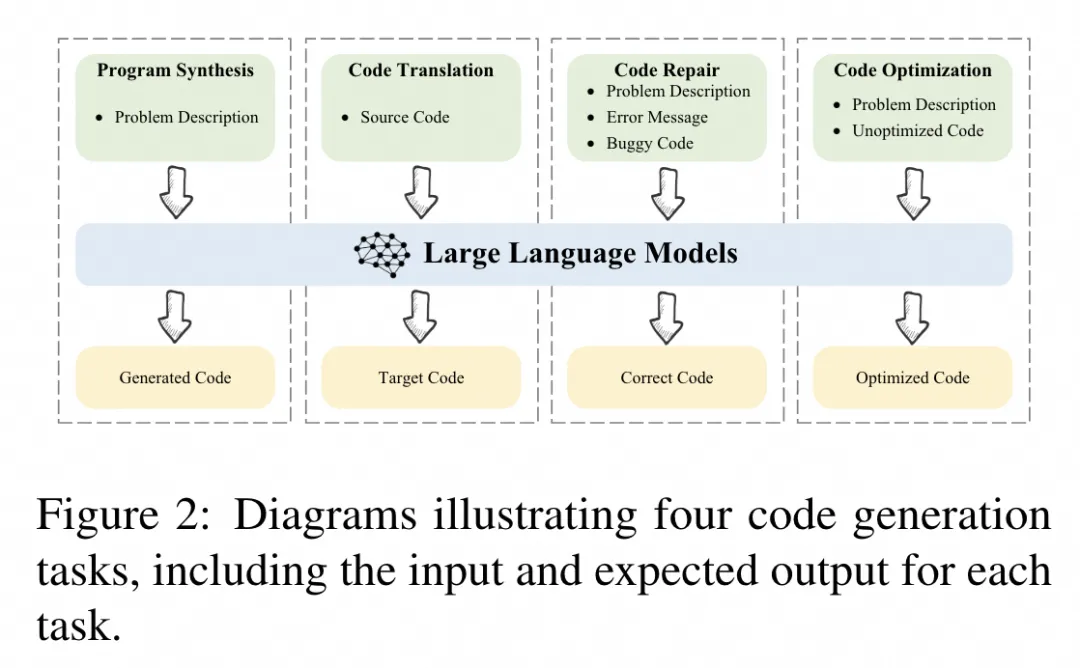
项目开源地址:https://github.com/WeixiangYAN/CodeScope
Towards Audio Codec-based Speech Separation
核心内容:近期,神经音频编解码器(NAC)模型的进展引发了人们对于采用预训练编解码器的浓厚兴趣,这主要用于各类语音处理应用,目的是借助高压缩比带来的效率提升。然而,这些技术尚未被应用于语音分离(SS)任务。由于传统的SS模型需要大量计算资源,这在许多边缘计算场景中显得不实际,因此SS能从高压缩中受益。但SS任务涉及波形掩码,压缩过程中容易引入失真,这会严重影响性能。针对这一问题,我们提出了一个新颖的基于音频编解码的SS任务模型,即在NAC的嵌入空间内进行SS,并开发了一个名为Codecformer的新模型来执行此任务。在推断阶段,Codecformer实现了高达52倍的MAC减少,同时提供的分离性能与云部署的Sepformer相当,为实际应用中高效进行SS提供了新的方向。
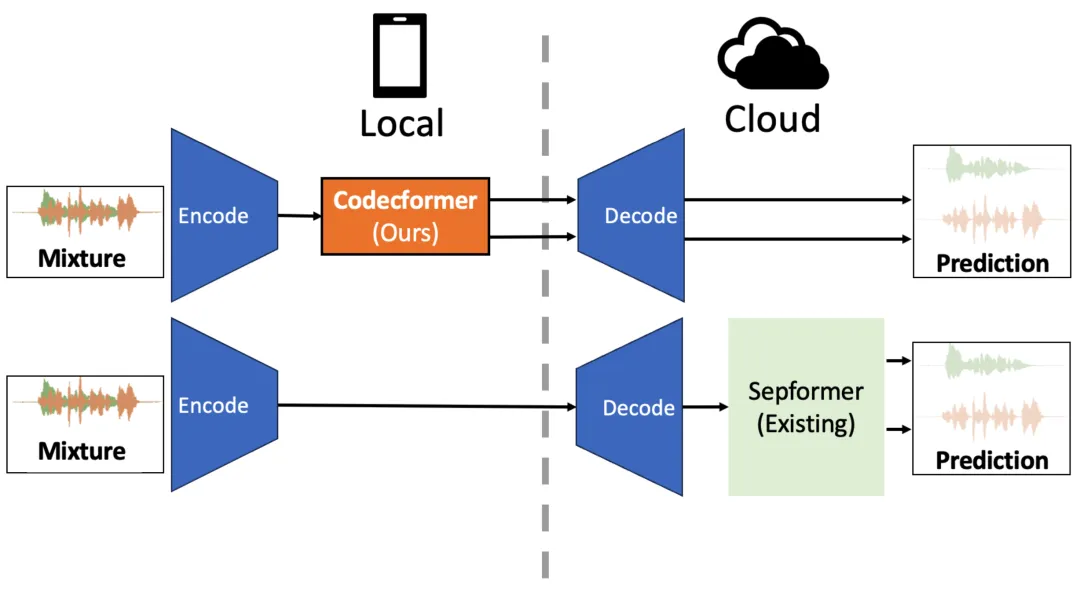
论文单位:上海交通大学,阿里巴巴集团
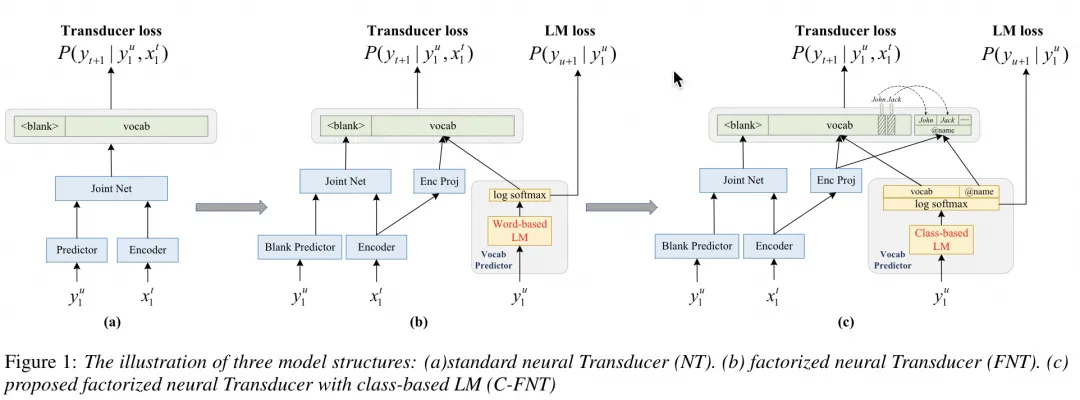
核心内容:尽管端到端 (E2E) 模型在语音识别方面取得了显著进展,命名实体识别 (NER) 依然是一个具有挑战性却对语义理解至关重要的问题。以往的研究主要集中在各种基于规则或基于注意力的上下文偏置算法。然而,这些算法的性能可能会对偏置权重敏感,或者由于过度关注命名实体列表而下降,并且存在误触发的风险。受到传统混合系统中基于类别的语言模型 (LM) 在命名实体识别中取得的成功以及因子化神经 Transducer (FNT) 在有效解耦声学和语言信息方面的启发,我们提出了一种新的端到端模型C-FNT,它将基于类别的语言模型融入 FNT。在 C-FNT 中,命名实体的语言模型得分可以与类别名称相关联,而不是其表面形式。实验结果表明,我们提出的 C-FNT 显著减少了命名实体识别中的错误,同时不损害一般词汇识别的性能。
MaLa-ASR: Multimedia-Assisted LLM-Based ASR
论文单位:上海交通大学,阿里巴巴集团
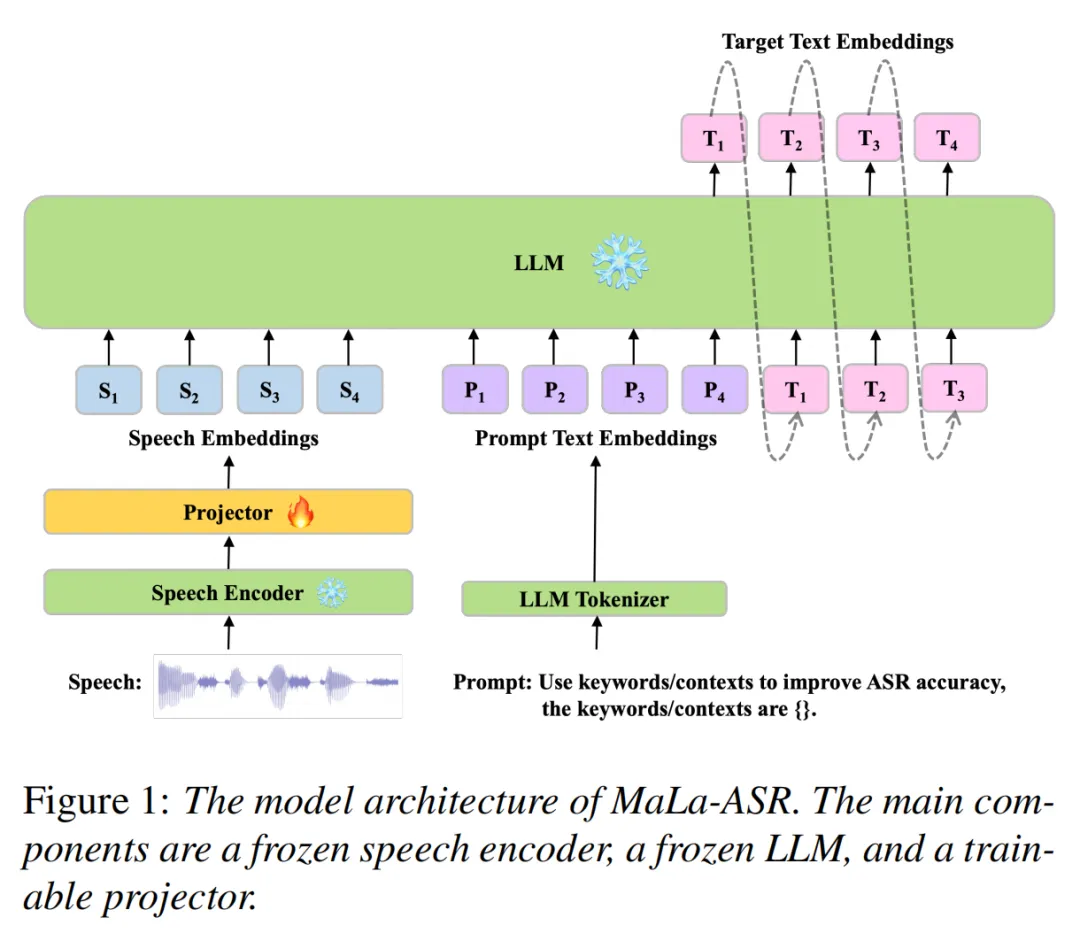
核心内容:随着视频等信息丰富的数据越来越多,利用多模态辅助信息来增强音频任务引发了广泛的研究兴趣。最近,基于 LLM 的音频模型的研究热潮为解决音频任务提供了新的视角。鉴于 LLM 可以灵活地接收多种输入,我们提出了MaLa-ASR,这是一种基于 LLM 的 ASR 模型,可以整合从演示幻灯片中提取的文本关键词,从而提高会议内容的识别准确率。在 SlideSpeech 语料库的 L95 和 S95 子集中,MaLa-ASR 的平均词错误率分别为 9.4% 和 11.7%,与 SlideSpeech 中报告的基线模型相比,词错误率分别大幅下降了 27.9% 和 44.7%。MaLa-ASR 展现了 LLM 在语音任务中的强大性能以及方便整合辅助信息的能力。通过在输入提示中添加关键词,偏置词错误率(B-WER)相对降低了 46.0% 和 44.2%,在该数据集上建立了新的 SOTA。
源代码:https://github.com/X-LANCE/SLAM-LLM/tree/main/examples/mala_asr_slidespeech
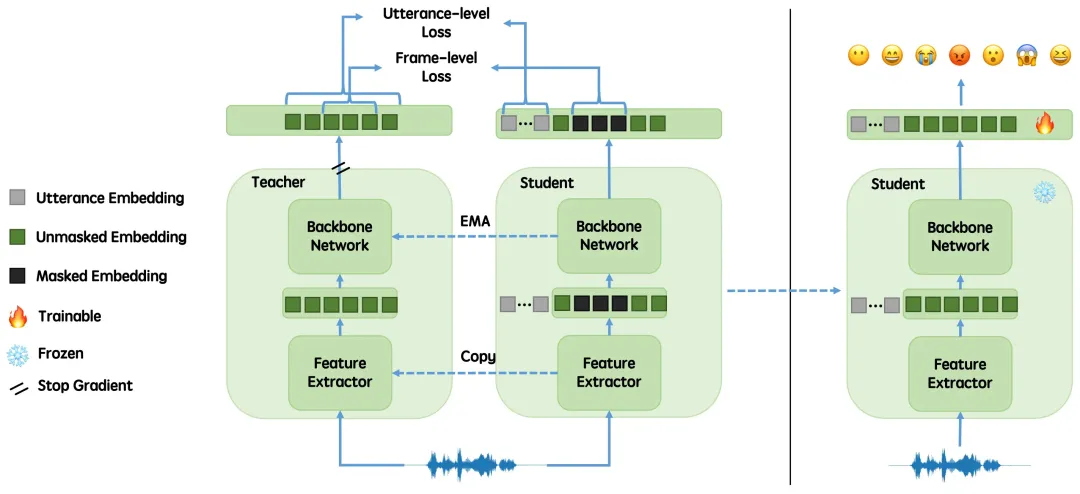
emotion2vec: Self-Supervised Pre-Training for Speech Emotion Representation
论文作者:Ziyang Ma, Zhisheng Zheng, Jiaxin Ye, Jinchao Li, Zhifu Gao, ShiLiang Zhang, Xie Chen