文章来源于阿里语音AI,作者通义语音团队
近日,ICASSP 2024公布了本届论文审稿结果,通义实验室语音团队共有11篇论文被大会收录,涵盖多模态语音识别、热词定制、语音分离、情感识别、情感渲染等多个技术方向。
01 论文题目:Loss Masking Is Not Needed in Decoder-only Transformer for Discrete-token Based ASR
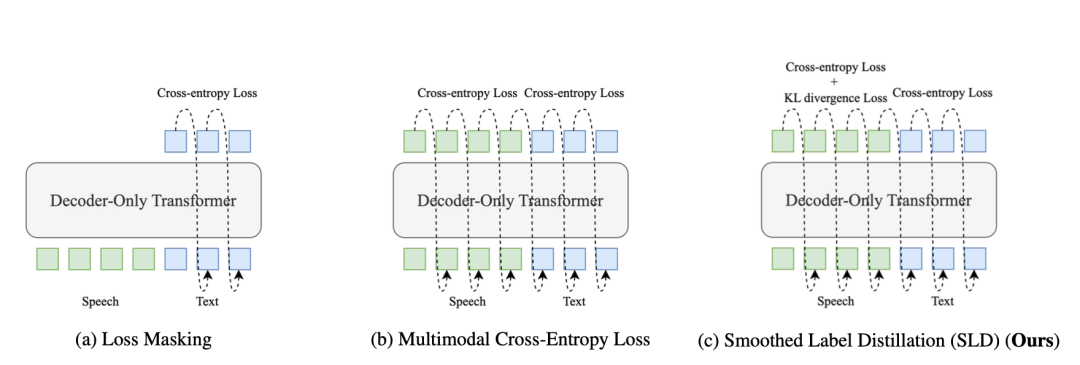
论文作者:陈谦,王雯,张庆林,郑斯奇,张仕良,邓憧,马煜坤,于海,刘嘉庆,张冲核心内容:近期,SpeechGPT、VioLA和AudioPaLM等统一语音文本模型在语音任务上取得了显著的性能。这些模型将连续的语音信号转换为离散的标记(语音离散化),并将文本和语音标记合并到一个共享词汇中。然后,它们在混合语音任务上训练一个仅有解码器的Transformer模型。具体来说,所有这些模型在ASR任务中使用“损失屏蔽”(Loss Masking)对输入的语音标记进行处理,这意味着这些模型并未明确地对语音标记之间的依赖关系进行建模。在本文中,我们尝试以与文本类似的自回归方式对语音标记的序列进行建模。然而,我们发现将传统的交叉熵损失应用于输入的语音标记并不能一致地改善ASR性能,相较于Loss Masking。因此,我们提出了一种新的方法,称为“平滑标签蒸馏”(Smoothed Label Distillation,SLD),它在输入的语音标记上引入了带有平滑标签的KL散度损失,以有效地对语音标记进行建模。实验证明,我们的SLD方法缓解了交叉熵损失的限制,并在使用不同的语音离散化方法的基于仅有解码器的Transformer的ASR系统中一致地优于Loss Masking。总得来说,我们的研究结果强调了在改善ASR性能方面明确建模语音标记之间的依赖关系的重要性。提出的SLD方法通过引入带有平滑标签的KL散度损失有效地对语音标记进行建模,提供了一种有前景的解决方案。论文预印版下载地址:https://arxiv.org/abs/2311.04534项目开源地址:https://github.com/alibaba-damo-academy/SpokenNLP/tree/main/sld
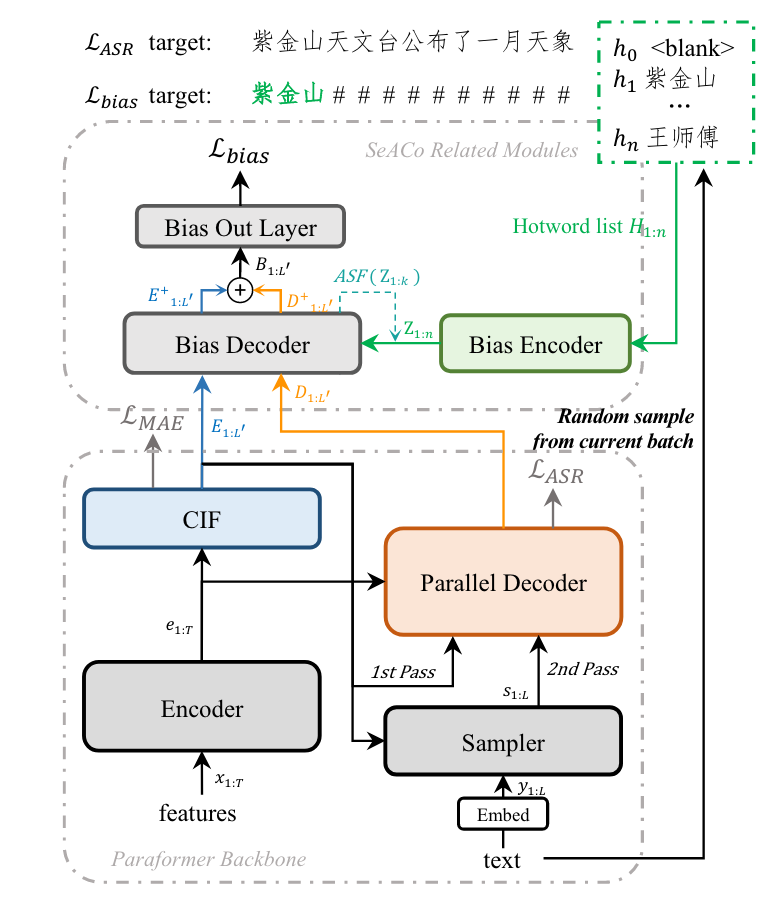
02 论文题目:SeACo-Paraformer: A Non-Autoregressive ASR System with Flexible and Effective Hotword Customization Ability
论文作者:石宪,杨叶新,李泽瑞,陈艳妮,高志付,张仕良核心内容:热词定制化 (Hotword Customization)是语音识别模型的重要功能之一,允许用户通过配置热词的方式强化专有名词、人名地名、业务术语等原本可能识别较差的词汇能够极大的提升用户的体验。目前在端到端语音识别模型侧进行热词定制化功能的训练方法主要分为两种:显式热词激励与隐式热词激励,但是现有方法在训练有效性、热词激励效果与模型可解释性上均有改进的空间。本文提出一种与ASR主体模型解耦的热词定制化方案,基于Paraformer这一非自回归基础模型,我们引入了基于多头注意力机制的热词decoder用于热词的激励,在解码的过程中通过热词检测与概率融合实现力度可控的热词激励。经过实验,本文提出的模型在热词召回效果较基线模型有显著提升。针对热词decoder的建模特性,我们通过引入基于attention score的热词筛选策略进一步提高了热词激励的效果。此外,为了方便研究者体验模型效果,对比方案优劣,我们提供以下三种开源服务:(1)在Modelscope上开源了基线Paraformer模型、基线Contextual-Paraformer模型以及本文提出的SeACo-Paraformer模型;(2)在FunASR工具包中开源了上述模型的源代码;(3)在本论文的Github repo中开源了两个基于Aishell-1构建的热词测试集。(图示:SeACo-Paraformer的模型结构与训练)论文预印版下载地址:https://arxiv.org/pdf/2308.03266项目开源地址:https://github.com/R1ckShi/SeACo-Paraformer
FunASR开源工具包地址:https://github.com/alibaba-damo-academy/FunASR
03 论文题目:FunCodec: A Fundamental, Reproducible and Integrable Open-source Toolkit For Neural Speech Codec
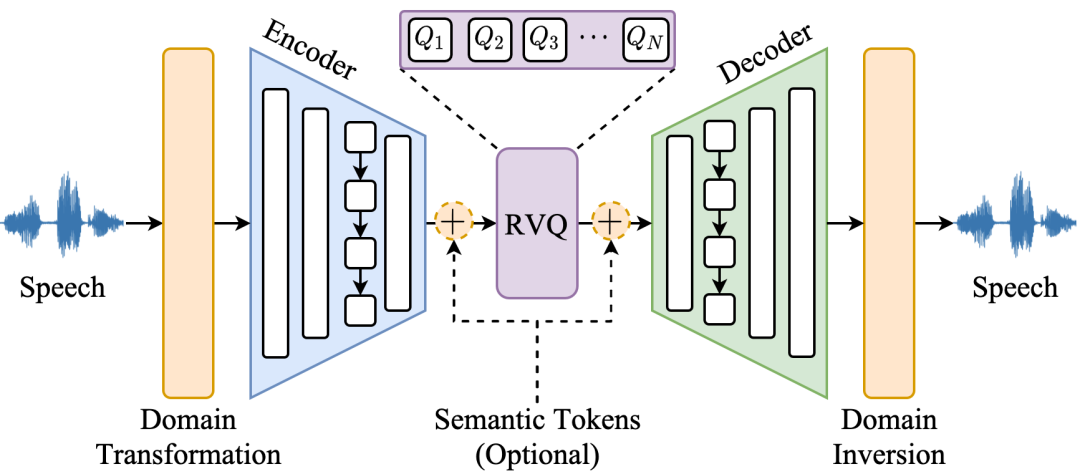
核心内容:语音量化(Speech Codec)的目的是将语音信号编码为一个个离散的token,在语音通信和存储领域具有广泛的应用场景。近些年,得益于深度神经网络的快速发展,研究者们提出了基于神经编解码的语音量化模型。与基于专家知识的传统语音量化方法相比,基于神经网络的模型在更低的码率下获得了更高的语音质量。与此同时,语音的量化编码也使大规模语言模型LLM具备了统一建模语音和文本的能力,例如VALL-E语音合成模型、VioLA、AudioPALM等语音-文本理解模型等。在此背景下,我们开源了 FunCodec 语音量化编码工具包,它提供了SoundStream、Encodec等SOTA模型的开源实现,以及我们在标准学术数据和内部大规模数据上的预训练模型,希望以此加速该领域的相关研究。此外,考虑到语音在时频域上的结构性,我们进一步提出了时频域的量化模型,它能够在保证量化语音质量的基础上,只需更少的参数和计算量。为了探究声学-语义解耦对语音量化带来的影响,我们提出了语义增强的residual vector quantizer 模块,在极低比特率下展现了较高的语音质量。以上所有模型都已在ModelScope和Huggingface开源。与语音量化模型一同,近期还会在FunCodec中发布LauraGPT、VALL-E、SpearTTS等基于离散token的语音合成模型。
(图示:FunCodec 模型结构)
论文预印版下载地址:https://arxiv.org/abs/2309.07405v2FunCodec开源代码:https://github.com/alibaba-damo-academy/FunCodec
FunCodec开源模型:https://www.modelscope.cn/models?page=1&tasks=audio-codec&type=audio
04 论文题目:Hourglass-AVSR: Down-up Sampling-based Computational EfficiencyModel For Audio-visual Speech Recognition
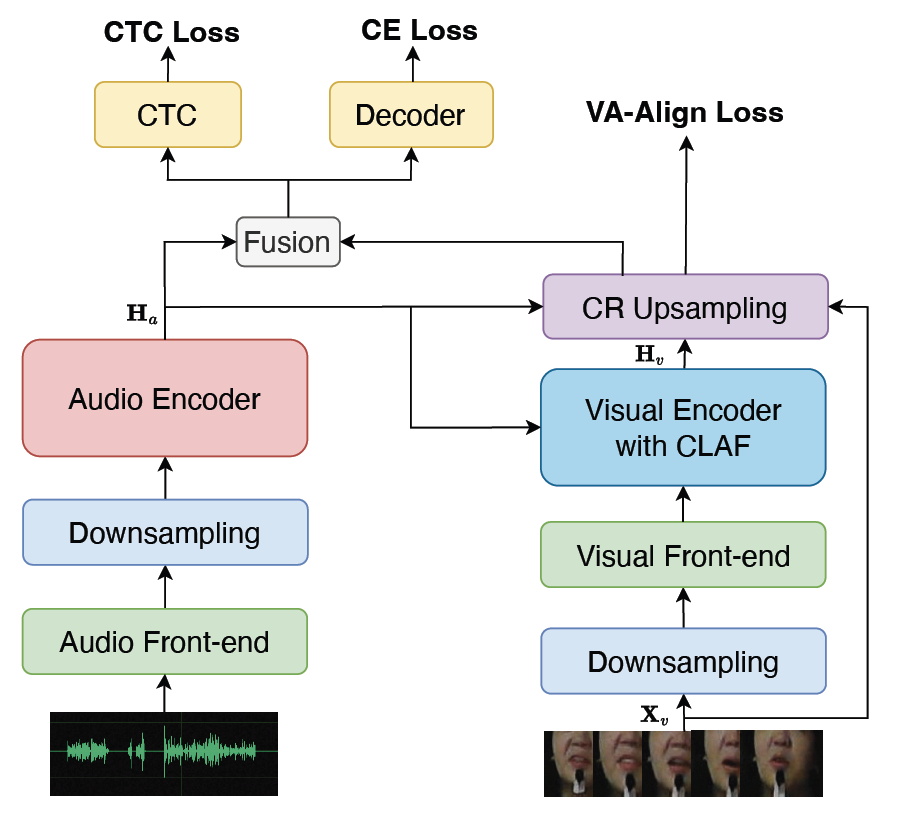
核心内容:近年来,音频-视觉语音识别(Audio-Visual Speech Recognition,AVSR)在复杂的声学环境下展现出了卓越的识别性能。AVSR能够高效地利用视频模态作为附加信息来提升语音识别(Automatic Speech Recognition, ASR)的识别效果。然而,如何去降低视觉模块的计算量和提升音频-视觉跨模态的融合效果是AVSR领域中的两个亟待解决的问题。为了解决这两个问题,我们提出了一种基于下采样-上采样的AVSR模型,以同时获得高性能和高效率。在视频编码器的编码过程中,视频序列时间长度先缩小再放大,形似一个时间沙漏,因此我们称提出的这个ASVR模型为Hourglass-AVSR。具体来说,首先我们提出了一种上下文和残差感知的视频上采样方法,通过利用视觉表示中的上下文信息和捕捉相邻视频帧之间的残差信息来改善识别性能。其次,在上采样过程中,我们引入了一种视觉-音频对齐方法,通过显式地引入边界约束损失函数来实现两个模态在时间维度的对齐。此外,我们还提出了一种跨层注意力融合机制,以捕捉每个视觉编码器层内的跨模态依赖关系。在音视频多模态数据上的实验证明,我们提出的Hourglass-AVSR模型在远场和中场的场景均能够提升ASR的识别性能。并且受益于我们的下采样-上采样方法,我们模型的计算量也得到了明显的改善。论文预印版下载地址:https://arxiv.org/abs/2312.0885005 论文题目:LCB-net: Long-Context Biasing for Audio-Visual Speech Recognition
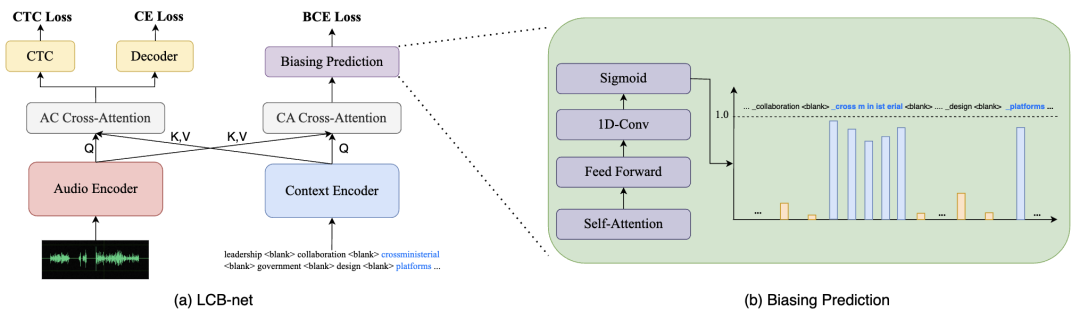
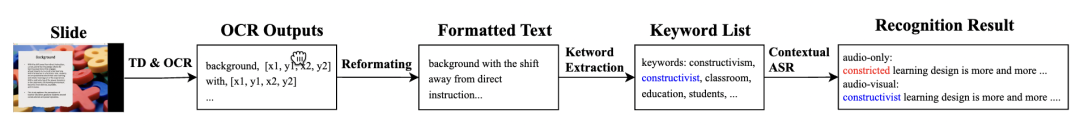
核心内容:随着在线会议和课程越来越普遍,如何利用视频幻灯片中丰富的文本信息来改善语音识别(Automatic Speech Recognition, ASR)面临着新的挑战。视频中的幻灯片与语音实时同步,相比于统一的稀有词列表,能够提供更长的上下文相关信息。因此,我们提出了一种创新的长上下文偏置网络(LCB-net),用于音频-视觉语音识别(Audio-Visual Speech Recognition,AVSR),以更好地利用视频中的长时上下文信息。具体来说,我们首先使用OCR技术来检测和识别幻灯片中的文本内容,其次我们采用关键词提取技术来获取文本内容中的关键词短语。最后,我们将关键词拼接成长上下文文本和音频同时输入到我们的LCB-net模型中进行识别。而LCB-net模型采用了双编码器结构,同时建模音频和长上下文文本信息。此外,我们还引入了一个显式的偏置词预测模块,通过使用二元交叉熵(BCE)损失函数显式预测长上下文文本中在音频中出现的关键偏置词。此外,为增强LCB-net的泛化能力和稳健性,我们还采用了动态的关键词模拟策略。实验证明,我们提出的LCB-net热词模型,不仅能够提升关键词的识别效果,同时也能够提升非关键词的识别效果。06 论文题目:Are Soft Prompts Good Zero-shot Learners for Speech Recognition?
论文作者:黄殿文,张冲,张芮熙,马玉坤,Fabian Ritter-Gutierrez,Trung Hieu Nguyen,倪崇嘉,赵胜奎,庄永祥,马斌核心内容:大型自监督预训练语音模型在学习下游任务时需要消耗大量计算资源进行模型微调。软提示调整提供了一种简单且参数量高效的替代方法。通过冻结整个预训练模型,使用少量可学习矢量化的软提示来引导模型和优化预测头部,可以提高模型的可移植性并保持竞争性能。但是,目前很少有文章探索分析这种新兴方法是如何实现以及发生的原因。在这项研究中,我们通过实验探索软提示在自动语音识别(ASR)中的模型应验性质和推理作用,深入了解这种新兴方法的特点。我们的实验结果表明,软提示在改善ASR性能方面发挥了作用。但是,这类型的模型也容易受到软提示恶意修改的影响。软提示有助于泛化,但不是模型推理的强制性要求。我们还确定了软提示的两个主要作用:内容细化和噪声信息增强,这增强了对背景噪声的鲁棒性。此外,我们提出了一种有效的噪声提示修改方法,以表明它们能够在适应分布之外的噪声环境中进行零射击学习。论文预印版下载地址:https://arxiv.org/abs/2309.0941307 论文题目:Leveraging Speech PTM, Text LLM, and Emotional TTS for Speech Emotion Recognition
论文作者:马子阳,吴雯,郑之胜,郭奕玮,陈谦,张仕良,陈谐
论文单位:上海交通大学,剑桥大学,阿里巴巴集团
核心内容:本文探索了如何利用最先进的语音预训练模型(PTM)——data2vec、文本生成技术——GPT-4和语音合成技术——Azure TTS来增强语音情感识别(SER)。首先,我们研究了不同语音自监督预训练模型的表征能力,发现data2vec在SER任务上具有良好的表征能力。其次,我们采用强大的大语言模型(LLM),GPT-4,和语音合成(TTS)模型,Azure TTS,来生成情感一致的文本和语音。
我们精心设计了文本prompt工程和数据集构建,获得高质量的合成情感语音数据。然后,我们研究了不同的数据增强方法来使用合成语音增强SER任务的效果,包括随机混合、对抗性训练、迁移学习和课程学习。在IEMOCAP数据集上的实验和消融实验表明,与其他数据增强方法以及与其他合成数据的增强方法相比,我们提出的方法是有效的。
论文预印版下载地址:https://arxiv.org/abs/2309.10294
08 论文题目:MossFormer2: Combining Transformer and RNN-Free Recurrent Network for Enhanced Time-Domain Monaural Speech Separation
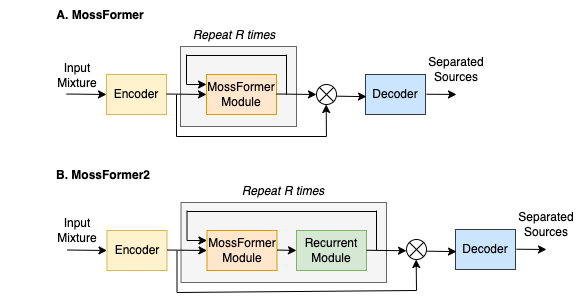
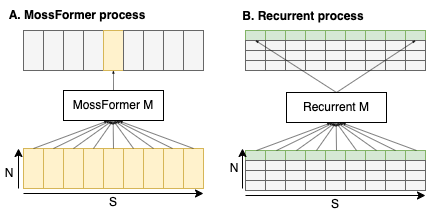
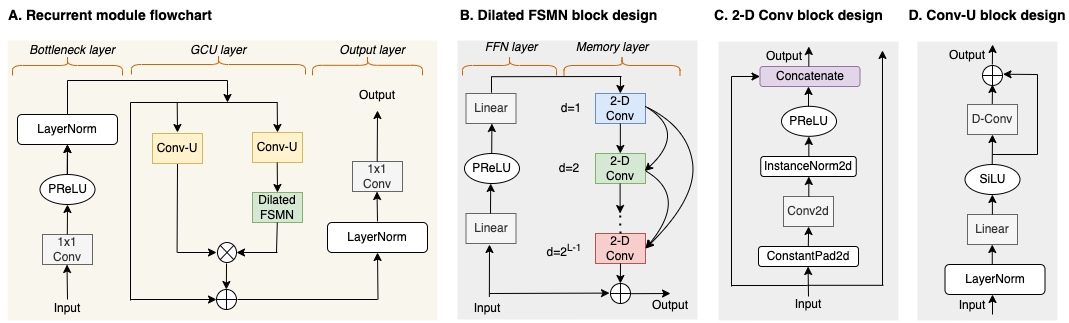
论文作者:赵胜奎,马玉坤,倪崇嘉,张冲,王昊,阮忠孝,周坤,叶家祺,黄殿文,马斌核心内容:我们先前提出的MossFormer在单声道语音分离方面取得了令人鼓舞的表现。然而,由于它主要采用了基于自注意力的MossFormer模块,往往会强调更长范围、更粗粒度的依赖关系,在建模更精细的语音递归模式方面存在不足。在工作中,我们引入了一种新颖的混合模型,通过将一个递归模块集成到MossFormer框架中,提供了同时建模长范围、粗粒度依赖关系和细粒度递归模式的能力。为了缓解非并行循环神经网络(RNN)的局限性,我们提出了基于前向顺序记忆网络(FSMN)的RNN-free递归模块。该递归模块包括一个扩张FSMN块,通过扩张增强接受域,并通过密集连接改善信息流。我们进一步设计了该递归模块,通过使用门控卷积单元(GCU)来促进对相关上下文信息的门控控制,同时允许降低嵌入维度和增强模型效率。递归模块只依赖于线性投影和卷积,可以实现整个序列的无缝并行处理。整合的MossFormer2混合模型在WSJ0-2/3mix、Libri2Mix和WHAM!/WHAMR!基准测试中表现出显著的增强,并超越了其他先进方法。(图示:MossFormer和升级版MossFormer2对比图 )(图示:混合MossFormer和递归模块的示意图)论文预印版下载地址:https://arxiv.org/abs/2312.11825项目开源地址:https://modelscope.cn/models/damo/speech_mossformer2_separation_temporal_8k
09 论文题目:SLIDESPEECH: A Large Scale Slide-Enriched Audio-Visual Corpus
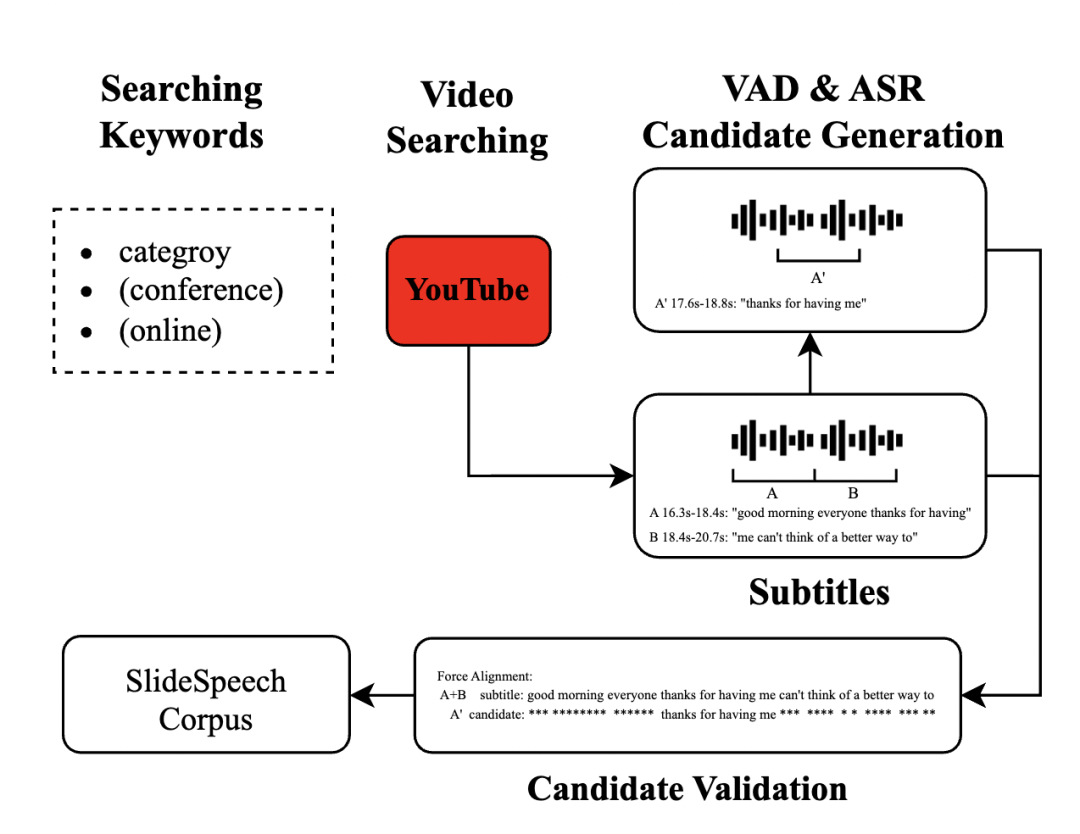
论文作者:王浩旭,俞帆,石宪,汪乐章,张仕良,李明核心内容:多模态自动语音识别(Automatic Speech Recognition,ASR)技术旨在利用更多模态来提高语音识别系统的性能。虽然现有一些多模态方法主要关注视频或上下文信息,但却忽视了对额外补充文本信息的利用。在线会议视频中包含大量幻灯片,这些幻灯片以文本和图像的形式提供了丰富的特定领域信息,有鉴于此,我们发布了 SlideSpeech,这是一个富有幻灯片的大规模音视频多模态语料库。该语料库包含 1,705 个视频,1,000 多个小时,以及 473 个小时的高质量自动生成的语音转录抄本。同时该语料库还包含大量实时同步幻灯片。在这项工作中,我们介绍了构建语料库的流水线,并提出了在可视上下文幻灯片中利用文本信息的基准方法。通过在基准系统中应用关键词提取和上下文自动语音识别(Contextual ASR)方法,我们展示了通过整合补充视频幻灯片中的文本信息来提高语音识别性能的潜力。论文预印版下载地址:https://arxiv.org/abs/2309.05396数据库开源地址:https://slidespeech.github.io/
10 论文题目:Hierarchical Emotion Prediction and Control in Text-to-Speech Synthesis
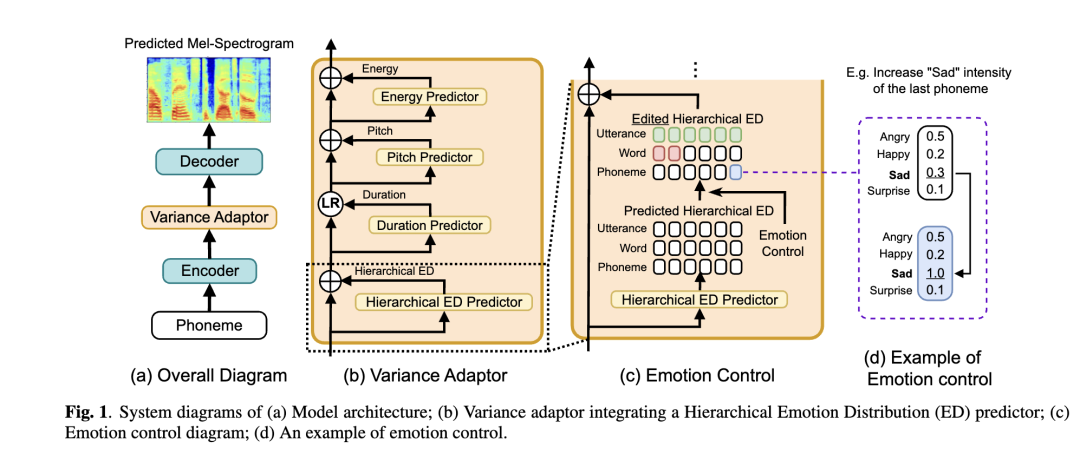
核心内容:如何有效的控制语音合成中的情感渲染仍是一个具有挑战性的问题。之前的工作主要关注在学习全局的韵律表征。但是情感韵律和语言韵律有着很强的相关性。我们的目标是构建一个多层级的情感分布来有效的表示包含音素级,词级和句子级别的情感变化。在训练语音合成模型的时候,多层次的情感分布可以从目标语音中获得,并引导预测模块去建立情感和语言韵律之间的联系。在生成时,语音合成模型生成情感语音,并且同时提供对于各层次情感变化的可量化的控制。客观和主观评测都验证了我们提出的语音合成模型在情感预测和控制上的有效性。(图示:模型结构与计算意图)
11 论文题目:SPGM: Prioritizing Local Features ForEnhanced Speech SeparationPerformance
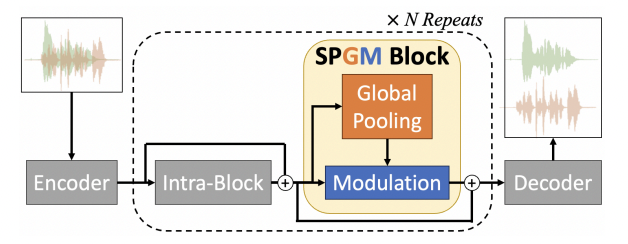
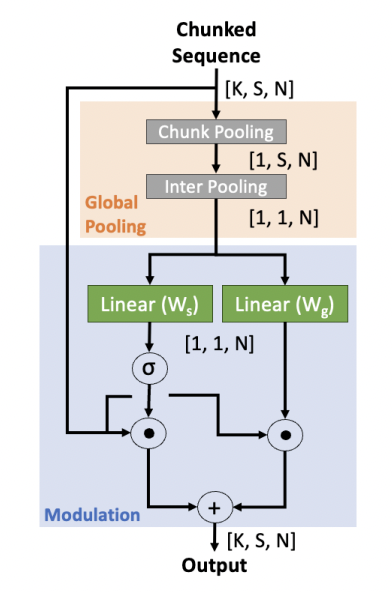
论文作者:叶家祺,赵胜奎,马玉坤,倪崇嘉,张冲,王昊,Trung Hieu Nguyen, 周坤, 黄殿文,庄永祥, 马斌核心内容:双路径是语音分离模型(例如 Sepformer)的一种流行架构,它将长序列分割为重叠其块,分别对块内局部特征和块间全局关系进行建模。然而,由双路径模型参数的一半组成的块间对性能的贡献微乎其微。因此,我们提出单路径全局调制(SPGM)模块来代替块间。SPGM 因其结构而得名,该结构由一个无参数的全局池化模块和一个仅占模型总参数 2% 的调制模块组成。SPGM 模块允许模型中的所有转换器层专用于局部特征建模,从而使整个模型成为单路径。SPGM 在 WSJ0-2Mix 上实现了 22.1 dB SI-SDRi,在 Libri2Mix 上实现了 20.4 dB SI-SDRi,分别比 Sepformer 的性能高出 0.5 dB 和 0.3 dB。SPGM 并与最新 SOTA 模型的性能相匹配,但是参数减少了 8 倍。(图示:SPGM模块结构图,包括全局池化模块(橙色)和调制模块(蓝色))论文预印版下载地址:https://arxiv.org/abs/2309.12608
Code:https://github.com/Yip-Jia-Qi/speechbrain/tree/add_spgm/recipes/WSJ0Mix/separationModel:https://github.com/Yip-Jia-Qi/speechbrain/blob/add_spgm/speechbrain/lobes/models/SPGM.py 
 阿里语音AI