
 阿里语音AI
文章来源于阿里语音AI,作者达摩院语音实验室
作者:刘嘉庆 邓憧 王雯
▎研究背景
近年来,线上会议越发普遍。据统计,每周花在会议上的平均时长——公司员工为 6 小时,而管理者则长达 23 小时 [1]。对大多数工作者来说,投入在线上会议的时间都很可观。
▎研究现状
以下将从建模任务的角度出发,介绍国内外的相关研究现状。
No.1 行动项识别
会议场景的行动项识别任务,早在 2006 年就被提出 [2]。该任务通常被建模为句子级别的文本二分类问题,即判断一个句子是否涉及待办事项。
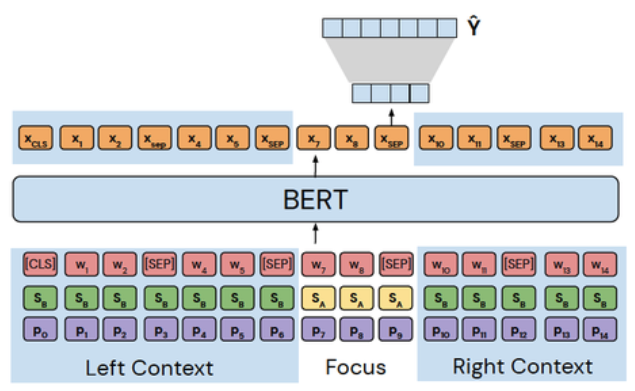
图 1 上下文级别行动项识别模型 [4]
▎会议场景行动项识别
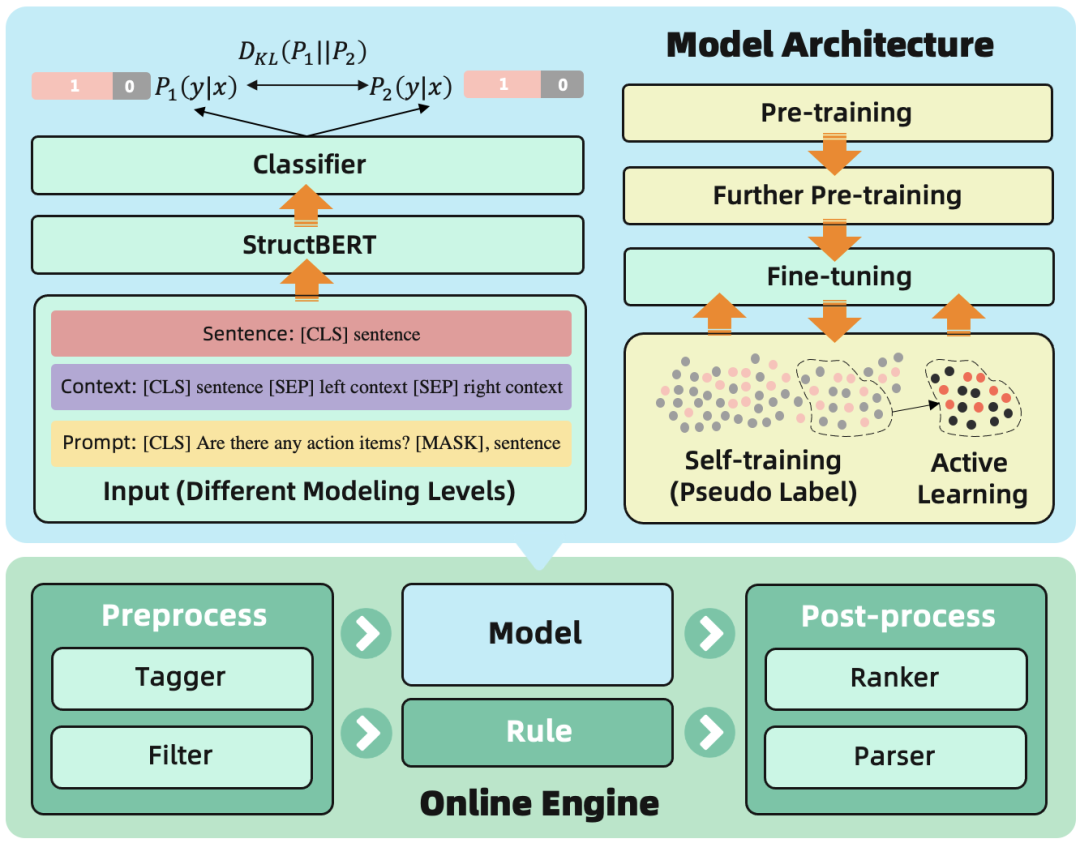
接下来介绍我们在会议场景的行动项识别方法。首先,本文总结了该任务面临的问题和挑战。针对这些挑战,我们给出了解决方案,包括问题建模、模型调优等一系列方法,提高模型表现。此外,我们构建了完整的线上全链路引擎。
数据量少:如表 1 所示,公开会议数据发布时间很早,数量较少。
标注质量低:行动项标注的一致性比较低,标注噪音比较明显。在 ICSI 数据集上,标注 Kappa 值大部分均在 0.6 以下 [2]。
类别不均衡:该任务的类别很不均衡,正例非常稀疏,影响分类模型的表现。
口语特性:会议是复杂的多人口语交互场景,会带来一些口语特性的限制。
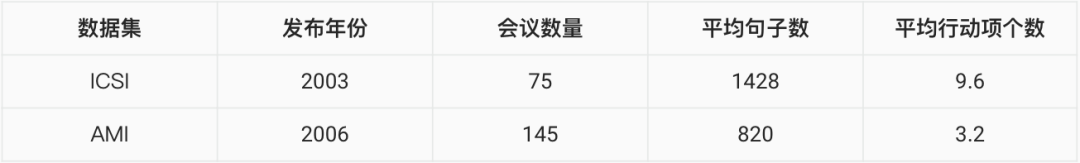
表 1 公开会议数据集统计结果 [6]
这些因素叠加到一起,制约着行动项识别的性能。即使是大规模预训练模型,在该任务上的表现也并不理想,比如 BERT 在 ICSI 数据集上句子级别二分类的 F1 值仅为 39% [4]。
为了选定基模型,我们比较全面地对比了多种 BERT 范式的预训练模型在行动项识别这个下游任务上的表现,发现一些改进的预训练任务可以提升模型对口语场景的适应能力。
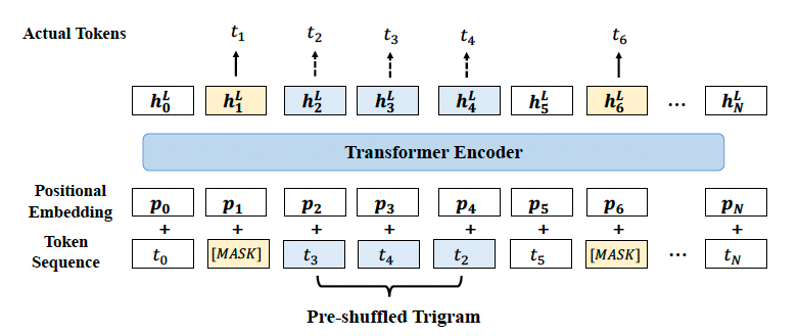
图 3 StructBERT 模型 WSO 任务示意图 [7]
改善标注质量:利用置信学习(confident learning)的方法 [10],根据原始标签和模型预测结果,通过若干启发式的方法,发现一些标注错误的噪音数据,进而改善数据集标注质量,带来 F1 值 3 个点的提升。除此以外,还采用 label smoothing 来提升模型的抗噪能力,降低标注错误的负面影响。
缓解类别不均衡:通过多种数据增强的方法,扩充正例的数据量,增加正例样本的占比。而且,引入 focal loss 使模型更关注于易错正例样本的学习,来缓解正例样本稀疏性问题带来的性能损失,总共带来 F1 值 4 个点的绝对提升。
书面化处理:有研究发现,书面文本(如邮件)上的行动项识别,明显优于口语文本上的表现。为了缓解口语噪音对性能的损害,尝试对口语数据进行书面化风格转写的前处理,观察到 Precision 有 3 个点的提升。
引入上下文信息:把上下文拼接到当前句子的后面,如图 2 中 Context 部分所示,增大可用信息量,带来 F1 值 1 个点左右的绝对提升。
提高模型鲁棒性:采用 R-Drop 的方法 [11],如图 2 左上部分所示,对一个句子做两次 dropout,希望它们的预测概率分布尽可能地接近,缓解了 training 阶段和 inference 阶段 dropout 不一致的问题,带来 F1 值 2 个点的绝对提升。
▎实验结果分析
数据集
模拟会议测试集:来自模拟会议,符合行动项识别目标应用场景,通过 F1 进行评价。
行动指令测试集:由众包编写的来自多个行业的行动指令,用来评测模型对于跨行业的明确行动项指令的覆盖能力,通过 Recall 进行评价。
演讲/访谈测试集:来自演讲、访谈场景,理论上没有真正的待办相关语句,通过 FPR (False Positive Rate) 进行评价。
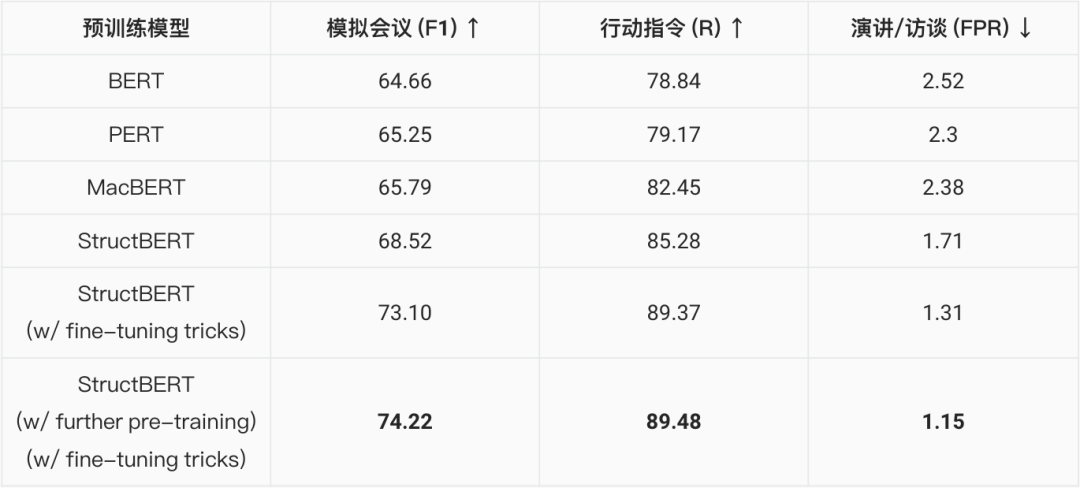
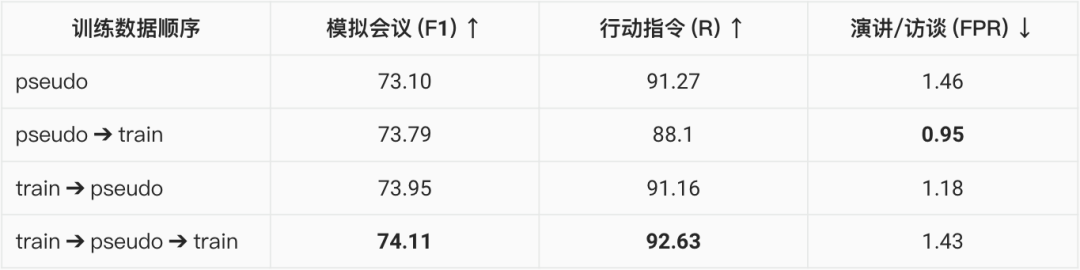
表 3 不同自训练顺序实验结果
▎Future work
行动项识别任务,仍然是个很有挑战的任务,有很多问题尚未完全解决。为此,我们进行了多种探索,推进智能待办功能在会议场景中的应用。希望在未来,智能待办能更好地帮助用户整理会议纪要,方便用户更便捷地跟进会后行动。
接下来,我们将尝试不同粒度的建模范式,比如从句子级扩展到篇章级的建模。计划通过文本结构化的方法,更好地提供待办事项的相关要素信息。
References:
[1] Rogelberg, S., Scott, C., Kello, J. 2007. The Science and Fiction of Meetings. In MIT Sloan Management Review, volume 48, pp. 18-21.
[2] Morgan, W., Chang, P.C., Gupta, S. and Brenier, J., 2006, July. Automatically detecting action items in audio meeting recordings. In Proceedings of the 7th SIGdial Workshop on Discourse and Dialogue (pp. 96-103).
[3] Sachdeva, K., Maynez, J. and Siohan, O., 2021, December. Action Item Detection in Meetings Using Pretrained Transformers. In 2021 IEEE Automatic Speech Recognition and Understanding Workshop (ASRU) (pp. 861-868). IEEE.
[4] Mullenbach, J., Pruksachatkun, Y., Adler, S., Seale, J., Swartz, J., McKelvey, G., Dai, H., Yang, Y. and Sontag, D., 2021, August. CLIP: A Dataset for Extracting Action Items for Physicians from Hospital Discharge Notes. In ACL-IJCNLP 2021 (Volume 1: Long Papers) (pp. 1365-1378).
[5] Purver, M., Dowding, J., Niekrasz, J., Ehlen, P., Noorbaloochi, S. and Peters, S., 2007, September. Detecting and summarizing action items in multi-party dialogue. In Proceedings of the 8th SIGdial Workshop on Discourse and Dialogue (pp. 18-25).
[6] Cohen, A., Kantor, A., Hilleli, S. and Kolman, E., 2021, August. Automatic Rephrasing of Transcripts-based Action Items. In Findings of the Association for Computational Linguistics: ACL-IJCNLP 2021 (pp. 2862-2873).
[7] Wang, W., Bi, B., Yan, M., Wu, C., Xia, J., Bao, Z., Peng, L. and Si, L., 2019, September. StructBERT: Incorporating Language Structures into Pre-training for Deep Language Understanding. In International Conference on Learning Representations.
[8] Cui, Y., Yang, Z. and Liu, T., 2022. PERT: Pre-training BERT with Permuted Language Model. arXiv preprint arXiv:2203.06906.
[9] Cui, Y., Che, W., Liu, T., Qin, B., Wang, S. and Hu, G., 2020, November. Revisiting Pre-Trained Models for Chinese Natural Language Processing. In Findings of the Association for Computational Linguistics: EMNLP 2020 (pp. 657-668).
[10] Northcutt, C., Jiang, L. and Chuang, I., 2021. Confident learning: Estimating uncertainty in dataset labels. Journal of Artificial Intelligence Research, 70, pp.1373-1411.
[11] Wu, L., Li, J., Wang, Y., Meng, Q., Qin, T., Chen, W., Zhang, M. and Liu, T.Y., 2021. R-drop: Regularized dropout for neural networks. Advances in Neural Information Processing Systems, 34, pp.10890-10905.
[12] Yu, F., Zhang, S., Fu, Y., Xie, L., Zheng, S., Du, Z., Huang, W., Guo, P., Yan, Z., Ma, B. and Xu, X., 2022, May. M2MeT: The ICASSP 2022 multi-channel multi-party meeting transcription challenge. In ICASSP 2022-2022 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP) (pp. 6167-6171). IEEE.
