
 西工大音频语音与语言处理研究组
文章来源于音频语音与语言处理研究组,作者雷怡
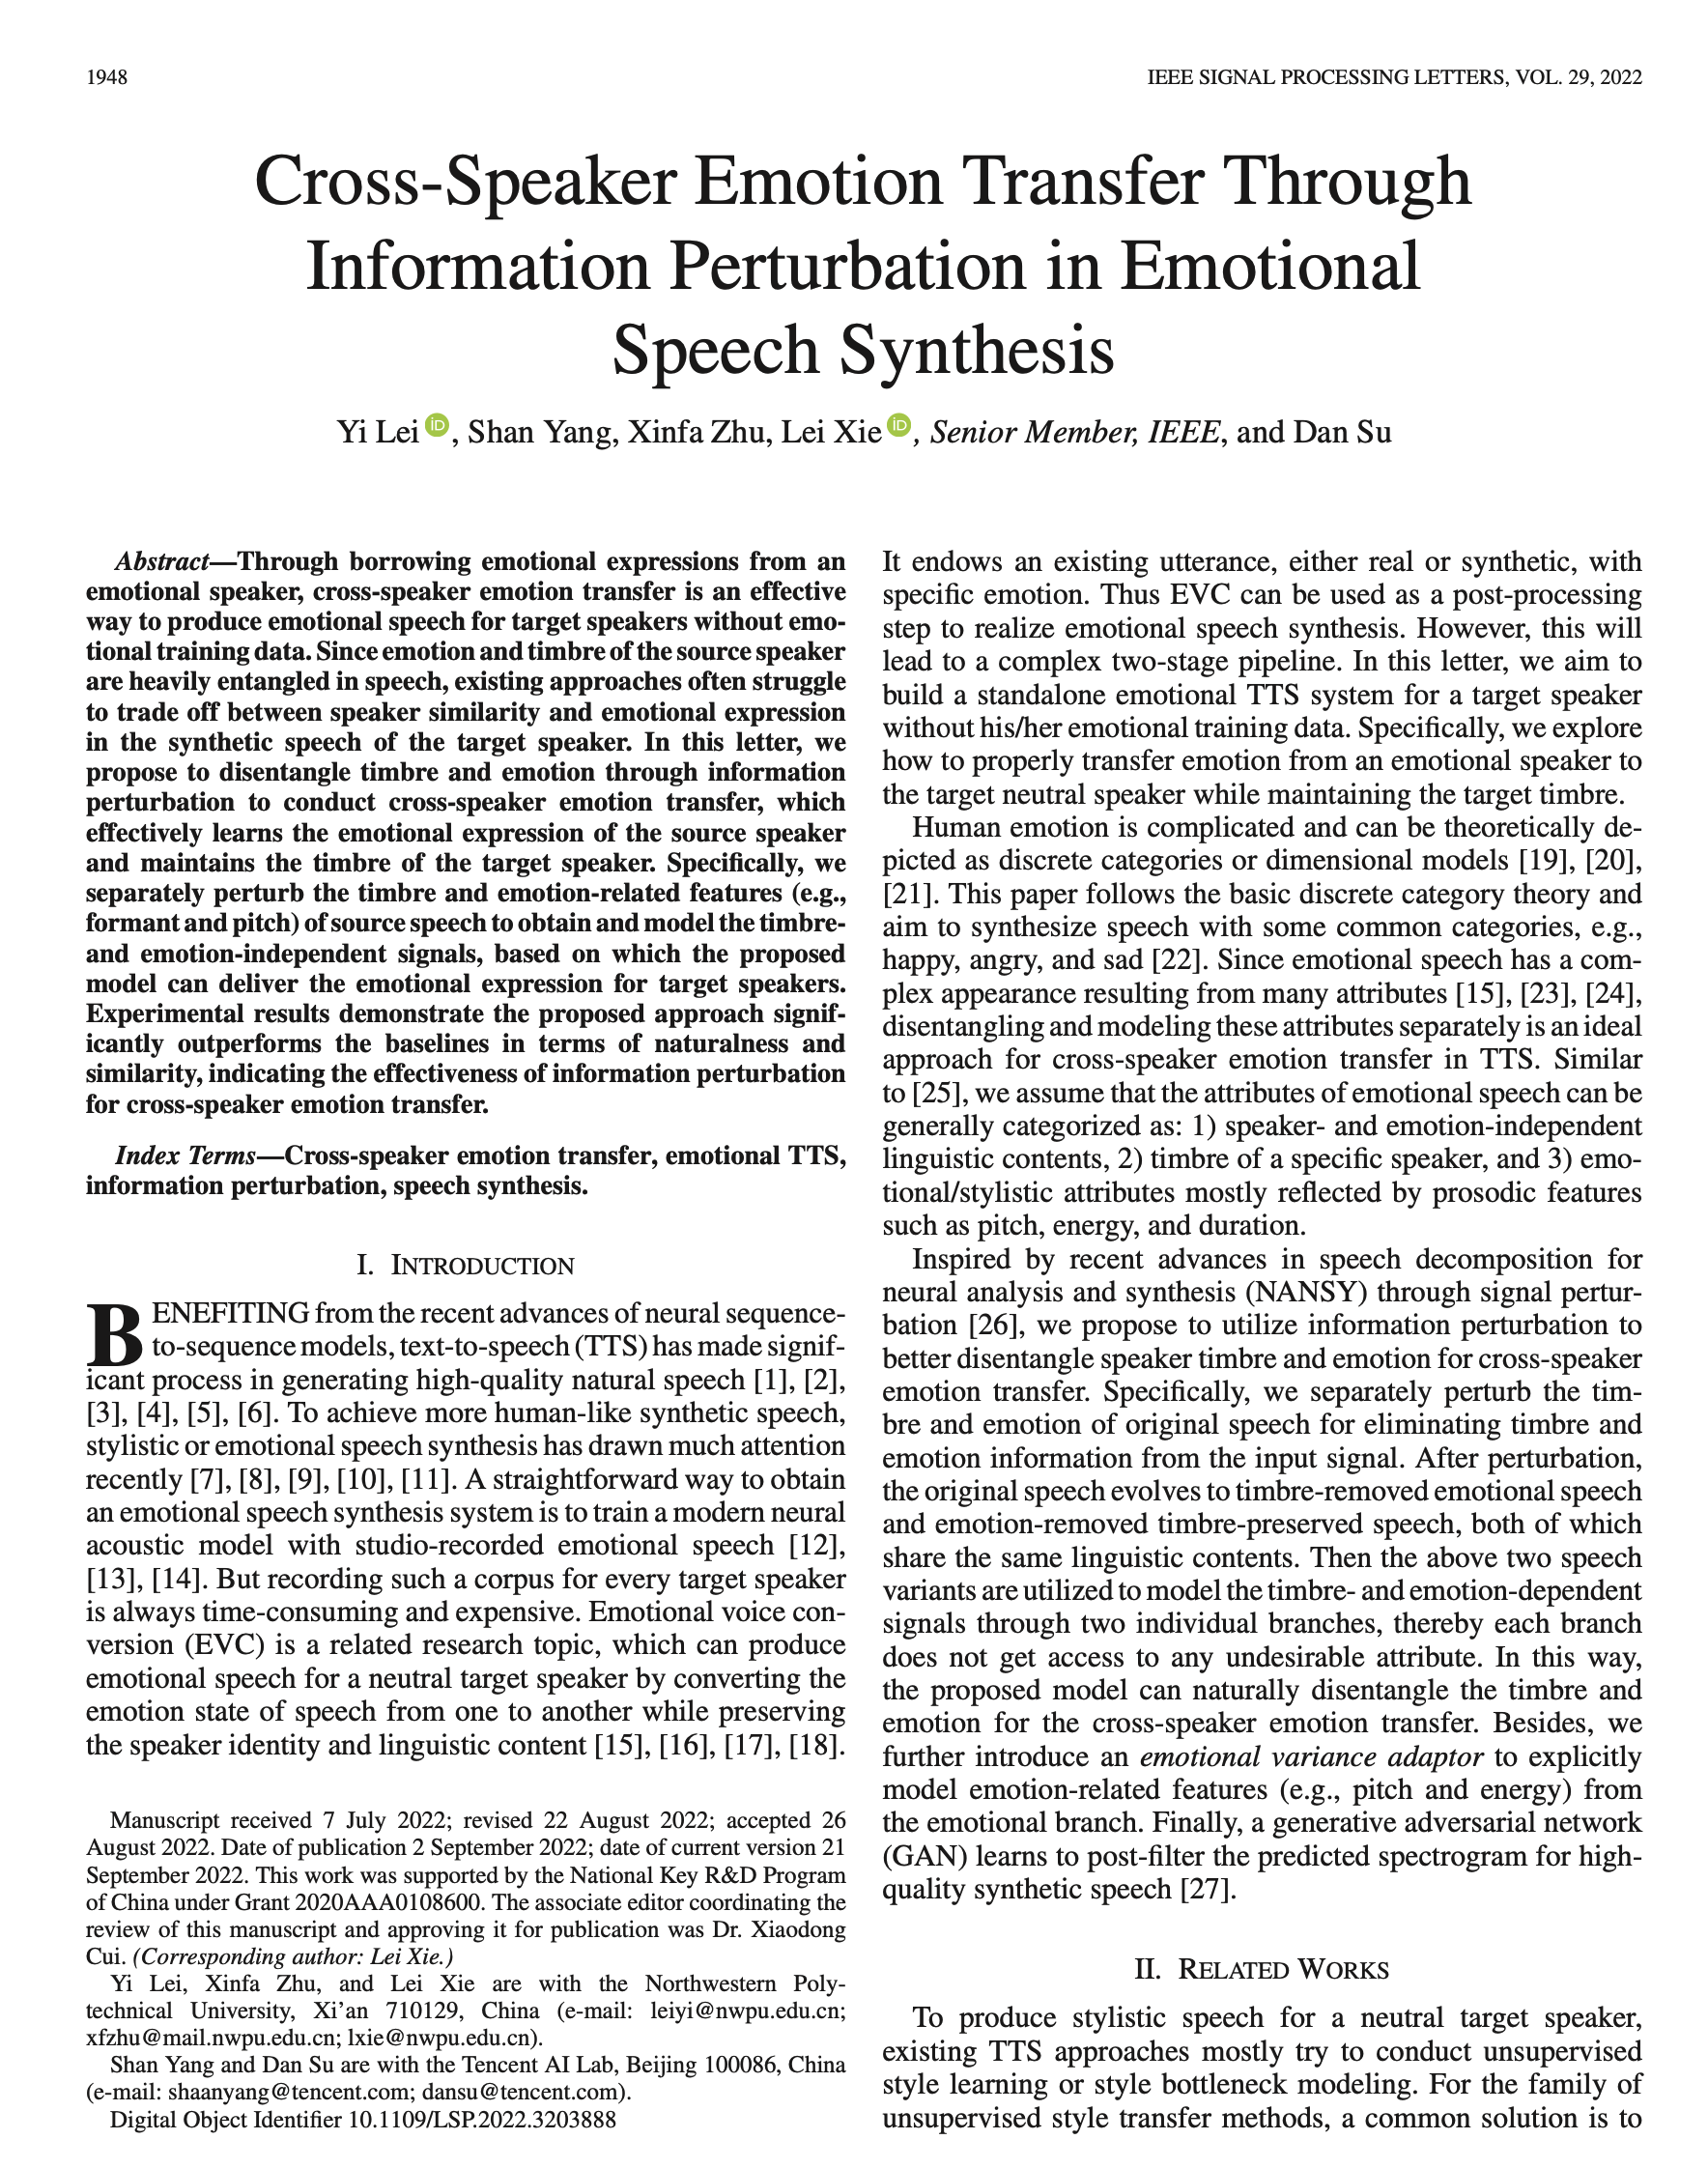
发表论文截图
情感表达对于语音合成的自然度至关重要,为此近期很多研究关注于情感语音合成工作。一般来说,合成情感语音最直接的方式是利用目标说话人高质量情感语音数据训练一个情感语音合成系统。然而,对于每个说话人都录制一个情感语音数据库显然是费时费力的。情感语音转换(Voice Conversion)技术,可以将语音从一种情感状态转换为另一种情感状态,同时保持说话人身份和语言内容不变,从而为不带情感数据的目标说话人产生情感语音,可以作为语音合成的一个后处理步骤来实现情感表达。然而,VC和TTS两步模型将导致一个复杂的两级流程。因此,本文旨在为没有情感训练数据的目标说话人构建一个独立的情感TTS系统,研究如何在保持良好的目标说话人音色的同时,将情感表达从一个情感说话人适当地迁移到目标说话人。
本文遵循基本的离散情感类别,旨在合成具有一些常见的大类情感语音,如高兴、愤怒和悲伤等。我们假设影响情感语音的属性通常可以分为:1)与说话人和情感无关的语言内容,2)特定说话人的音色,以及3)主要由音高、能量和时长等韵律特征反映的情感属性。
受到文章[1]的启发,本文提出利用信息扰动(Information Perturbation)来更好地分离说话人音色和情感,以进行跨说话人情感迁移。具体来说,我们分别对源说话人的音色和情感进行扰动,以从输入信号中消除音色和情感信息。扰动后,原始语音演变为去除说话人音色的情感语音和扰乱情感表达的说话人音色保留语音,二者具有相同的语言内容。然后,利用上述两个语音变体,通过两个单独的分支对音色和情感相关信号进行建模,从而每个分支都不会引入任何不需要的属性。通过这种方式,该模型可以自然地分离音色和情感以进行跨说话人情感迁移。此外,我们还引入了一个情感变量适配器(Emotional Variance Adaptor)来显式建模情感分支中与情感相关的特征(例如音高和能量)。最后,我们使用生成对抗网络(GAN)对预测的语谱进行后处理,以提升合成语音的质量。
本文通过信号扰动的方式来解耦音色和情感,而不是传统的在隐层表征中进行音色和情感解耦方法。受干扰的语音由不同的生成器分别用特定的控制因素建模,然后利用Mel解码器产生目标音色的情感语音。
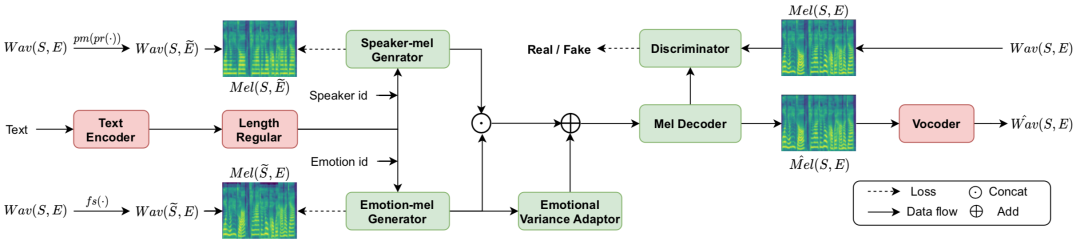
如图1所示,本文模型的结构由以下模块组成:
编码器(Encoder),包含一个长度规整器Length Regulator以提供声学对齐的文本信息,时长预测器duration predictor以encoder的输出和情感id为输入;
说话人梅尔生成器(Speaker-mel Generator),以生成与说话人相关的情感无关的语谱;
情感梅尔生成器(Emotion-mel Generator),用于生成与情感相关的说话人无关的语谱;
情感变量适配器(Emotional Variance Adaptor),用于提供情感相关显式特征;
梅尔解码器(Mel Decoder),用于生成最终目标的mel谱;
生成对抗网络(GAN),用于优化预测语谱的质量。
2.1 信息的扰动和生成
假设Wav(S, E)代表说话人S和情感E的原始波形,我们的目标是解耦S与E,以便进一步进行跨说话人情感迁移。由于说话人的音色与语音共振峰紧密相关,干扰语音的共振峰会扭曲语音信号中的说话人身份S,而情感表达有望保持不变。为了实现这个目标,我们使用共振峰移位函数fs在一个随机范围内移动语音共振峰,以获得修改后的波形Wav(S~, E) =fs(Wav(S, E)),其中说话人身份被扰动为S~,同时情感表达E被保留。由于情感表达与音高走势紧密相关,特别是对于汉语等带调语言,我们通过随机平移和单调函数来扰动音高信息。具体来说,我们首先对语音的音高进行随机幅度的平移。由于不同情感类别语音中的音高变化趋势在平移后仍然会保留,我们进一步将所有音高值单调化为平均音高。因此,我们得到扭曲了情感表达的波形Wav(S, E~)=pm(pr(Wav(S, E)),其中pr和pm分别是pitch随机化和单调化函数。因此,扰动情感的波形Wav(S, E~)可以视为与说话人相关同时与情感无关。
信息扰动效果示例
原始音频(surprise):
给定上述情感相关波形Wav(S~, E)和说话人相关波形Wav(S, E~),本文通过两个单独的生成器建模相应的扰动谱Mel(S~,E)和Mel(S, E~)。第一个生成器被视为speaker-mel生成器G_s,其目的是从持续时间扩展的编码器输出文本和说话人身份S生成情感无关且说话人相关的mel谱。第二个生成器G_e称为emotion-mel生成器,它根据文本特征和情感嵌入生成与说话人无关的情感mel谱。我们使用L2 loss对扰动语音建模进行约束。
2.2 Mel解码器与GAN
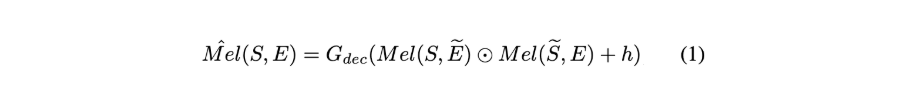
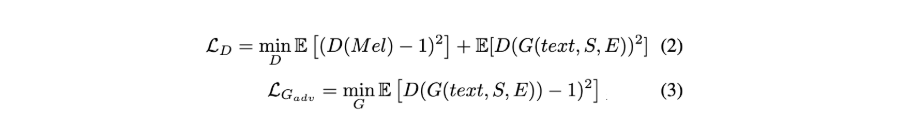
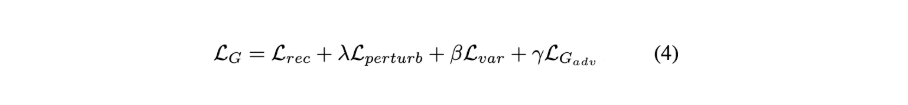
3.1 实验设置
源说话人:SRC,包含中性语音和5类情感(高兴、愤怒、悲伤、惊讶和厌恶)语音。2000条/类。
目标说话人:F1、F2、M1,中性无明显情感表达,2000条/人。
为了充分扰动说话人或情感信息,我们将每个音频文件分为四段,并用不同的随机值分别对每段执行pr和fs扰动函数。这样,来自同一条语音的样点可以在不同的尺度上受到扰动。函数pm适用于整个语句。
3.2 对比系统
为了进行公平比较,基于FastSpeech构建了以下系统。
FS-GST[4]:利用Global Style Tokens(GST)层来建模情感表达式; FS-VAE[5]:利用可变自动编码器(VAE)模块以学习情感潜在表达式; FS-BN[6]:结合了瓶颈特征(bottleneck feature)来进行跨说话人风格的转换。
3.3 实验结果
表1 说话人相似度、情感相似度、语音自然度MOS打分
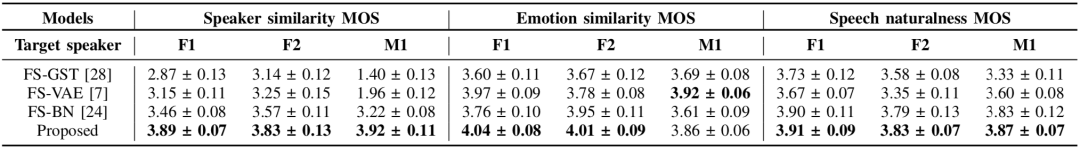
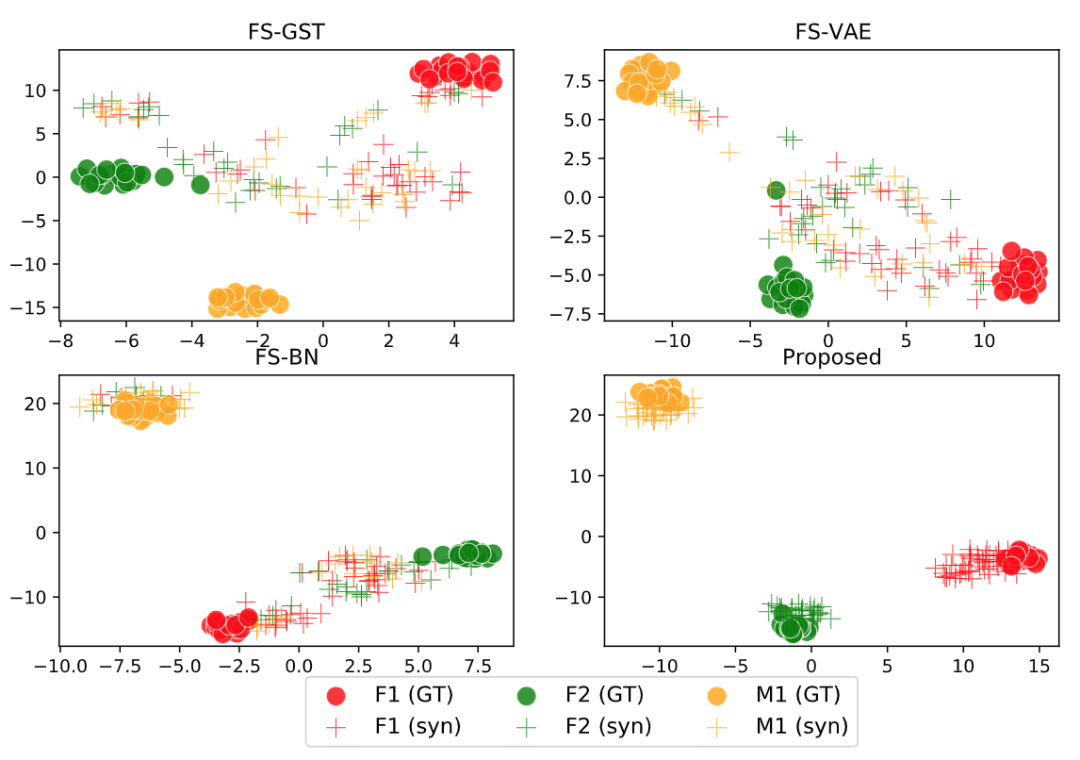
图2 说话人嵌入t-SNE可视化
通过可视化,我们可以发现FS-GST和FS-VAE中的三个说话人簇混合在一起,这反映了在跨说话人情感迁移中各自说话人音色的保持较差。对于FS-BN,情况稍好,但来自不同目标说话人的一些合成样本混合在同一簇中。对于本文提出的方法,三个目标说话人嵌入形成了三个边界清晰的不同簇,并且同一说话人的真实语音和生成语音几乎位于同一簇中。这一现象进一步表明,本文提出方法可以让无情感数据的目标说话人产生情感语音,同时准确地保持目标说话人的音色,无论是同性还是跨性别迁移的情况。
情感相似度:为了评估中性目标说话人在生成语音中的情感表达,我们也对情感相似度进行了主观实验,结果如表1所示。结果表明,本文所提出的方法为两位女性说话人实现了最佳的情感表达。尽管FS-VAE获得了男性说话人M1的最佳情感相似度,但正如先前所述,FS-VAE方案获得的说话人相似度差,即它在跨说话人情感迁移中无法保持目标说话人的音色。这意味着FS-VAE合成语音听起来更像源说话人,而不是目标说话人。
由于情感表达与音高趋势相关,我们进一步计算了生成音频的基频和真实音频基频的皮尔逊相关系数。如表2所示,可以看到在大多数情况下,本文方法合成的情感语音的基音与真实情感源语音的基频走势更为相关。
表2 Lf0皮尔逊相关系数(F1、F2和M1是目标说话人,SRC是源情感说话人)
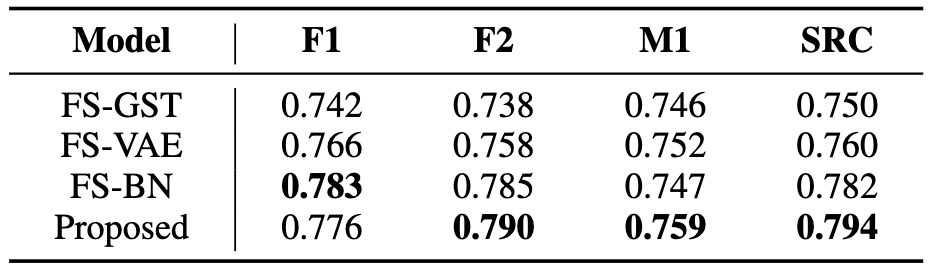
语音自然度:上述表1中也展示了语音自然度评估结果。对于三个目标中性说话人,FS-BN模型显著优于基于GST和VAE的模型,而本文提出的方法略优于FS-BN。自然度评估验证了本文模型能够产生自然的情感语音。
分支分析:为了直观地显示本文的解耦效果,我们进一步分析了从不同分支中学习到的语音。图3(a)显示了合成的中间语音和最终语音的基频。我们观察到来自“speaker mel”生成器的语音是无情感的,具有平滑且不变的F0曲线;而F0在来自“emotion mel”生成器和最终合成语音的语音中更加富有变化。图3(b)显示了从三个目标说话人的不同分支提取的说话人嵌入。结果表明,“emotion mel”生成器的输出往往不包含说话人音色信息,只有“speaker mel”生成器才能为最终迁移的情感语音提供说话人身份信息。
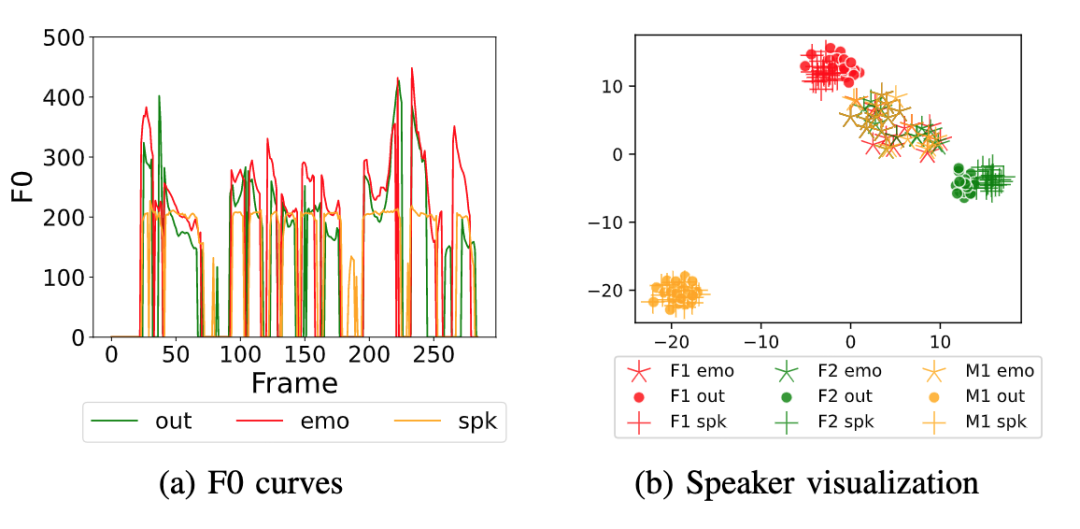
图3 分支分析结果
Surprise:
F2:
Angry-F2:
本文研究了情感TTS系统中的跨说话人情感迁移方法,同时在推理时不需要参考音频。我们利用情感和音色扰动,分别学习说话人相关和情感相关的语谱,并提出emotional variance adaptor,为最终的语音生成提供显式情感特征。同时为了进一步提高合成语音的质量,采用了基于GAN的训练策略。实验表明,本文方法能够有效地捕捉源说话人的情感表达,同时保持目标说话人的音色。未来我们将探索跨说话人的细粒度情感控制以及对连续情感空间的建模。
[1] H.-S. Choi, J. Lee, W. Kim, J. Lee, H. Heo, and K. Lee, “Neural analysis and synthesis: Reconstructing speech from self-supervised representations,” Advances in Neural Information Processing Systems, vol. 34, pp. 16 251–16 265, 2021.
[2] Y. Ren et al., “Fastspeech 2: Fast and high-quality end-to-end text to speech,” in Proc. Int. Conf. Learn. Representations, 2020.
[3] Y. Ren, Y. Ruan, X. Tan, T. Qin, S. Zhao, Z. Zhao, and T.-Y. Liu, “Fast-speech: Fast, robust and controllable text to speech,” The International Conference on Neural Information Processing Systems (NeurIPS), pp. 3165–3174, 2019.
[4] Y. Wang, D. Stanton, Y. Zhang, R.-S. Ryan, E. Battenberg, J. Shor, Y. Xiao, Y. Jia, F. Ren, and R. A. Saurous, “Style tokens: Unsupervised style modeling, control and transfer in end-to-end speech synthesis,” in the International Conference on Machine Learning (ICML). PMLR, 2018, pp. 5180–5189.
[5] K. Akuzawa, Y. Iwasawa, and Y. Matsuo, “Expressive Speech Synthesis via Modeling Expressions with Variational Autoencoder,” in The Annual Conference of the International Speech Communication Association (Interspeech), 2018, pp. 3067–3071.
[6] S. Pan and L. He, “Cross-Speaker Style Transfer with Prosody Bottleneck in Neural Speech Synthesis,” in The Annual Conference of the International Speech Communication Association (Interspeech), 2021, pp. 4678–4682.
[7] Y. Wang, R. Skerry-Ryan, D. Stanton, Y. Wu, R. J. Weiss, N. Jaitly, Z. Yang, Y. Xiao, Z. Chen, S. Bengio et al., “Tacotron: Towards end-to-end speech synthesis,” in The Annual Conference of the International Speech Communication Association (Interspeech), 2017, pp. 4006–4010.
[8] R. Liu, B. Sisman, G. Gao, and H. Li, “Expressive tts training with frame and style reconstruction loss,” IEEE/ACM Transactions on Audio, Speech, and Language Processing, vol. 29, pp. 1806–1818, 2021.
