
 西工大音频语音与语言处理研究组
文章来源于音频语音与语言处理研究组,作者魏坤
语音到语音翻译(Speech-to-speech Translation, S2ST)[1,2,3]是指将一种语言的语音转换成另一种语言的语音的一类技术。和传统的文本到文本的机器翻译不同,S2ST任务的输入和输出均为语音,这项技术在全球化趋势下越来越重要,尤其是在跨境交流、旅游、商务等领域提供更为直接的便利。典型的S2ST系统通常由三个任务组成:语音识别(ASR)、机器翻译(MT)和文语转换(TTS)。这类级联系统分别将输入的源语言的语音信号转换成文本,再将文本翻译成目标语言的文本、最后将目标语言的文本转换成相应目标语言的语音。这种级联的系统存在一些问题。首先,每个任务都可能产生误差,这些误差可能会在后续任务中逐渐累积,导致结果的不准确性。其次,级联系统可能无法准确地捕捉说话者的情感和韵律等重要的副语言信息,影响交流质量。此外,级联系统的推理速度可能会受到各个任务加和的限制。为了解决这些问题,研究人员开始探索直接语音到语音的直接翻译系统,将ASR、MT和TTS任务整合到一个单一的端到端模型中,直接将一种语言的语音翻译成另一种语言的语音。
语音到语音翻译是西工大音频语音与语言处理研究组(ASLP@NPU)的重要研究方向之一。近期,实验室和微软亚洲研究院合作论文“Joint Pre-Training with Speech and Bilingual Text for Direct Speech to Speech Translation”被语音研究顶级会议ICASSP 2023接收。当前,源语言到目标语言的成对语音语料非常稀缺。为了解决这个问题,本文提出了一个名为Speech2S的模型,将非成对语音和双语文本数据一起进行联合预训练,用于语音到语音直接翻译任务。通过有效地利用成对文本数据,Speech2S模型能够模拟从源语言到目标语言的跨语言语音翻译。在Europarl-ST和VoxPopuli数据集上的实验表明,Speech2S相比仅编码器进行预训练的模型获得了约5个BLEU分数的提高,实现了与现有最先进模型相当或甚至更好的性能。
https://github.com/microsoft/SpeechT5/tree/main/Speech2S
论文原文:https://arxiv.org/abs/2210.17027
图1 发表论文截图
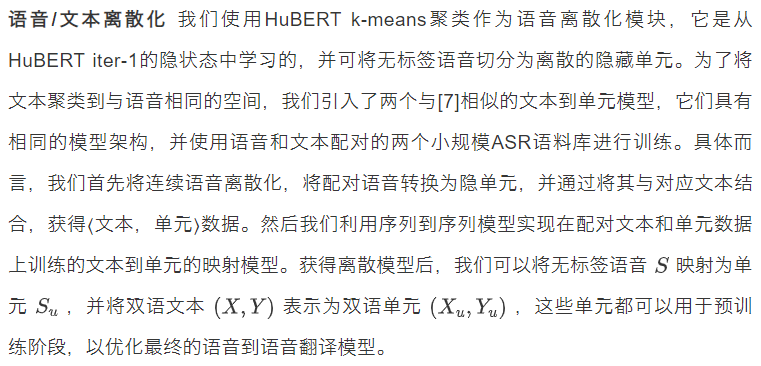
我们的目标是针对双语语音数据对语料稀缺的的问题,利用配对的机器翻译语料来弥合源语音和目标语音之间的语义差距。本节介绍Speech2S的模型架构以及模型预训练和微调方法的细节。
2.1 模型结构
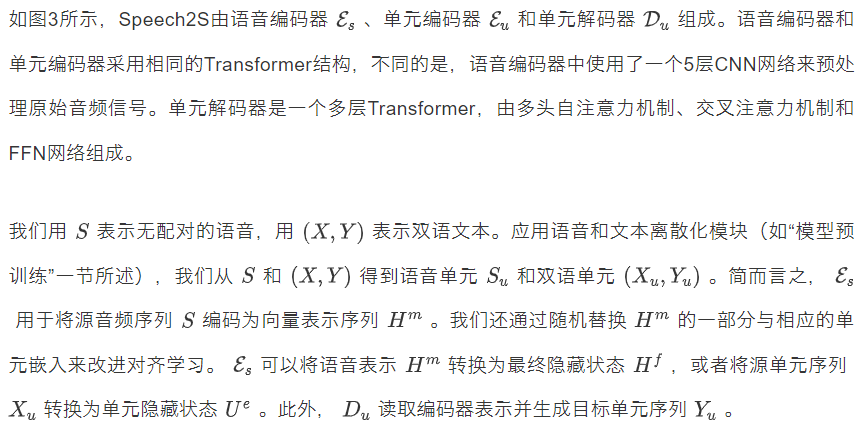
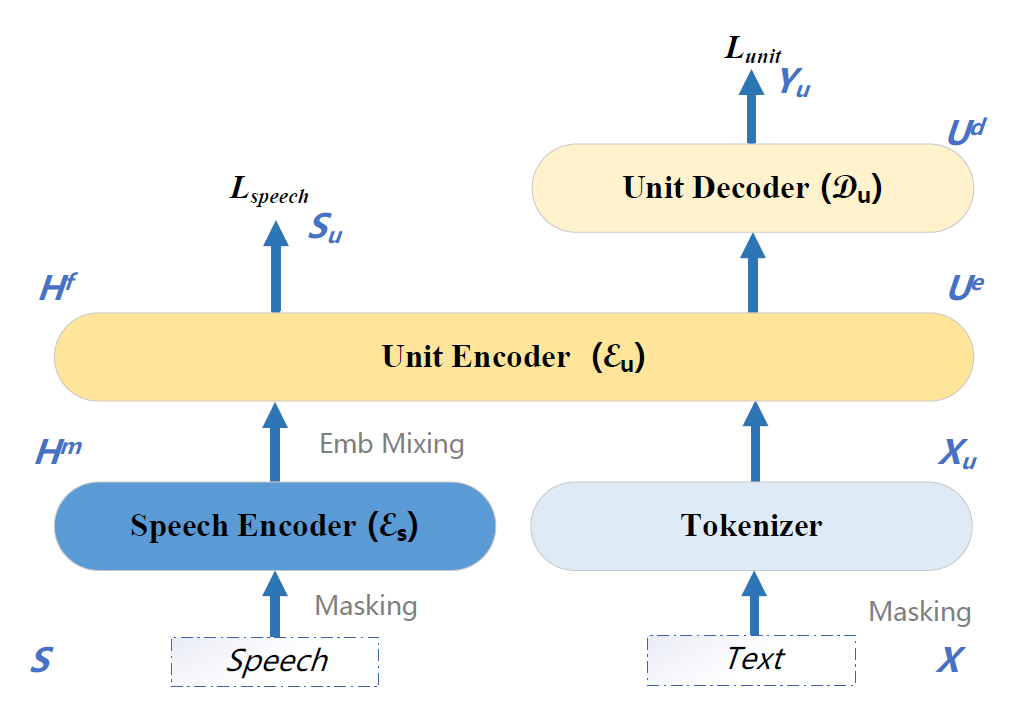
图3 模型结构
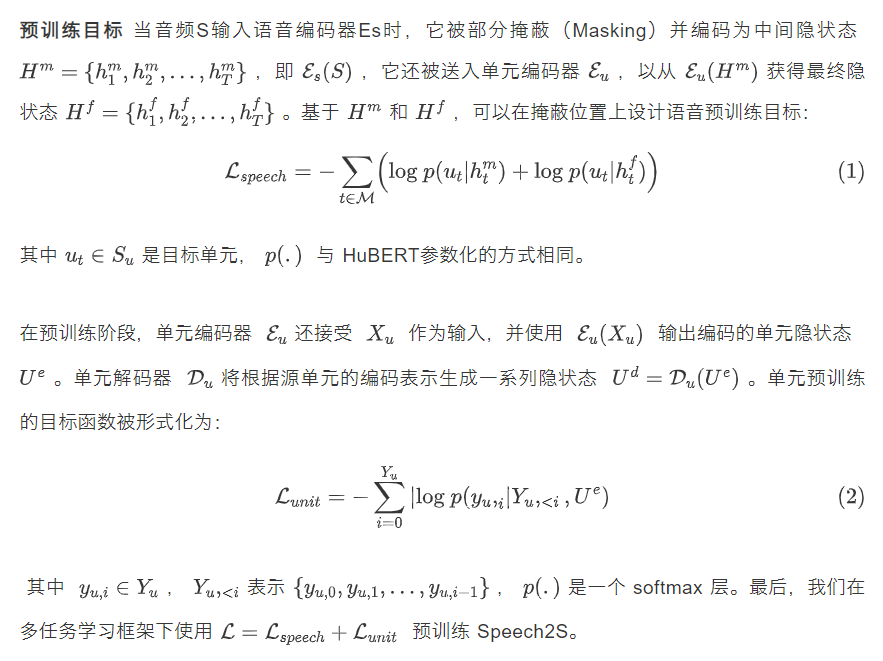
2.2 模型预训练
3.1 数据集
3.2 实验结果
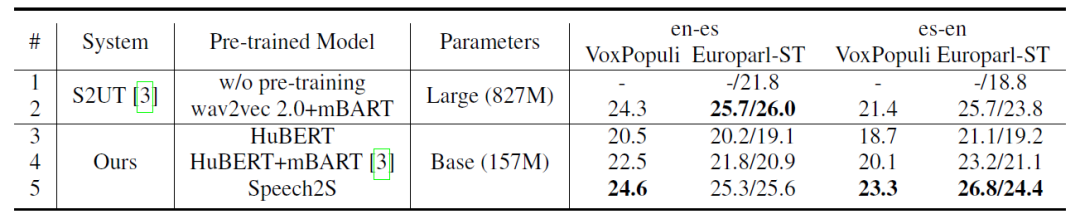
表1显示了 S2UT 系统 [3] 和我们的 Speech2S 系统的 BLEU 分数。通过对比基于 HuBERT 微调的模型和我们提出的模型,可以发现我们的模型在两个方向的 S2ST 任务上获得了超过 4 个 BLEU 值的增益(#5 与 #3)。与从 HuBERT 编码器和 mBART 解码器微调的 S2UT 基线模型相比,我们所提出的 Speech2S 模型仍然有超过 3 个 BLEU 分数的提升(#5 与 #4)。这个结果证明了我们的模型可以通过预训练更好地将文本信息融入语言模型,并通过共享单元编码器学习源语言语音和目标语言单元之间的相应关系。此外,将我们的模型与论文中的 S2UT Large 模型进行比较(#5 与 #2),可以发现,我们的方案在参数较少的情况下,在英语-西班牙语任务上实现了与 S2UT Large 几乎相同的结果,而在西班牙语-英语测试集上,我们的模型超越了Large模型的结果,这也验证了本文提出方案的优越性。
3.3 微调数据大小的影响
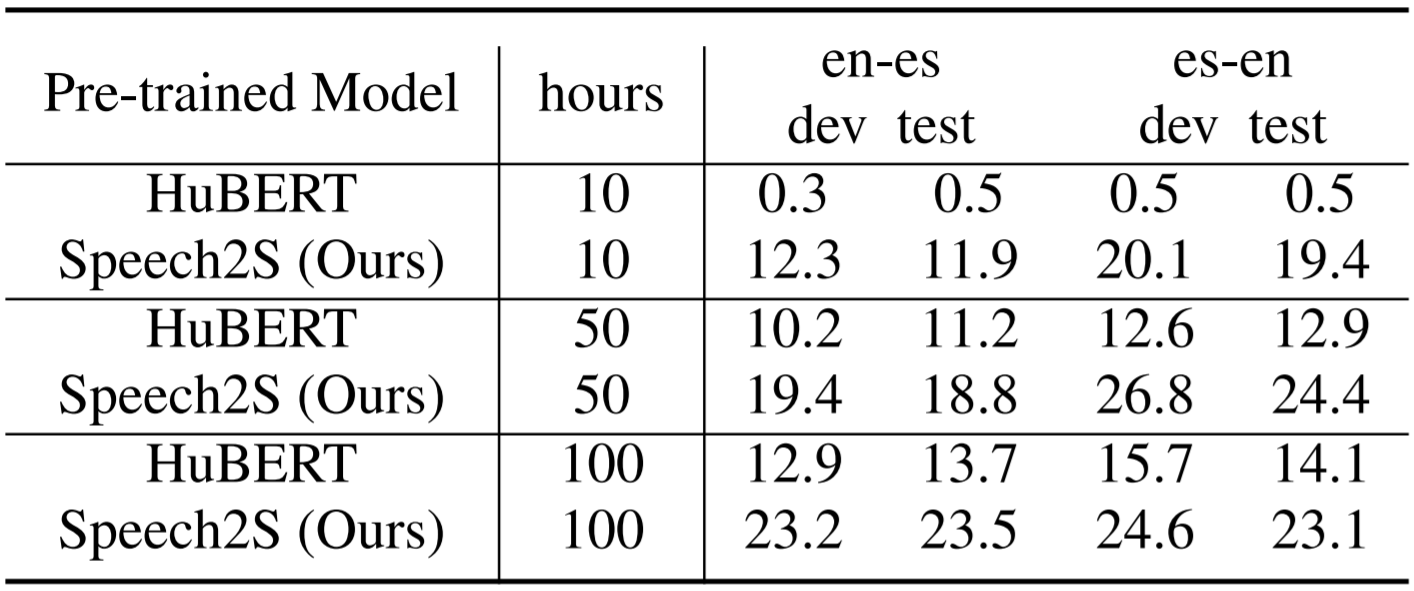
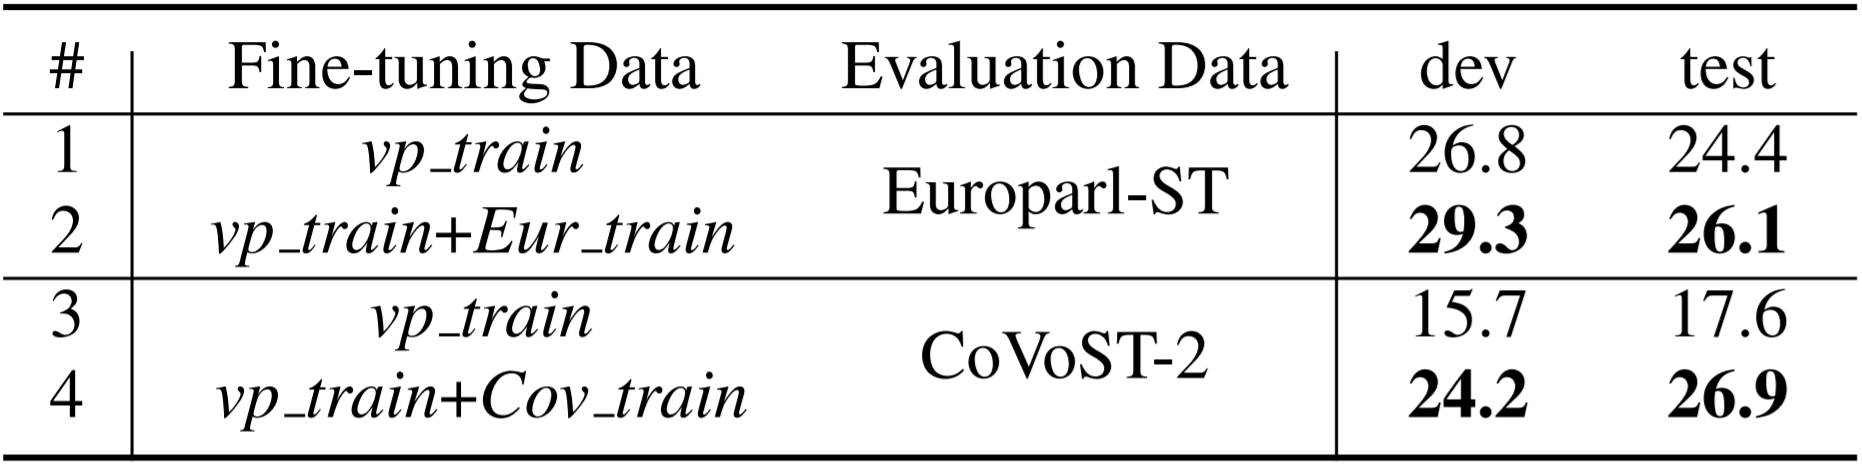
3.4 数据增广
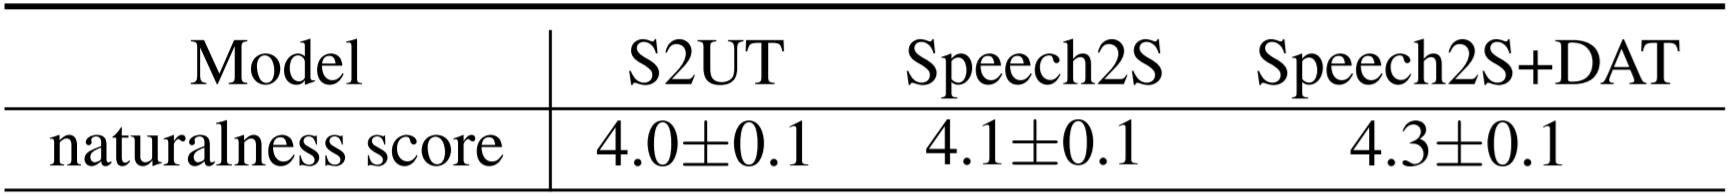
3.5 主观评测
参考文献
[1] Ye Jia, Ron J Weiss, Fadi Biadsy, Wolfgang Macherey, Melvin Johnson, Zhifeng Chen, and Yonghui Wu,“Direct speech-to-speech translation with a sequence-to-sequence model,” arXiv preprint arXiv:1904.06037, 2019.
[2] Ann Lee, Peng-Jen Chen, Changhan Wang, Jiatao Gu, Xutai Ma, Adam Polyak, Yossi Adi, Qing He, Yun Tang, Juan Pino, et al., “Direct speech-to-speech translation with discrete units,” arXiv preprint arXiv:2107.05604, 2021.
[3] Sravya Popuri, Peng-Jen Chen, Changhan Wang, Juan Pino, Yossi Adi, Jiatao Gu, Wei-Ning Hsu, and Ann Lee, “Enhanced direct speech-to-speech translation using self-supervised pre-training and data augmentation,” arXiv preprint arXiv:2204.02967, 2022.
[4] Javier Iranzo-S ́anchez, Joan Albert Silvestre-Cerda, Javier Jorge, Nahuel Rosell ́o, Adria Gim ́enez, Albert Sanchis, Jorge Civera, and Alfons Juan, “Europarl-st: A multilingual corpus for speech translation of parliamentary debates,” in ICASSP. IEEE, 2020, pp. 8229–8233.
[5] Changhan Wang, Morgane Riviere, Ann Lee, Anne Wu, Chaitanya Talnikar, Daniel Haziza, et al., “VoxPopuli: A large-scale multilingual speech corpus for representation learning, semi-supervised learning and interpretation,” in ACL, Aug. 2021, pp. 993–1003.
[6] Ann Lee, Hongyu Gong, Paul-Ambroise Duquenne, Holger Schwenk, Peng-Jen Chen, Changhan Wang, Sravya Popuri, Juan Pino, Jiatao Gu, and Wei-Ning Hsu, “Textless speech-to-speech translation on real data,” arXiv preprint arXiv:2112.08352, 2021.
[7] Ziqiang Zhang, Long Zhou, Junyi Ao, Shujie Liu, Lirong Dai, Jinyu Li, and Furu Wei, “Speechut: Bridging speech and text with hidden-unit for encoder-decoder based speech-text pre-training,” arXiv preprint arXiv:2210.03730, 2022.
