
 THUsatlab
本文介绍清华大学电子系无线信息系统理论实验室 (WISTlab)和语音与音频技术实验室 (SATlab) 合作的ICASSP 2023录用论文 Unsupervised Anomaly Detection and Localization of Machine Audio: A GAN-based Approach。这篇文章提出AEGAN-AD模型,从Autoencoder异常检测的不足出发,引入额外的Discriminator为Autoencoder提供更语义的梯度,同时提供了新的异常检测角度,提升了整体检测能力。在DCASE 2022异常检测数据集上,AEGAN-AD超过了多种无监督模型。论文全文见文末链接。
01 机器音频异常检测
本文致力于通过机器工作时的音频,判断机器是否正常工作。这项技术在工业生产中将有极大的应用。由于机器异常工作的音频不易采集,异常检测任务的训练集只有正常样本、没有异常样本,模型需要从正常样本中学会正常工作的规律,进而判断待测样本是否满足这种规律。
相比于其它媒介,音频异常检测难度更大。一方面,音频不易表征,不如图像直观;另一方面,机器的工作状态有很多种,并且是时变的,如何将时变的正常工况与异常状态区分开,是音频异常检测的一大难点。
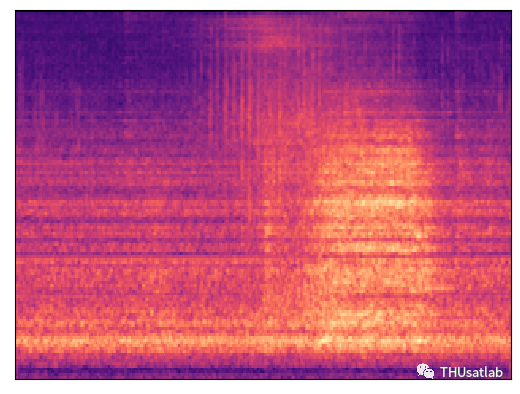
ToyTrain异常工作时的Mel谱
Autoencoder是一种常用的异常检测器。传统的Autoencoder利用均方误差 (MSE) 进行训练,学习去重构样本。仅在正常样本上训练后,Autoencoder对正常样本重构效果好,对异常样本重构效果差,因而根据重构误差即可推断样本性质。
然而我们认为Autoencoder在音频异常检测中还有提升的地方。Autoencoder与PCA具有相同的损失函数、相似的梯度,因而Autoencoder与PCA也有相似的功能:降噪。这意味着重构误差就是噪声,重构误差不能反映出明确的异常区域。
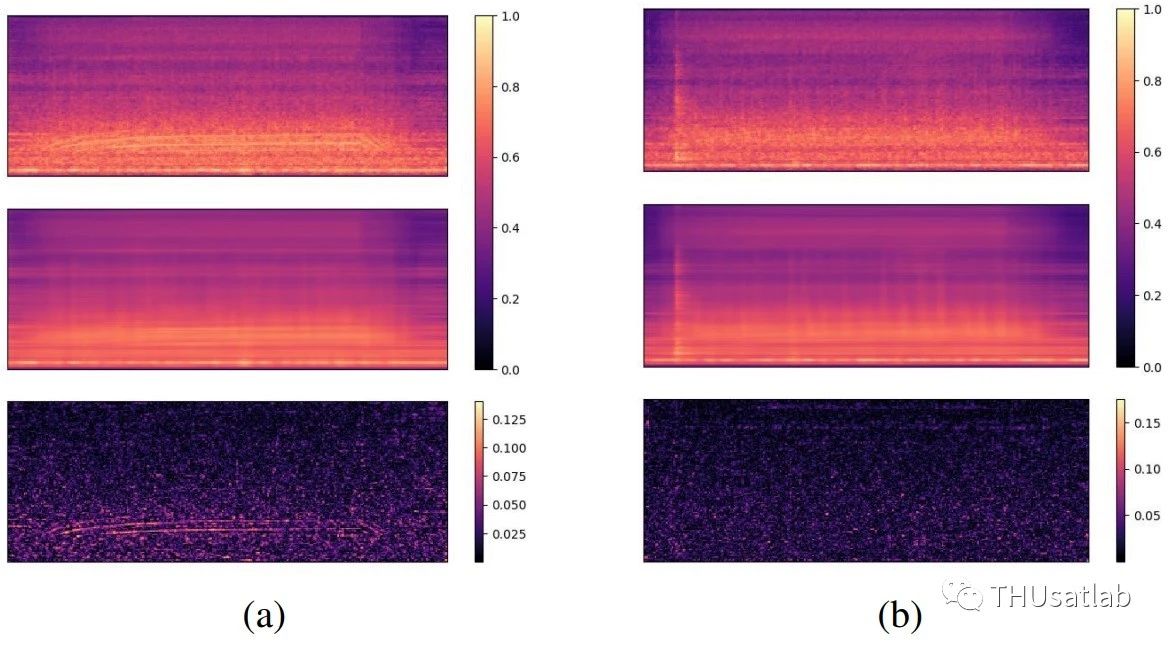
ToyCar异常谱。三行自上而下分别为原始谱、使用AE重构谱、重构误差。仅少部分样本类似 (a) 有明显的异常区域,大部分样本都类似 (b) ,重构误差为噪声
02 AEGAN-AD
为调整Autoencoder降噪的功能、提高整体检测效果,我们提出了AEGAN-AD,其中引入了一个Discriminator来辅助Autoencoder。二者在训练和检测阶段都互为辅助。训练阶段,Discriminator为Autoencoder提供特征层面的梯度,调整重构误差;检测阶段,Autoencoder与Discriminator分别从两个角度进行检测,提升了在不同机器上的泛化能力。
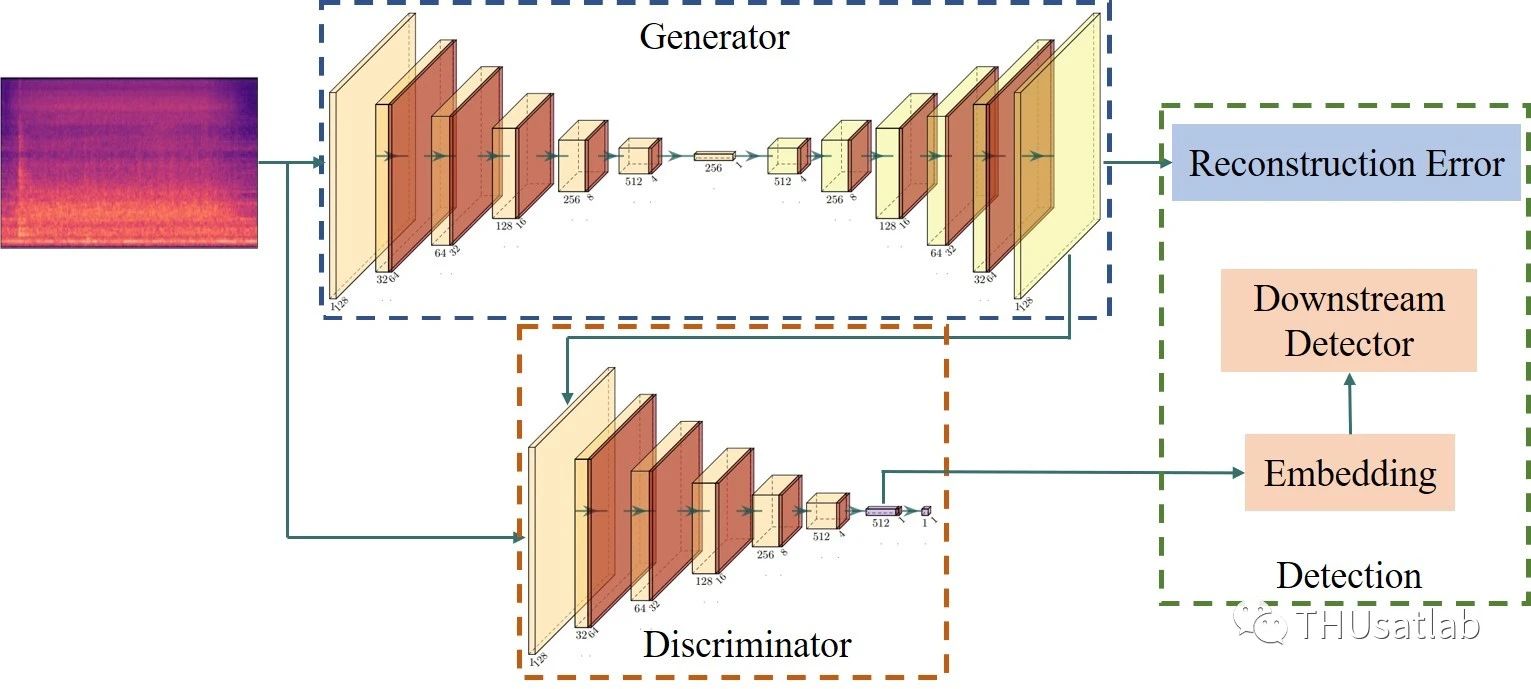
AEGAN-AD模型框架
AEGAN-AD模型中,Autoencoder与Discriminator组成了GAN的模式。Autoencoder也就是传统GAN模型中的Generator。我们采用128维 Mel谱作为音频的表征,这段音频的谱先通过滑动窗切分成128*128的片段,再输入模型中。Autoencoder对Mel谱片段进行重构,Discriminator再组合读入原始Mel谱片段与重构后的Mel谱片段,判断哪个为原始谱、哪个为重构谱。为应对域迁移的影响,网络采用LN,而非常用的BN。
AEGAN-AD按照GAN的模式进行训练。Discriminator的损失函数为WGAN-GP,而Autoencoder的损失函数为MSE + Feature-matching loss。
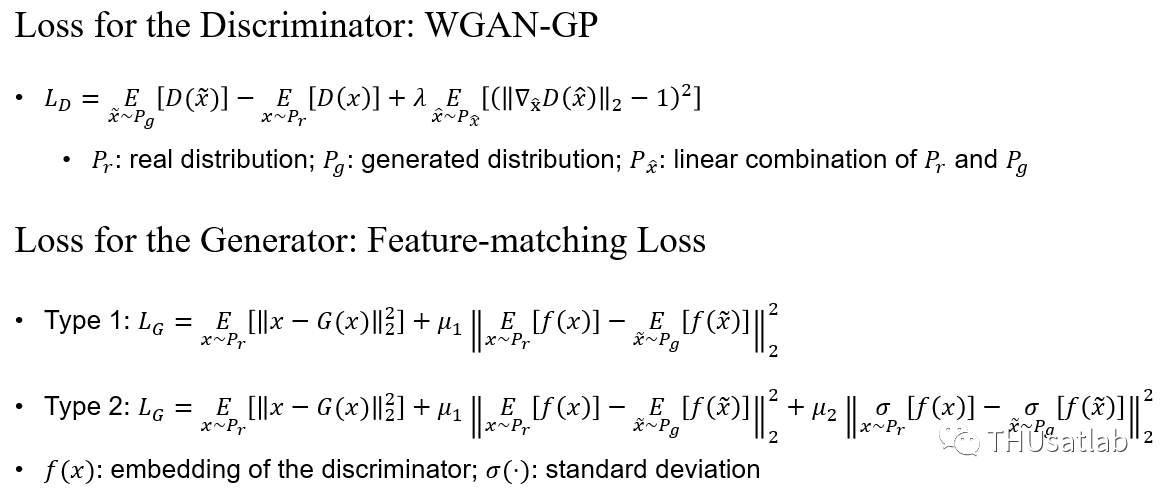
两个网络的损失函数
Feature-matching loss提取了原始谱与重构谱在Discriminator中的embedding,并比较了它们的均值或标准差。Discriminator对重构的Mel谱给出了特征层面的判断,通过feature-matching loss的梯度将特征层面的信息回传给Autoencoder,促使Autoencoder不只在MSE的指导下进行压缩降噪,更在Discriminator的指导下学习谱的特征,这样重构误差就不仅仅是噪声了。
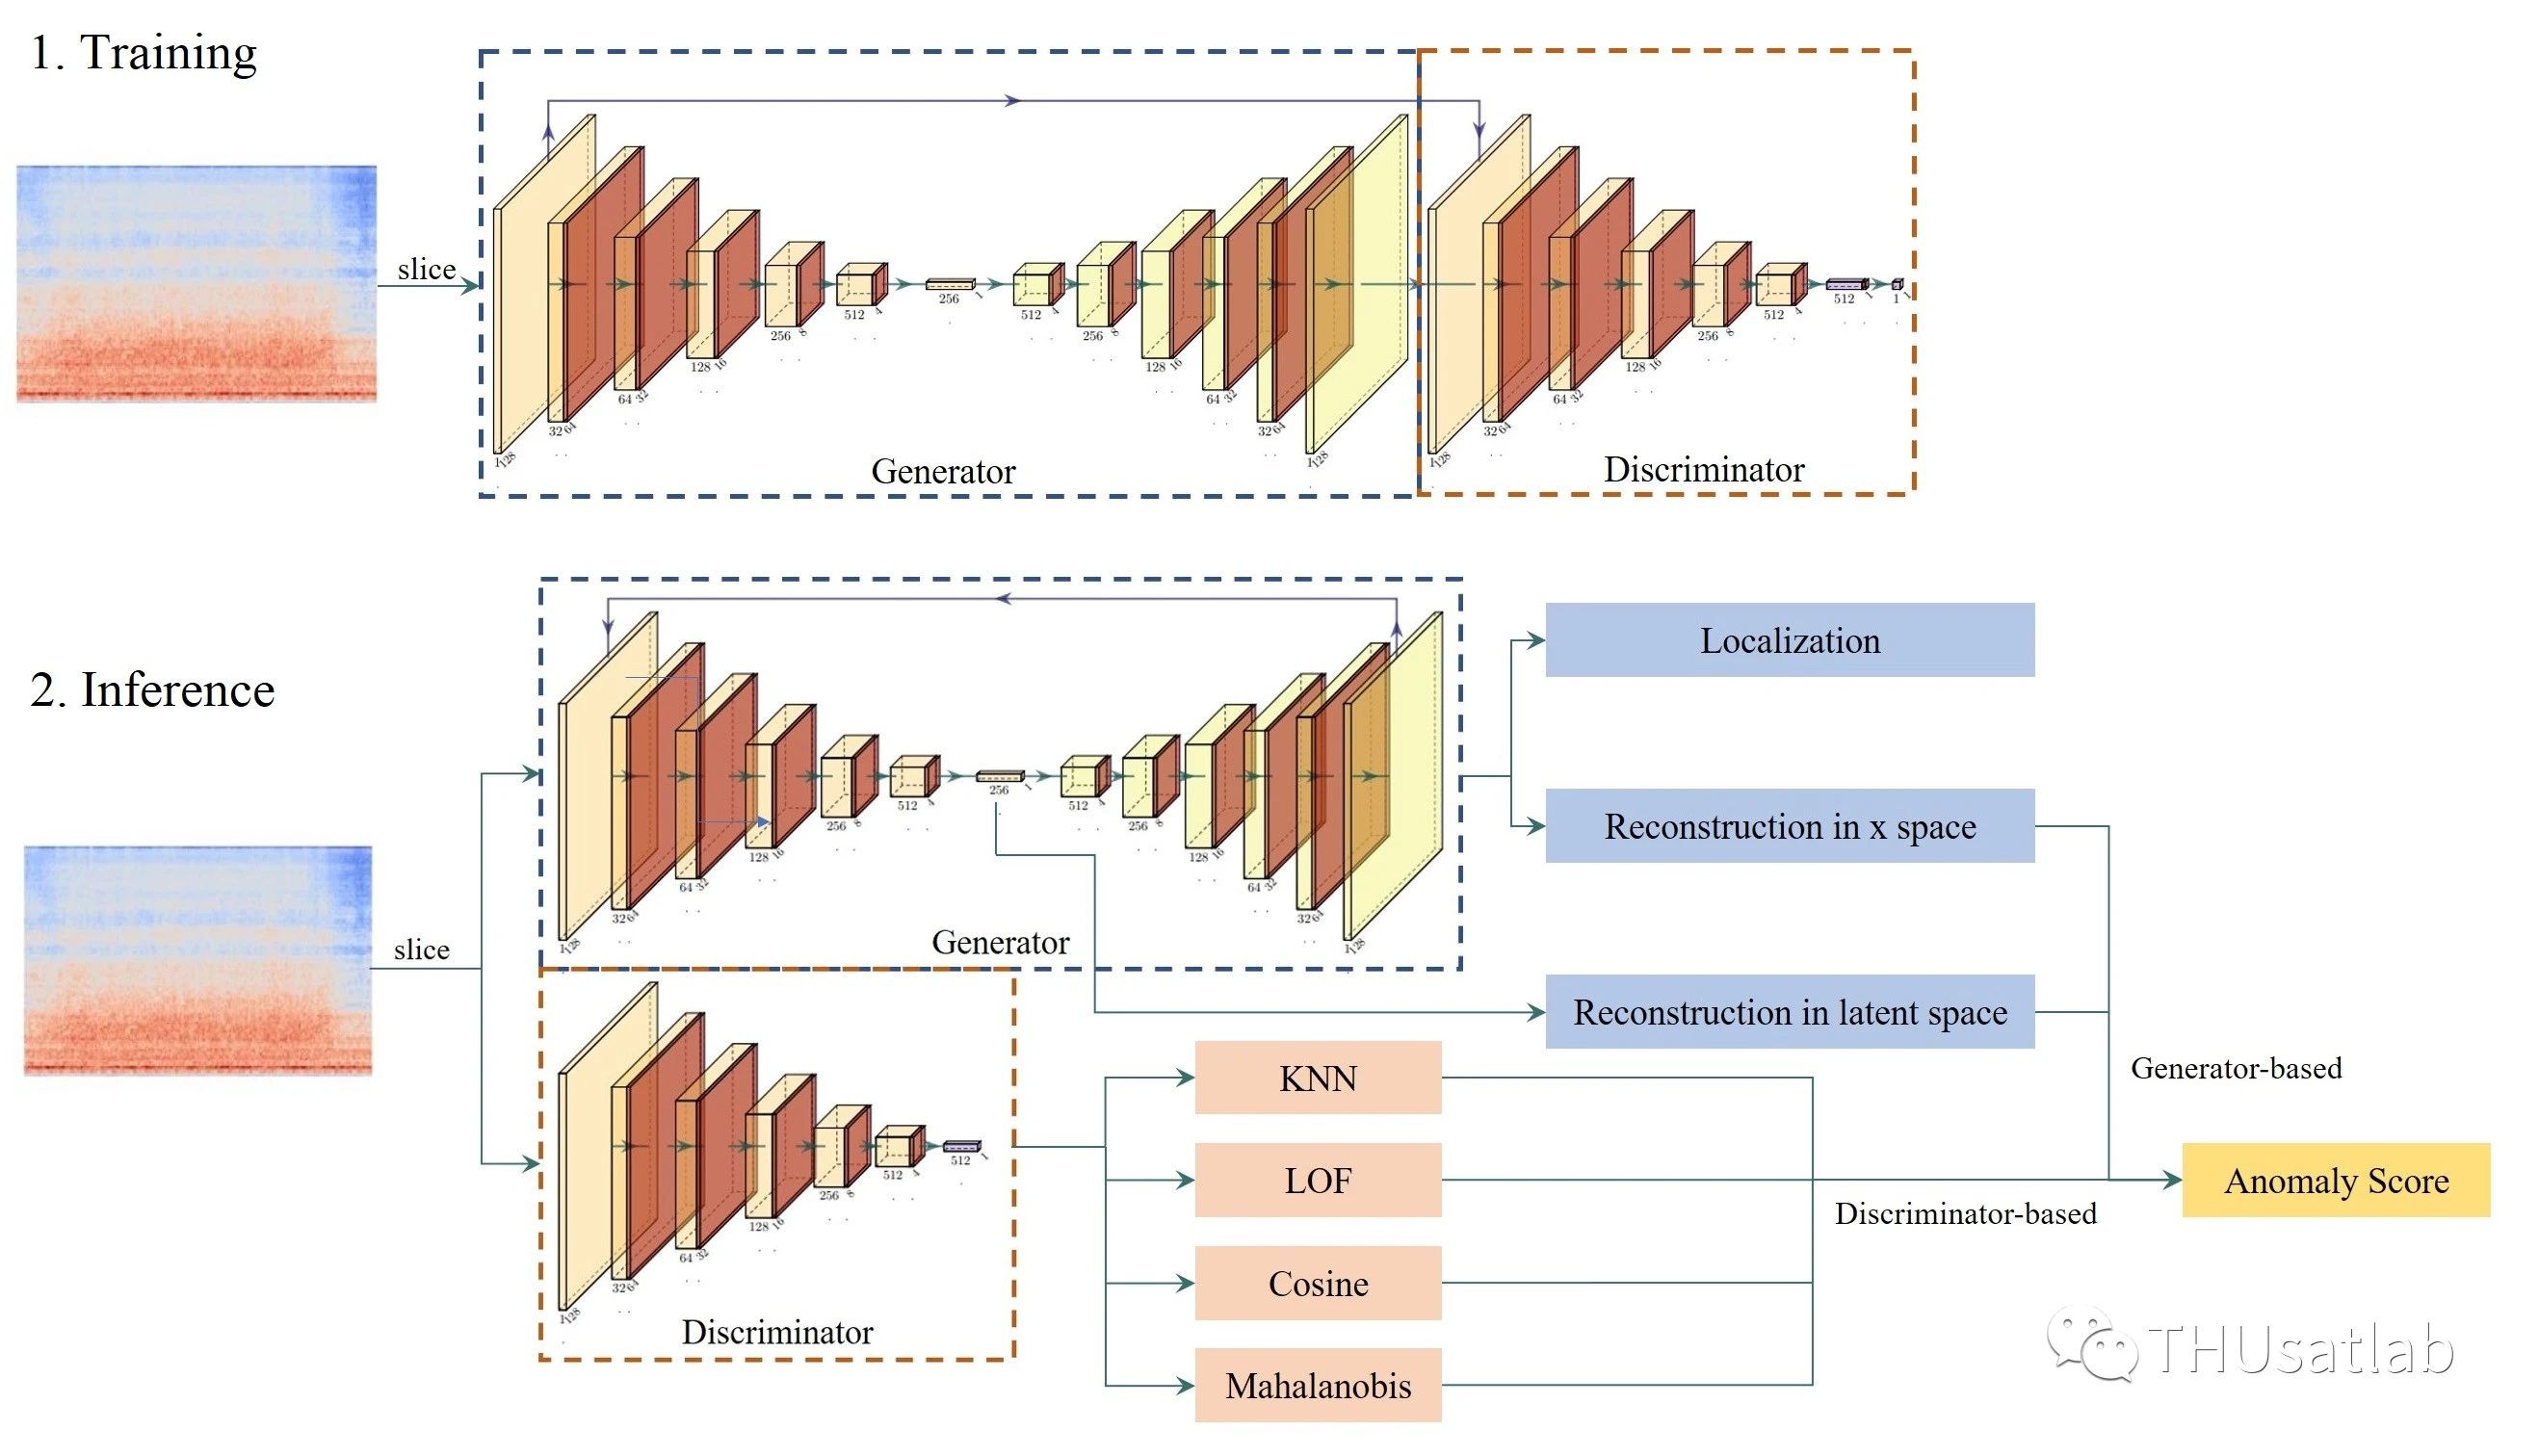
异常检测流程
Autoencoder和Discriminator从两个互补的角度进行检测。Autoencoder的异常分数为谱空间的重构误差和隐空间的重构误差。谱空间的重构误差为1-范数或2-范数,比较了原始Mel谱片段与重构的谱片段。隐空间的误差则将原始片段与重构片段分别送入Autoencoder的encoder中,获得它们在隐空间中的embedding,然后比较了它们的差异,比较方式为1-范数、2-范数和cosine距离。各个片段的异常分数分别取sum/min/max,为整段音频的异常分数。Autoencoder整体上共15种异常分数。
Discriminator首先提取各Mel谱片段的embedding,然后取平均为整段音频的embedding,最后输入多种异常检测器:中心距离检测器,KNN, LOF。中心距离检测器计算待测embedding到平均embedding的距离,作为异常分数;KNN计算待测embedding到最近的k个正常音频的embedding的距离,作为异常分数。LOF利用KNN估计embedding的局部密度,使用密度作为异常分数。
两种网络共有19种异常分数,每种机器选择最优的异常分数。
03 实验结果
我们在DCASE 2022 Task 2异常检测数据集上进行了训练与测试。我们选取了2个官方baseline、2个GAN baseline和22年竞赛中前15名中3种无监督模型。衡量标准基于AUC。
数据集中存在域迁移的问题,即训练集大部分采集于源域 (source domain),少部分采集于目标域 (target domain)。
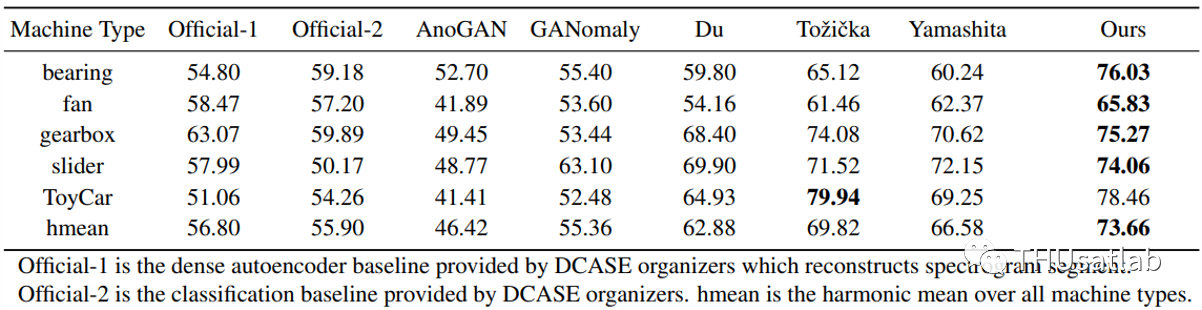
表1 实验结果
表1对比了各模型在5种机器上的实验结果。AEGAN-AD整体上有着3.84%的提升,其中在bearing机器上的提升最大,达到了10.91%。
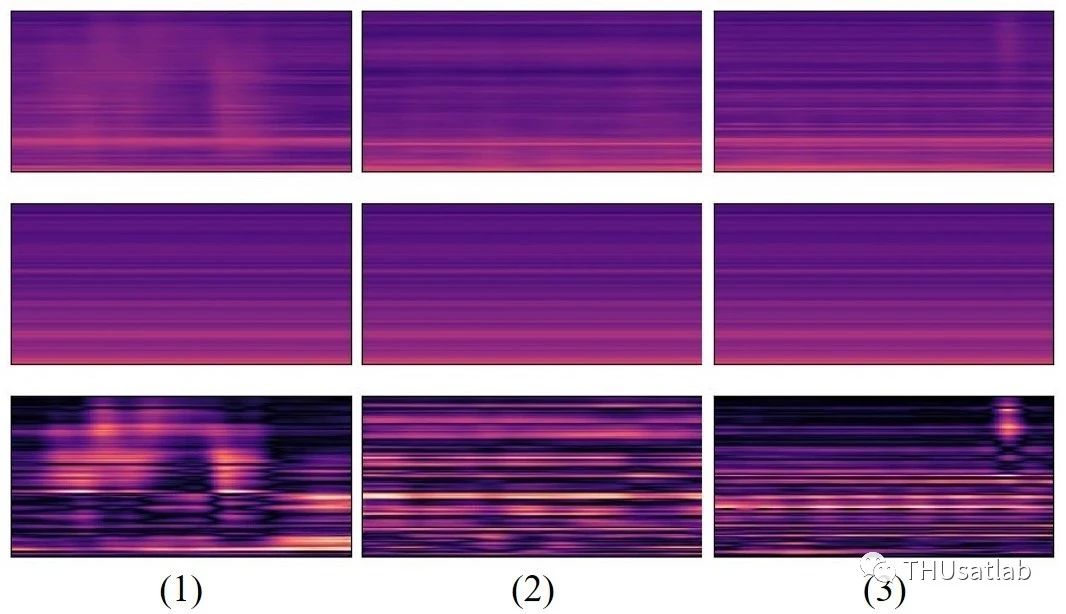
bearing重构误差。第1行是重构结果,第2行是谱的平均,第3行是重构误差
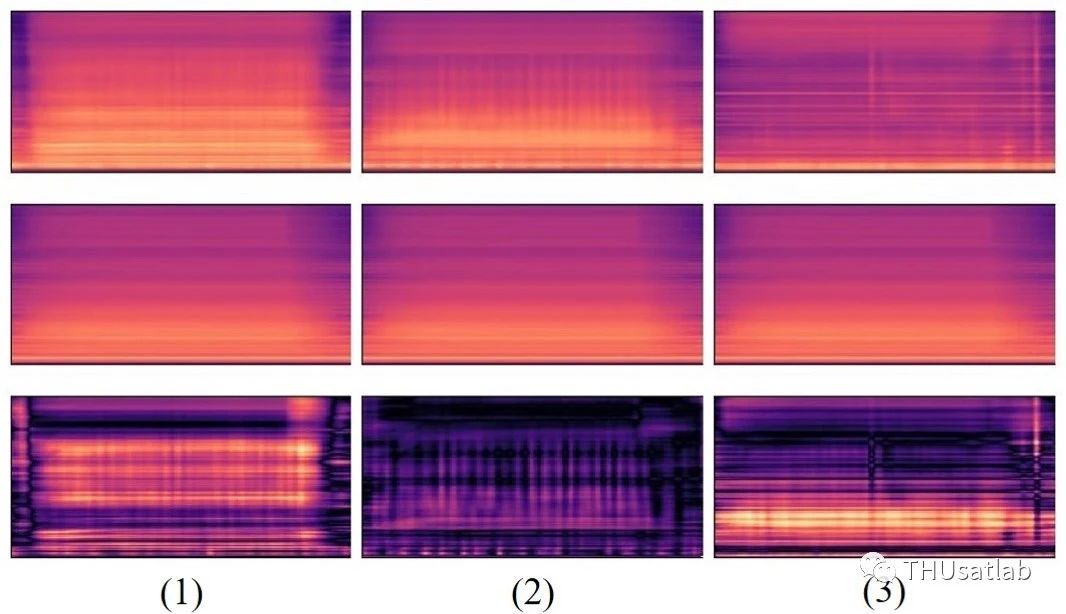
ToyCar重构误差。第1行是重构结果,第2行是谱的平均,第3行是重构误差
我们也重新查看了重构误差。此时有异常的区域能被标出,重构误差已不仅仅为噪声。
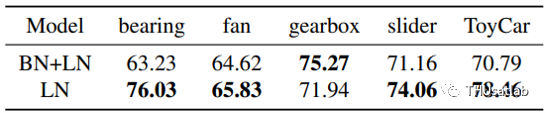
表2 消融实验
我们还对比了不同归一化函数的作用。我们对比了全LN的模型,与LN和BN的混合模型(WGAN-GP要求D网络必须为LN)。整体而言LN要比BN更优,但对于域间差异小的机器 (gearbox),BN更优。
此外,我们还可视化了域间差异。我们提取了LN层用于归一化的统计量,然后使用T-SNE进行可视化,如下:
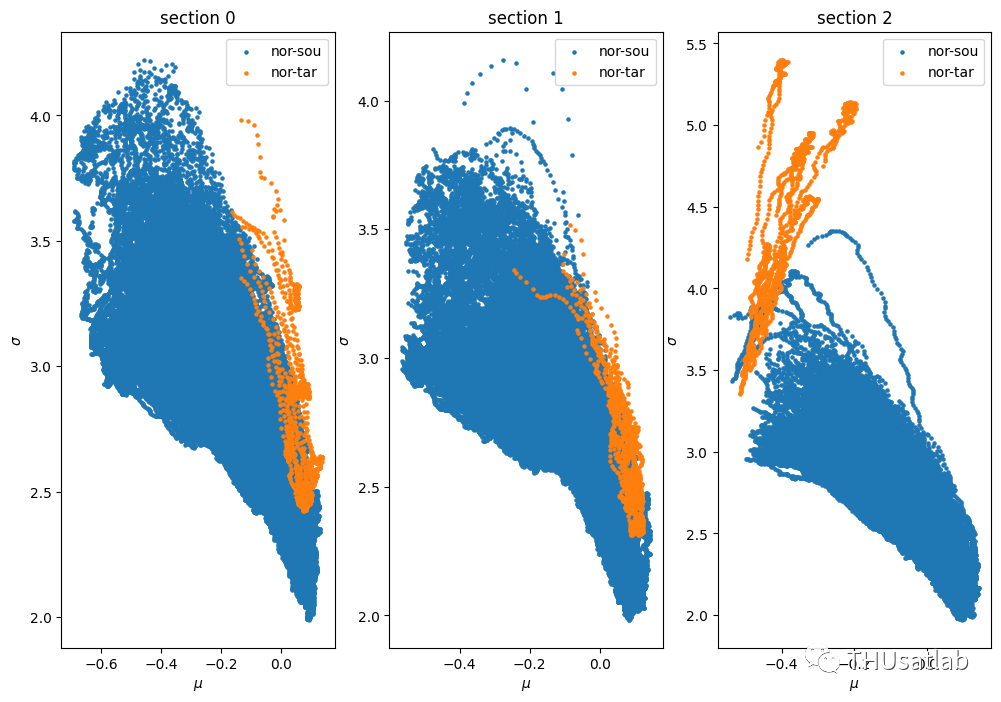
训练集所有样本。蓝色为正常-源域,黄色为正常-目标域
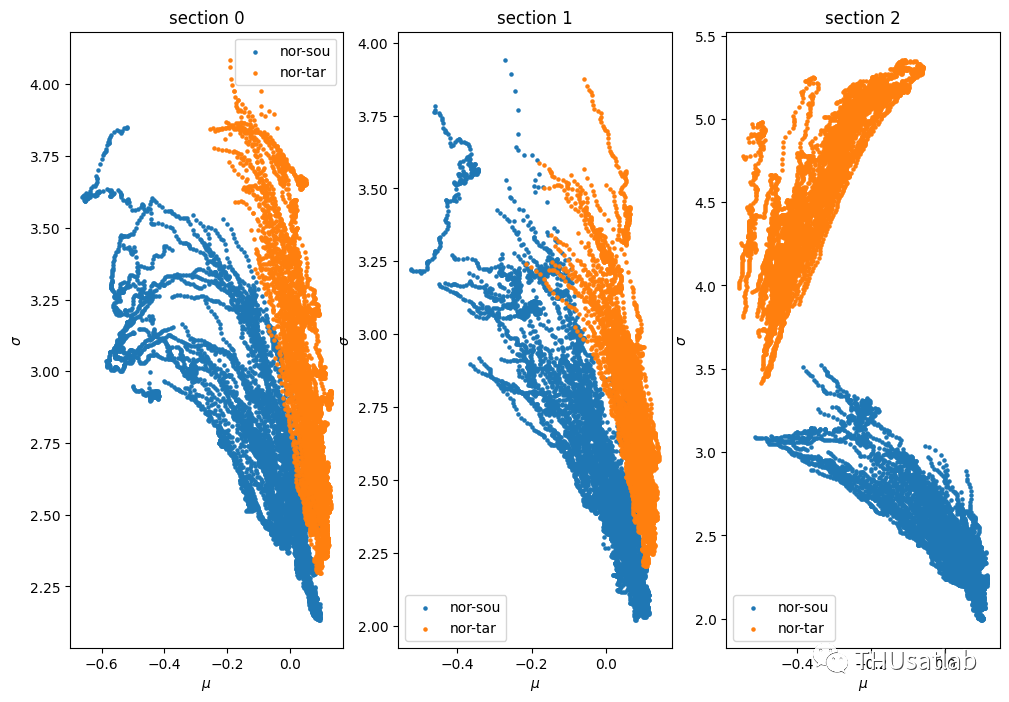
测试集正常样本。蓝色为正常-源域,黄色为正常-目标域
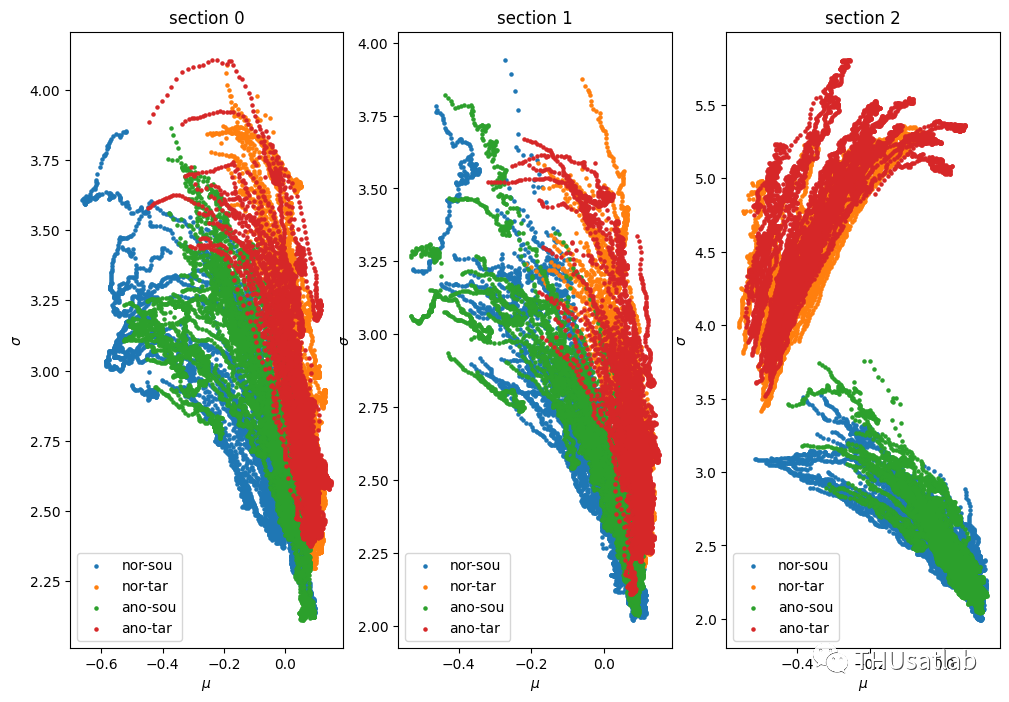
测试集所有样本。蓝色为正常-源域,黄色为正常-目标域,绿色为异常-源域,红色为异常-目标域
对比训练集与测试集的正常样本,我们很难从训练集中推导出目标域的分布,导致检测出现偏差;对比测试集的正常样本与异常样本,域之间的差异要大于正常/异常的差异。
在本文中,我们认为Autoencoder的降噪特点抑制了异常检测性能,故引入了1个Discriminator为Autoencoder提供特征层面的指导,2个网络按照GAN的模式进行训练,并从2个互补的角度进行检测。AEGAN-AD在DCASE 22的5个机器上取得了最好的结果。加入Discriminator后,重构误差更能反映谱的特征。同时我们发现LN比BN更适合应对域迁移。
