 THUsatlab
随着人工智能的发展,语音识别技术取得了长足的进步。其中,自监督预训练的语音模型因其强大的性能和鲁棒性,成为该领域的研究热点之一。然而,这些模型通常具有大量的参数,导致计算资源消耗巨大,限制了它们在许多实际应用场景中的使用。
本文介绍清华大学语音与音频技术实验室(SATLab)在信号处理领域旗舰期刊IEEE Journal of Selected Topics in Signal Processing (JSTSP)上预先出版的论文Unstructured Pruning and Low Rank Factorisation of Self-Supervised Pre-Trained Speech Models。这篇论文提出了一种对无监督预训练语音大模型进行压缩的新方法,通过结合非结构化剪枝和截断奇异值分解来实现硬件通用性好、压缩损失小的模型压缩,在语音识别任务上实现了大幅优于蒸馏和结构化剪枝基线方法的性能。
背景:非结构化与结构化剪枝
以HuBERT、WavLM为代表的无监督语音预训练模型具有很强的表征能力和稳健性,仅需少量有标注数据微调就能在各类语音任务上取得良好的表现。不过,这类模型参数量通常较大,难以运行在各类算力受限的可移动设备上,这限制了它们在许多实际场景中的应用。因此,对这类语音预训练模型进行压缩有着重要的意义。
模型剪枝是语音预训练模型压缩的重要方法之一。通过移除网络中不重要的参数,模型剪枝可以削减网络的参数量,实现减少存储压力、加速计算的目的。根据剪枝的最小单元的不同,模型剪枝方法可以划分为非结构化剪枝和结构化剪枝。其中,非结构化剪枝以一个个单独的参数作为独立的剪枝单元,而结构化剪枝则以连续的参数组,例如矩阵的行或列为最小单元。
主要方法:结合剪枝和矩阵分解
非结构化剪枝得到的稀疏矩阵有可能具有低秩性。一些理论研究表明,矩阵的稀疏度会影响矩阵秩的上界。
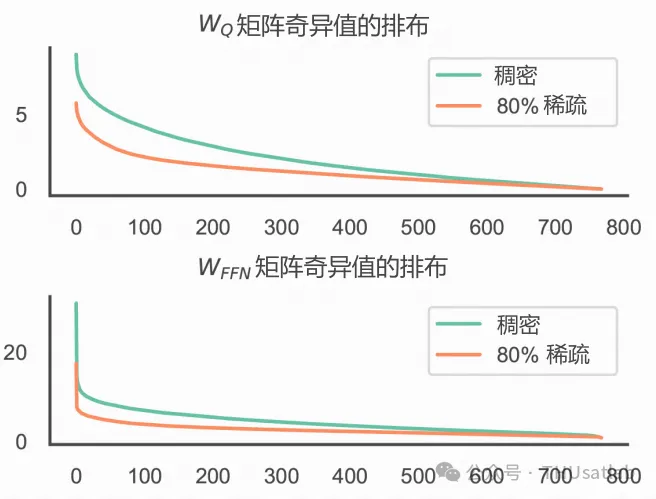
稀疏/稠密HuBERT模型中矩阵奇异值的排布
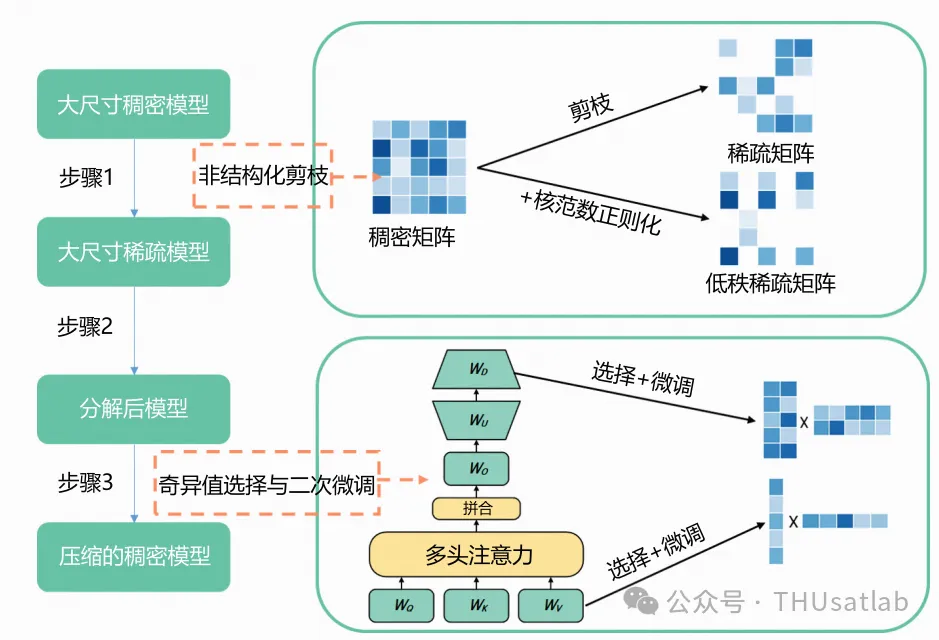
文章方法的概览。此方法主要分三个步骤:(1)先通过非结构化剪枝得到稀疏模型(2)进行截断的奇异值分解(3)通过二次微调获得压缩的稠密模型。核范数正则化和可学习奇异值分解有助于更好地利用稀疏模型中潜在的低秩性
核范数正则化
核范数是矩阵秩的最优凸近似,定义为矩阵奇异值之和。我们观察到,在剪枝训练后期,随着模型的稀疏度逐渐稳定,识别率不断增强,模型的核范数在训练过程中呈现上升趋势。
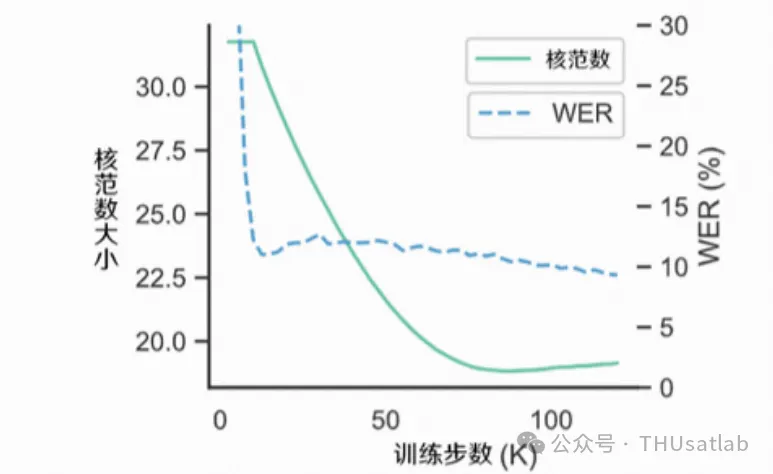
稀疏/稠密HuBERT模型中矩阵奇异值的排布
可学习的奇异值选择策略
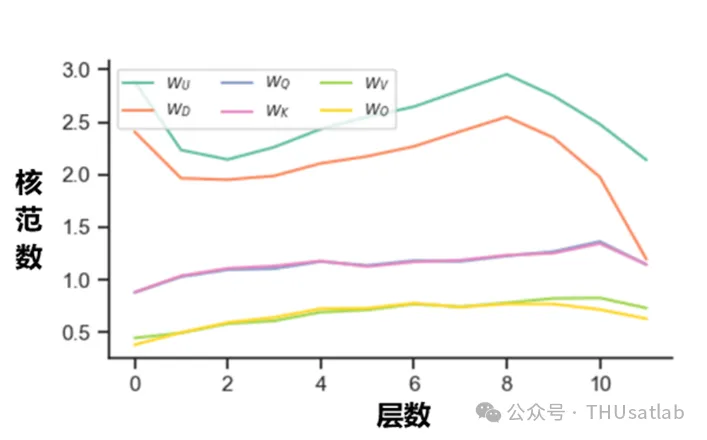
稀疏HuBERT模型中各层矩阵的奇异值
实验结果概览
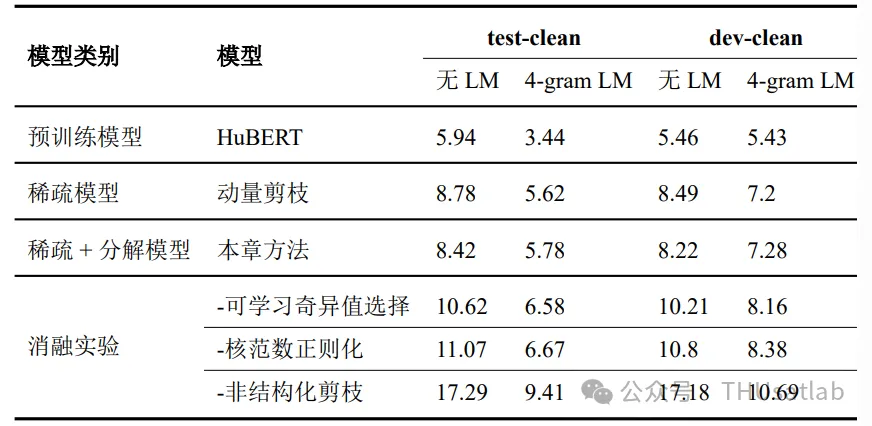
提出的方法在语音识别(ASR)任务上的表现
提出的方法在关键词检测(KWS)、意图识别(IC)和说话人日志化(SD)任务上的表现
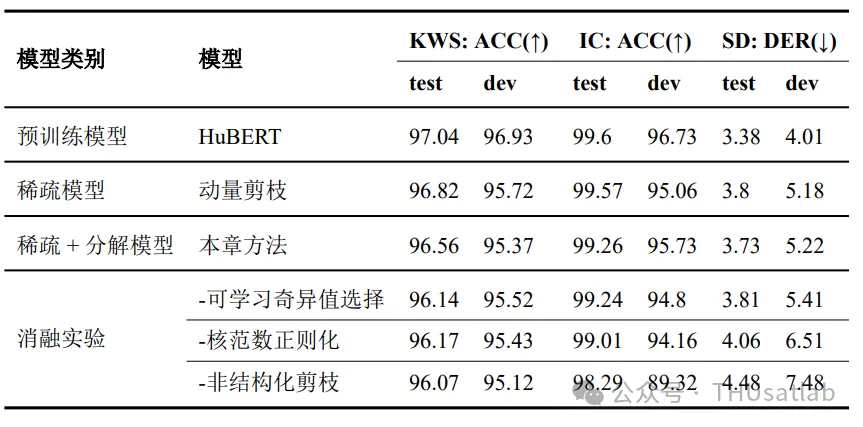
与蒸馏和剪枝基线模型的对比
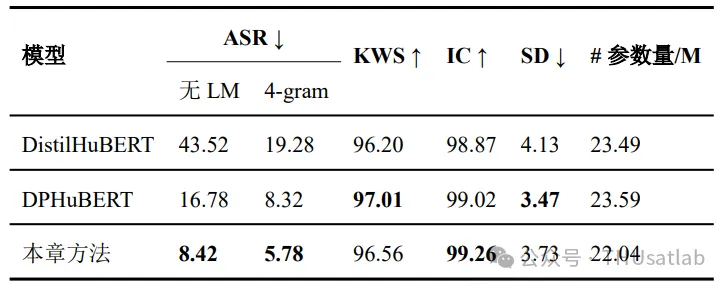
这篇文章关注到非结构化稀疏模型的低秩特性,并提出使用截断的奇异值分解将之转换为参数量更少的稠密模型。通过可学习的奇异值选择策略和核范数正则化方法,我们可在几乎不产生性能损失的情况下实现这一转换,兼顾了压缩模型的性能与硬件通用性。