
 西工大音频语音与语言处理研究组
这段对话是开周会的时候子谦同学用谢老师的音色和谢老师对话。。。。
论文题目:DualVC: Dual-mode Voice Conversion using Intra-model Knowledge Distillation and Hybrid Predictive Coding
作者列表:宁子谦,姜月鹏,朱鹏程,姚继珣,王帅,谢磊,毕梦霄
合作单位:网易伏羲、上交大
论文网址:https://arxiv.org/abs/2305.12425
Demo网址:https://dualvc.github.io/
图1 发表论文截图
图2 扫码直接看论文
语音转换(Voice Conversion, VC)是一种在不改变语言信息的同时改变说话人音色的技术[1]。虽然当前主流VC模型展示出了出色的转换质量,但它们需要整句或整段语音作为输入,无法应用于实时应用场景。相比之下,尽管流式VC模型得到了越来越广泛的研究,但与非流式模型相比,其转换效果仍然不足。这主要是相比于整句音频输入,模型无法获取到足够的未来信息,信息缺失导致了转换效果下降,具体表现为可懂度低、音质差和说话人相似度低。
针对以上问题,本文提出了DualVC,一种双模VC模型,一个模型同时支持流式和非流式推理。我们采用双模卷积,将非流式教师模型和流式学生模型统一为一个模型联合优化。此外,我们引入了混合预测编码(hybrid predictive coding, HPC),以补偿流式模式下未来信息的缺失。HPC结合了对比和自回归预测编码方法,使编码器在未来信息缺失的情况下学习更鲁棒的特征结构。最后,为了缓解缺失未来信息的长句推理中的错误积累问题,我们对输入的梅尔谱和自回归模块的梯度都引入了噪声来提升鲁棒性。实验表明,DualVC流式模式的效果优于基线系统,并且实现了与非流式顶配系统接近的转换质量,而延迟仅有252.8毫秒。
如图3所示,DualVC基于识别-合成框架,包括一个编码器、一个HPC模块和一个解码器。首先,预训练的ASR模型的编码器从输入频谱中提取瓶颈特征(BNF)。随后BNF传入编码器以进一步提取上下文信息。HPC模块只在训练阶段使用,有助于编码器通过无监督的学习方法提取更有效的隐层表示。随后,目标说话人嵌入被拼接到隐层表示中,并作为输入提供给解码器。最后,解码器生成转换后的频谱。
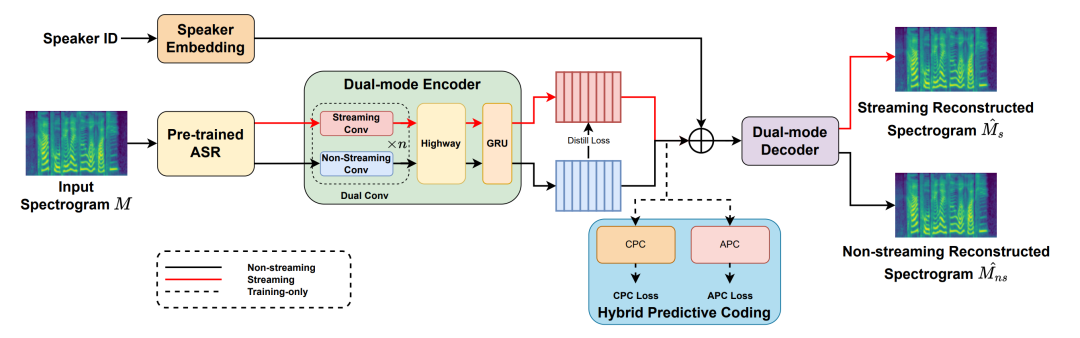
图3 DualVC 模型结构
流式结构
DualVC的基础模型是CBHG-AR[2],它由一个CBHG编码器和一个自回归(AR)解码器组成。为了实现流式推理,任何依赖未来信息的模块都必须进行修改或替换。具体而言,双向GRU和卷积层分别被替换为单向GRU和因果卷积层。在典型的卷积神经网络中,padding被添加到输入的两边以确保输入和输出特征的长度相等。因此卷积核能够在其感受野中同时获取历史、当前和未来信息。而在流式推理过程中,未来的信息无法获取,因此所有的padding都移到输入的左侧,此时卷积感受野中不涉及未来的信息,成为一个因果卷积。通过单向的GRU层,模型可以在不依赖任何未来信息的情况下进行推理,只接受当前帧和上一个隐层状态作为输入。
双模卷积
在本文提出的模型中,我们改进了深度可分离卷积(depthwise separable convolution)作为基本卷积层,其中深度卷积层被夹在两个点状卷积层之间,然后在最后是一个dropout层。双模卷积块由两个平行的基本卷积层组成,其中一个是流式的因果卷积,另一个是非流式的非因果卷积。基础模型中的所有卷积层都被双模卷积块取代,在训练过程中我们分别使用两种模式对模型进行推理。为了使流式中间表征更接近非流式,我们计算流式编码器输出 和非流式编码器输出
 之间的损失。由于这两种模式是一起训练的,而不依赖于预训练的教师模型,我们把这个过程称为模型内知识蒸馏。知识蒸馏损失被表述为
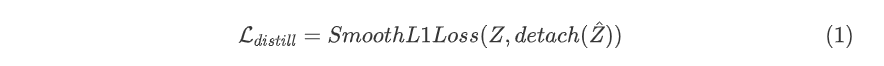
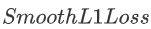 是Fast R-CNN[3]中提出的
 损失的平滑版本。
双模卷积不仅允许模型同时用于流式和非流式场景,而且通过在训练期间使用非流式卷积的输出作为指导,增强了流式卷积的性能。
混合预测编码
除了使用双模卷积与模型内知识蒸馏外,我们希望进一步加强CBHG编码器提取的隐层表征质量表示来进一步提高转换效果。因此,我们提出了结合对比预测编码(CPC)[4]和自回归预测编码(APC)[5]的混合预测编码模块(HPC)。
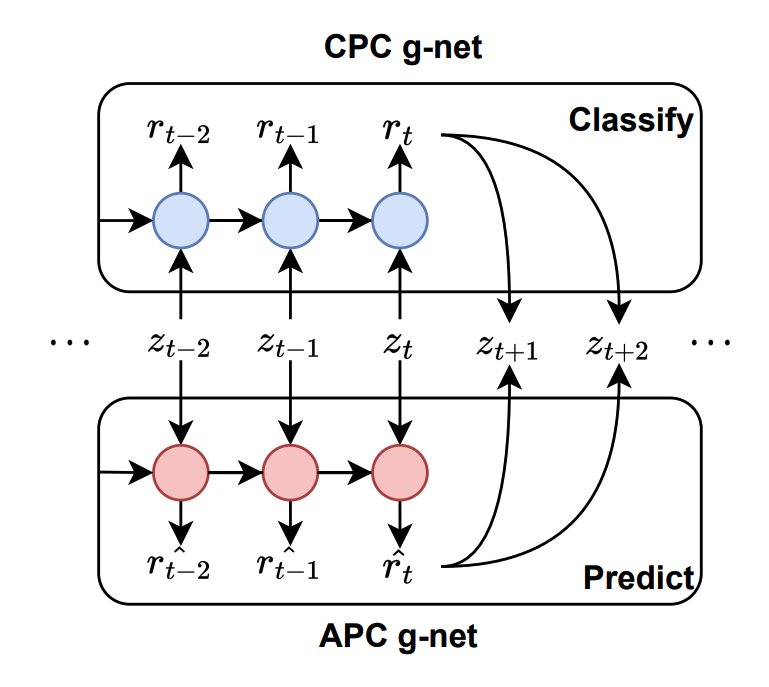
图4 混合预测编码模块
CPC使用自回归的g-net从特征序列
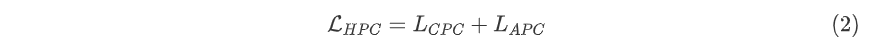
噪声鲁棒解码器
基于自回归的模型结构会存在错误累积的问题,我们发现在流式场景下此问题尤为严重。而流式转换可以看作有无限的输入长度,因此提升自回归解码器鲁棒性尤其重要。针对这一问题,本文提出了一种合了输入特征扰动和梯度扰动的数据增强方法,以减少实际推理中输入的低质量梅尔谱和训练中使用的高质量真实梅尔谱之间的不匹配。通过在AR的真实输入中加入正态分布的噪声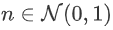 ,来模拟实际推理中生成的具有瑕疵的谱。同时在训练过程中,为了进一步提高鲁棒性,我们在AR模块的梯度中加入了
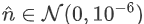 的噪声。
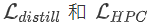 ,以及表示重建损失的

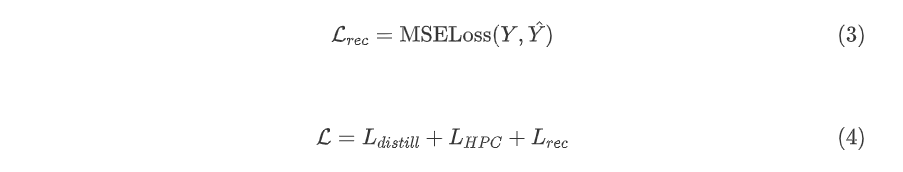
实验数据:内部中文数据集,包含来自20个说话人的两万条语音。
对比系统
Topline:基础非流式模型
Bottomline:基础模型直接修改结构为非因果实现流式
IBF-VC[6]:预训练教师模型指导学习的流式模型,使用中间层表征
DualVC:本文方案
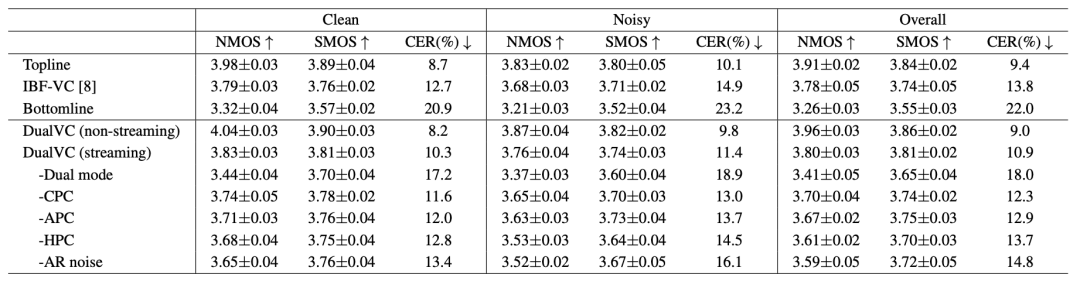
表1 语音自然度和说话人相似度主观测试结果(MOS)与词错误率 (CER)
主观测试
从表1可以看出,流式 DualVC 在自然度与说话人相似度上都超越了Baseline系统,并能接近Topline的效果。同时非流式DualVC超越了非流式Topline,证明了HPC的有效性。并且DualVC在噪声场景下各项指标并未过多下降,证明了其鲁棒性。
客观测试
词错误率:使用语音识别模型分别对于各个模型生成的语音进行识别并计算词错误率。与主观测试结论相同,在流式场景下,DualVC全面超越了baseline,同时非流式下也超越了baseline模型。
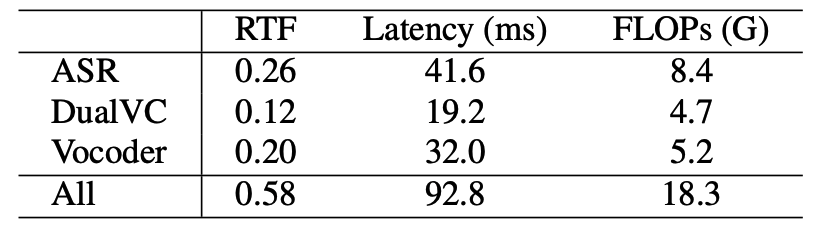
计算效率:我们考虑了三个主要指标:实时性(RTF)、延迟和浮点运算数(FLOPs),结果如表2所示。模型整条链路RTF为0.58,计算量为18.3 FLOPs。延迟计算公式为
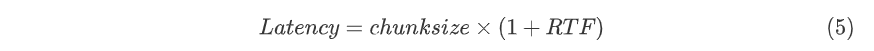
干净输入语音
输入语音
非流式转换结果
流式转换结果
带噪输入语音
输入语音
非流式转换结果
流式转换结果
更多样例:https://dualvc.github.io/
实时语音转换在网易雷火游戏中有着很多应用,欢迎关注网易游戏。
声明:我们意识到实时语音转换在RTC应用中有被不法分子利用的风险,因此坚决反对技术滥用,同时实验室也致力于对仿冒语音进行检测的研究,后续相关技术分享敬请期待。
参考文献
[1] B. Sisman, J. Yamagishi, S. King, and H. Li, “An overview of voice conversion and its challenges: From statistical modeling to deep learning,” IEEE ACM Trans. Audio Speech Lang. Process., vol. 29, pp. 132–157, 2021.
[2] X. Tian, Z. Wang, S. Yang, X. Zhou, H. Du, Y. Zhou, M. Zhang, K. Zhou, B. Sisman, L. Xie et al., “The NUS & NWPU system for voice conversion challenge 2020,” in Proc. Joint Workshop for the Blizzard Challenge and Voice Conversion Challenge 2020, 2020, pp. 170–174.
[3] S. Ren, K. He, R. Girshick, and J. Sun, “Faster r-cnn: Towards real-time object detection with region proposal networks,” in Advances in Neural Information Processing Systems, vol. 28. Curran Associates, Inc., 2015.
[4] A. van den Oord, Y. Li, and O. Vinyals, “Representation learning with contrastive predictive coding,” CoRR, vol. abs/1807.03748, 2018.
[5] Y. Chung, W. Hsu, H. Tang, and J. R. Glass, “An unsupervised autoregressive model for speech representation learning,” in Proc. INTERSPEECH. ISCA, 2019, pp. 146–150.
[6] Y. Chen, M. Tu, T. Li, X. Li, Q. Kong, J. Li, Z. Wang, Q. Tian, Y. Wang, and Y. Wang, “Streaming voice conversion via intermediate bottleneck features and non-streaming teacher guidance,” CoRR, vol. abs/2210.15158, 2022
