
 西工大音频语音与语言处理研究组
图1 发表论文截图
图2 扫码直通论文
近年来,由于深度神经网络的快速发展,端到端语音识别(ASR)系统取得了显著的进展,并成为语音识别的主流方法。然而,由于深度学习高度依赖数据,端到端 ASR 系统对于数据中的罕见短语的识别准确度往往会显著降低。在实际应用中,这些罕见短语通常可以事先作为语境(context)信息即“热词”获得。因此,将语境知识融入端到端ASR模型以提高对热词的识别能力十分重要。
一种典型的偏置方法是浅融合 (shallow fusion)[1]。虽然浅融合可以直观地增加与热词相关的令牌的后验概率,但对于偏置列表的性能改进有限,并且需要进行测试以确定最佳融合权重。
实现上语境偏置的另一种方法是基于神经网络的深度偏置方法 (deep biasing)[2, 3],它在端到端神经网络模型中引入了一个独立的偏置组件来建模热词。与浅融合相比,深度偏置方法更灵活,可以快速适应不同场景中的不同热词列表。然而之前的深度偏置方法缺乏偏置任务的明确监督,并且通常只适用于特定的模型结构。
为此,我们提出了一种基于热词预测网络的深度偏置方法,该方法使用基于双向长短时记忆网络(BLSTM)的热词编码器来获取热词的嵌入,并通过注意力机制提取语境信息与音频嵌入结合。与 CLAS [2] 和 CATT [3]不同,我们使用热词预测网络来预测话语中出现的需要偏置的热词,并将结果与仅包含热词的标签计算CTC损失作为偏置损失。这个损失函数有效的监督了偏置模块去学习关注音频中出现的热词,并在无热词时减少对原本识别结果的影响。热词预测网络可以集成到主流的端到端语音识别模型中,如 CTC 、AED 和 Transducer,以实现对热词的偏置。
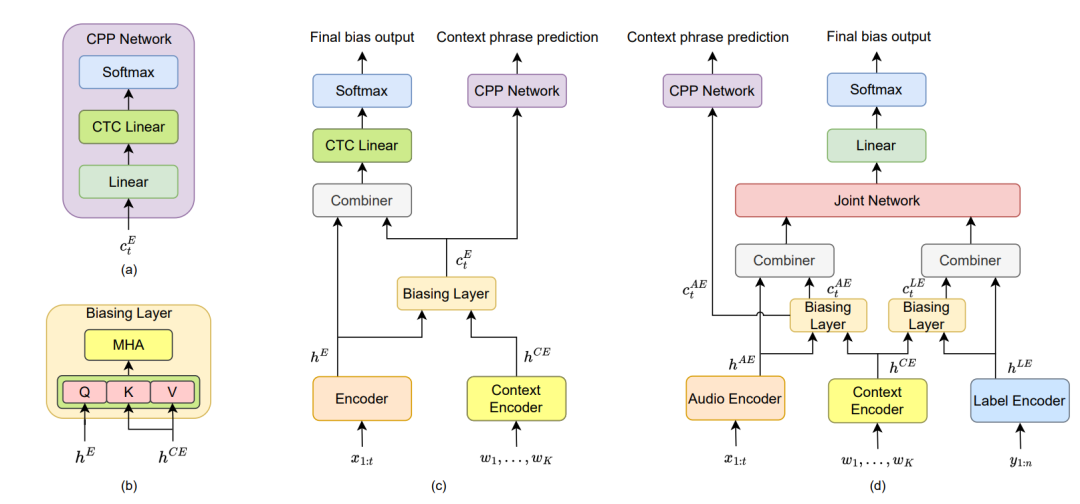
图3 语境(热词)偏置模型结构
热词偏置CTC/AED模型
对于热词偏置 CTC 和 AED 模型,我们都仅对编码器进行了修改,并且在训练 AED 模型的时候使用 CTC 损失进行作为辅助损失,因此对这两个模型的修改是基本一致的。我们在模型中添加了一个热词编码器、一个基于多头注意力的偏置层,以及一个热词预测网络,如图 3(c) 所示。
热词编码器用于将偏置列表中不同长度的热词编码成具有相同长度的嵌入向量。列表中的每个短语都使用与ASR模型相同的分词器进行分词,将分词后的序列作为 BLSTM 的输入。正向和反向 LSTM 的最后一个时间步的隐藏状态和细胞状态进行拼接,然后通过一个线性层得到热词短语的嵌入向量 。此外,我们在热词短语列表中添加了一个只包含单个空白字符的短语,以便在音频中没有热词短语时模型能够专注于它并忽略其他热词短语。
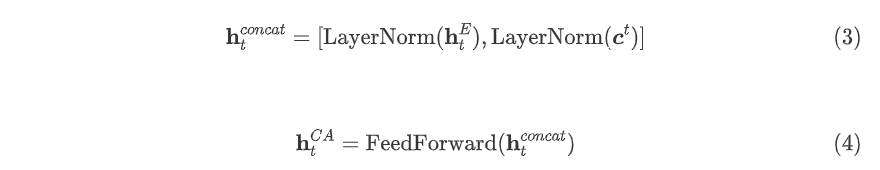
偏置层是一个多头注意力层,旨在帮助模型学习热词短语的嵌入和话语间的相关性,如图 3(b) 所示。偏置层以音频嵌入 作为查询,热词短语嵌入
 作为键和值,以计算热词表示
 :
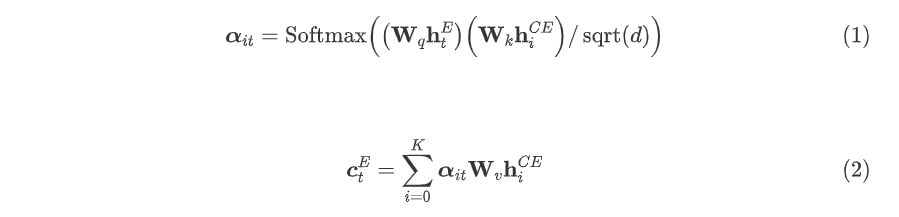
 :
 作为输入,预测话语中出现的热词短语。我们将热词短语预测网络的输出作为后验,抄本中的热词短语作为标签,使用 CTC 损失函数计算模型的偏置损失。该部分模型只用于辅助训练,不参加模型的推理。
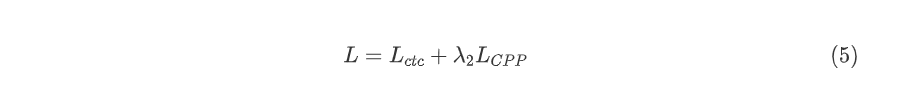
 为偏置损失的权重,在实验中我们均设置为 0.1。
 作为 CTC 权重,最终的损失函数为:
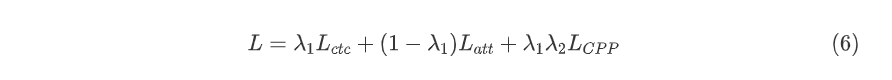
热词偏置Transducer模型
热词偏置 Transducer 模型的结构如图 3(d) 所示。相比于标准 Transducer 模型,我们添加了一个热词编码器,两个偏置层,以及热词短语预测网络。与 CTC/AED 模型不同的是,我们在音频编码器和标签编码器后面都添加了偏置层,以将热词信息分别集成到音频编码器和标签编码器中,然后将热词感知音频嵌入与热词感知标签嵌入送入到联合网络中进行后续的计算。
热词偏置Transducer模型的最终的损失函数为:
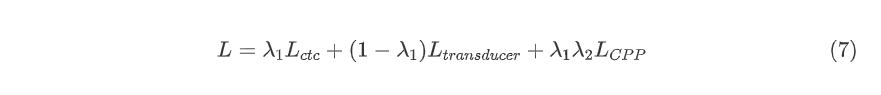
热词短语筛选方法
受[4]的启发,我们应用了两阶段的热词短语筛选算法,使用 CTC 的后验来筛选热词短语。不同的是,我们简化了级联编码器的结构,在不改变原始模型结构的情况下执行热词短语筛选。
首先,使用仅包含空白字符短语的偏置列表进行计算,以获得无偏置的 CTC 后验。保留音频嵌入 。在第一次通过推理期间,CTC 的解码结果可以用作流式处理结果。
然后使用 CTC 后验分两个阶段过滤热词短语。第一阶段计算后验和分数置信度 ,忽略热词短语的顺序。它计算滑动窗口中热词短语中包含的每个字符的最大后验值的总和,并使用序列长度对其进行规范化。此阶段会筛选掉大多数与音频相关性较低的热词短语,仅保留剩余的热词短语用于第二阶段的过滤。在第二阶段,通过使用动态规划算法计算序列顺序置信度,考虑令牌顺序,计算滑动窗口中热词短语中包含的字符的最大后验和。
实验数据与实验配置
本文大多数实验都是在LibriSpeech语料库上进行的,其中包括 960 小时的英语有声读物阅读。该模型在完整的 960 小时训练数据上进行训练,以证明其在相对低资源的任务中的性能。利用 [5] 中提供的 LibriSpeech 语料库的偏置列表作为热词短语列表。
为了验证模型在使用较大数据情况下的性能,我们在 GigaSpeech 语料库上训练模型,并在 Earnings21 数据集[6]上进行了测试。
在训练过程中,我们从每个话语中提取 3 个单词数量在 1 到 3 之间的随机短语,将它们添加到批处理中的偏置列表中。此外,我们将一定数量的干扰项合并到偏置列表中,以将列表大小保持在 60。
除了单词错误率(WER)之外,我们还使用偏置单词错误率(B-WER)和无偏单词错误率(U-WER)评估结果。U-WER 对不在偏置列表中的单词进行测量,而 B-WER 则对在偏置列表中的单词进行测量。对于插入错误,如果插入的短语在偏置列表中,则计入 B-WER,否则计入 U-WER。
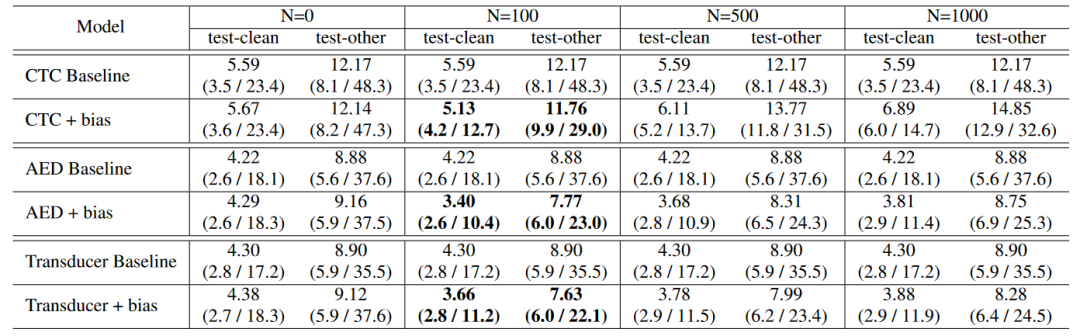
对比热词偏置模型与基线模型
表1 具有不同偏置列表大小 N 的 LibriSpeech 结果,指标格式:WER (U-WER/B-WER)
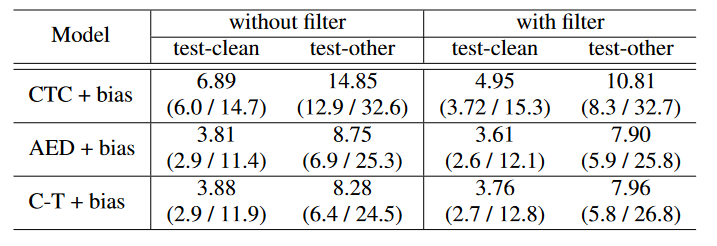
热词短语筛选算法测试
表2 偏置列表大小 N = 1000 时热词偏置模型应用热词短语筛选的结果
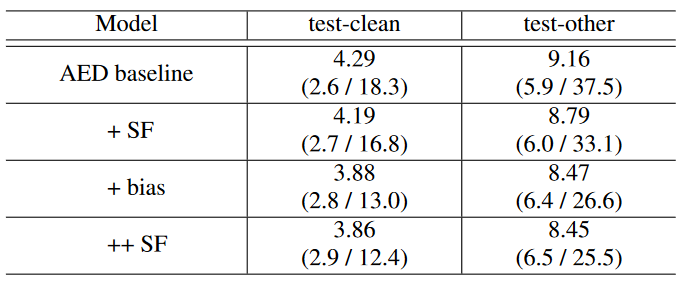
对比浅融合方法
表3 热词偏置AED模型与浅融合方法的结果
消融实验
表4展示了消融研究的结果。对于热词偏置 AED 模型,不共享 CTC 线性层参数可以获得更好的 B-WER 性能,但会对偏置列表的大小更敏感。如果没有偏置损失,则热词偏置 AED 模型完全失去热词偏置能力。
表4 消融实验结果
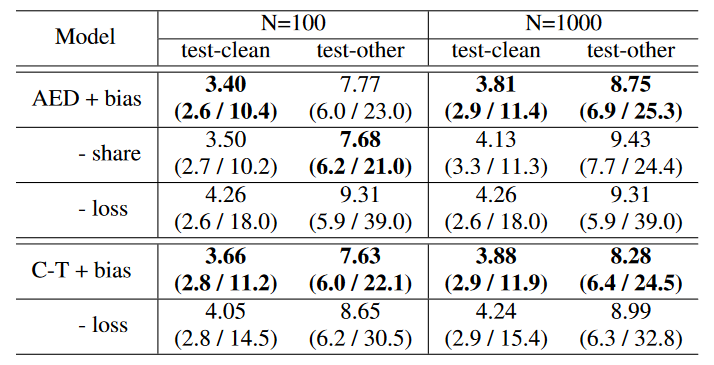
在热词偏置Transducer中,当不适用偏置损失时,模型基本上与 CATT 一致,它具有热词偏置的能力,但 B-WER 改进没有之前显著。
在 Earnings21 数据集上的结果
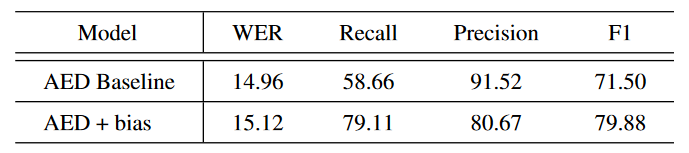
表5 热词偏置 AED 模型在 Earnings21 上的结果
参考文献
[1] Z. Chen, M. Jain, Y. Wang, M. L. Seltzer, and C. Fuegen, “Endto-end contextual speech recognition using class language models and a token passing decoder,” in IEEE International Conference on Acoustics, Speech and Signal Processing, ICASSP 2019, Brighton, United Kingdom, May 12-17, 2019. IEEE, 2019, pp. 6186–6190.
[2] G. Pundak, T. N. Sainath, R. Prabhavalkar, A. Kannan, and D. Zhao, “Deep context: End-to-end contextual speech recognition,” in 2018 IEEE Spoken Language Technology Workshop, SLT 2018. IEEE, 2018, pp. 418–425.
[3] F. Chang, J. Liu, M. Radfar, A. Mouchtaris, M. Omologo, A. Rastrow, and S. Kunzmann, “Context-aware transformer transducer for speech recognition,” in IEEE Automatic Speech Recognition and Understanding Workshop, ASRU 2021. IEEE, 2021, pp. 503–510.
[4] Z. Yang, S. Sun, X. Wang, Y. Zhang, L. Ma, and L. Xie, “Two-stage contextual word filtering for context bias in unified streaming and non-streaming transducer,” CoRR, vol. abs/2301.06735, 2023.
[5] D. Le, M. Jain, G. Keren, S. Kim, Y. Shi, J. Mahadeokar, J. Chan, Y. Shangguan, C. Fuegen, O. Kalinli, Y. Saraf, and M. L. Seltzer, “Contextualized streaming end-to-end speech recognition with trie-based deep biasing and shallow fusion,” in Interspeech 2021, 22nd Annual Conference of the International Speech Communication Association, H. Hermansky, H. Cernock ́ y, L. Burget, L. Lamel, O. Scharenborg, and P. Motlı ́cek, Eds. ISCA, 2021, pp. 1772–1776.
[6] J. D. Fox and N. Delworth, “Improving contextual recognition of rare words with an alternate spelling prediction model,” in Interspeech 2022, 23rd Annual Conference of the International Speech Communication Association, H. Ko and J. H. L. Hansen, Eds. ISCA, 2022, pp. 3914–3918.
