
 西工大音频语音与语言处理研究组
会议网址:https://iwslt.org
赛事网址:https://iwslt.org/2023/s2s
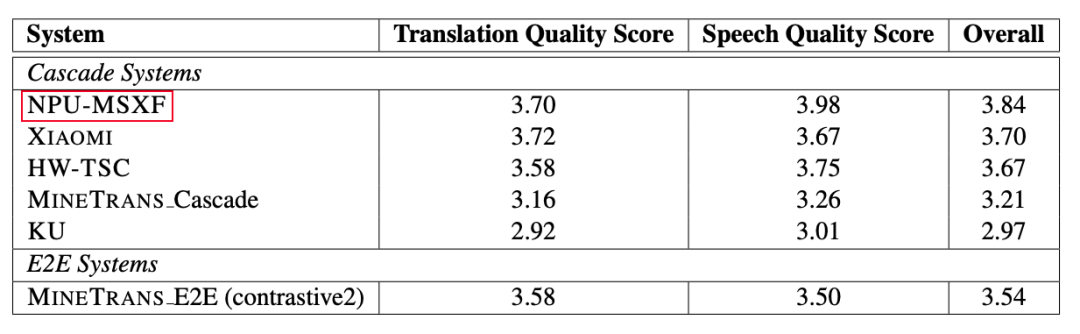
表1 官方发布的评测结果
今年的 S2ST 赛道主题是英文到中文翻译,通过提供的原始英文语音翻译(合成)为对应的中文语音,实现语音到语音的直接翻译。本次赛事上,除满足竞赛基本要求,我们同时也实现了英文语音到中文语音的零样本说话人音色迁移,即在翻译结果的语音中保留原始语种说话人的音色,提供了更好的用户体验,这也是所有参赛队伍中唯一实现此功能的队伍。
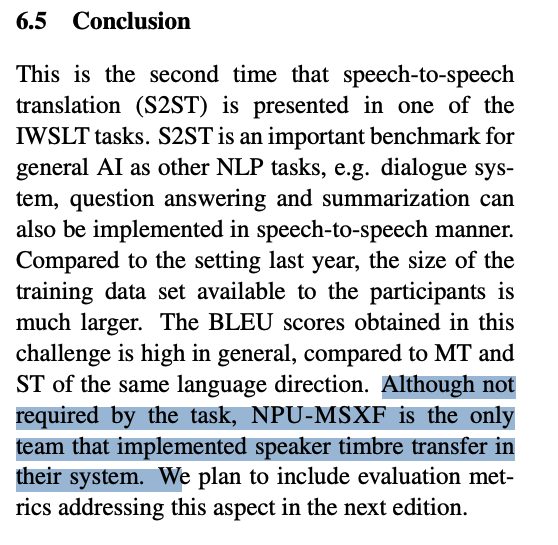
图1 官方总结论文中对实验室系统优势的描述
竞赛测试集来自于多源数据,包含丰富的说话风格如聊天、讲故事等,另外一些测试语音包含严重的背景噪声如音乐、人声等,因此对系统的鲁棒性提出了更高的要求。主办方提供了大规模的中英双语语音对、单语语音文本对、单语语音、双语文本对等数据用于训练;鉴于此,我们采用级联系统而非端到端系统方案,这是考虑到级联方案更适合不同子模块使用不同的数据进行针对性的优化。我们的级联系统包含 ASR (语音识别)、MT (机器翻译)、TTS (语音合成) 三个模块,分别用于将英文语音识别为英文文本、英文文本翻译为中文文本、中文文本合成中文语音。框架方面,我们的 ASR 采用 Conformer[1] 架构,MT 采用 mBART50[2] 预训练模型并做针对性 fine-tune,TTS 采用 Bottleneck (BN) 特征作为中间表征做两阶段训练。
针对测试集多样的挑战,我们提交的方案做了多方面的改进,以提高系统鲁棒性。在 ASR 方面,我们使用包含加噪、语速变化、编解码、基频扰动、频谱增强等数据增广措施,用于适应测试集的背景噪声、快语速等。并采用模型融合方法提高模型的泛化性能,使用 Conformer 和 E-Branchformer[3] 两种主流 ASR 架构,并使用不同的数据增强方法训练不同的 ASR 模型,并使用 ROVER[4] 对多种模型结果加权输出最终的 ASR结果。另外由于测试集中大量包含 "Uh", "You know" 等英文口语填充词,会严重影响 MT 的性能以及最终中文语音的自然度,我们也通过设计规则的方法对 ASR 的输出结果做了填充词去除。
在 MT 方面,为了解决真实文本和ASR结果之间的失配(mismatch)造成的级联误差问题,我们采用三阶段方法针对预训练模型进行fine-tune。首先使用 MT 数据 fine-tune 以提高英中翻译场景的准确度,第二步我们并没有直接使用 ASR 的输出对模型 fine-tune,原因是其与真实文本差距太大,直接 fine-tune 容易造成模型的不稳定。因此我们选择与真实文本内容一致的 MT 数据,并将其转化为 ASR 抄本格式,对 MT 模型进行 fine-tune。最后我们使用ASR的输出对模型 fine-tune,以解决 ASR 和 MT 间的失配问题。同时我们也使用了机器翻译中的一些常见策略(如回译和多折验证等)。
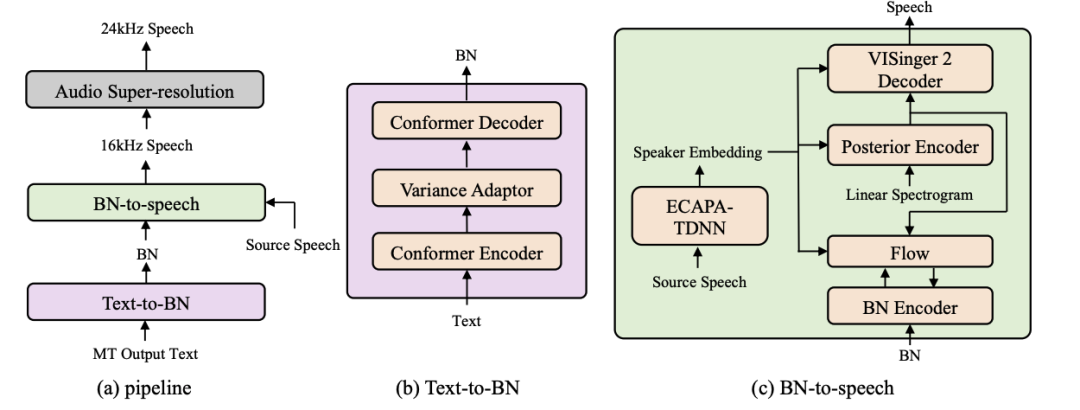
在 TTS 方面,我们使用 神经网络瓶颈特征(BN )作为中间表征,这是因为 BN 可以较好的解耦语言和声学特征,有助于我们实现说话人音色的迁移。在 BN 到语音的还原中,我们采用 VITS[5,6] 框架,并使用主办方提供的数据预训练了一个 ECAPA-TDNN[7] 模型用于提取说话人特征。同时我们还使用了一个频带扩展模型将合成语音扩展到 24kHz 使得最终合成的语音具有更高的音质。
https://aclanthology.org/2023.iwslt-1.1.pdf
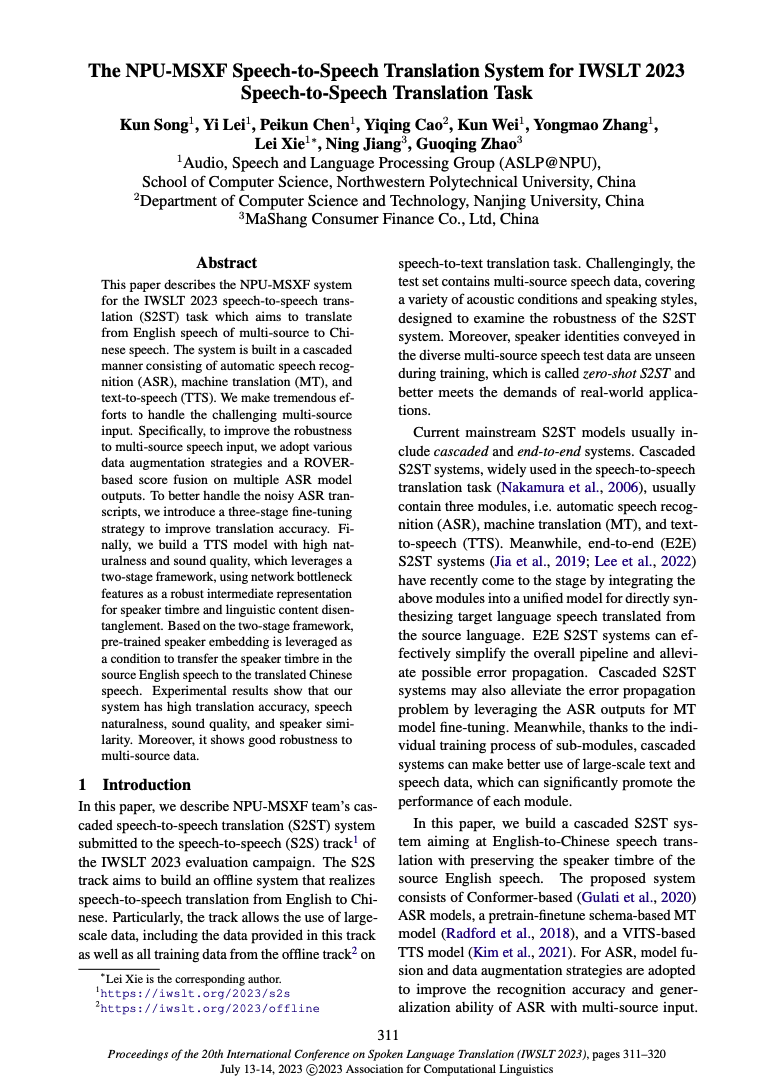
图3 系统描述论文截图
样例:
ICASSP2023 | 利用语音和双语文本联合预训练的语音到语音翻译模型
[1] Anmol Gulati, James Qin, Chung-Cheng Chiu, Niki Parmar, Yu Zhang, Jiahui Yu, Wei Han, Shibo Wang, Zhengdong Zhang, Yonghui Wu, and Ruoming Pang. 2020. Conformer: Convolution-augmented transformer for speech recognition. In Interspeech 2020, 21st Annual Conference of the International Speech Communication Association, Virtual Event, Shanghai, China, 25-29 October 2020, pages 5036–5040. ISCA.
[2] Yinhan Liu, Jiatao Gu, Naman Goyal, Xian Li, Sergey Edunov, Marjan Ghazvininejad, Mike Lewis, and Luke Zettlemoyer. 2020. Multilingual denoising pretraining for neural machine translation. Trans. Assoc. Comput. Linguistics, 8:726–742.
[3] Kwangyoun Kim, Felix Wu, Yifan Peng, Jing Pan, Prashant Sridhar, Kyu J Han, and Shinji Watanabe. 2023. E-branchformer: Branchformer with enhanced merging for speech recognition. In 2022 IEEE Spoken Language Technology Workshop (SLT), pages 84–91. IEEE.
[4] Jonathan G Fiscus. 1997. A post-processing system to yield reduced word error rates: Recognizer output voting error reduction (ROVER). In 1997 IEEE Workshop on Automatic Speech Recognition and Understanding Proceedings, pages 347–354. IEEE.
[5] Jaehyeon Kim, Jungil Kong, and Juhee Son. 2021. Conditional variational autoencoder with adversarial learning for end-to-end text-to-speech. In Proceedings of the 38th International Conference on Machine Learning, ICML 2021, 18-24 July 2021, Virtual Event, volume 139 of Proceedings of Machine Learning Research, pages 5530–5540. PMLR.
[6] Yongmao Zhang, Heyang Xue, Hanzhao Li, Lei Xie, Tingwei Guo, Ruixiong Zhang, and Caixia Gong. 2022. Visinger 2: High-fidelity end-to-end singing voice synthesis enhanced by digital signal processing synthesizer. CoRR, abs/2211.02903.
[7] Brecht Desplanques, Jenthe Thienpondt, and Kris Demuynck. 2020. ECAPA-TDNN: emphasized channel attention, propagation and aggregation in TDNN based speaker verification. In Interspeech 2020, 21st Annual Conference of the International Speech Communication Association, Virtual Event, Shanghai, China, 25-29 October 2020, pages 3830–3834. ISCA.
