西工大音频语音与语言处理研究组
以下文章来源于音频语音与语言处理研究组,作者薛鸿飞
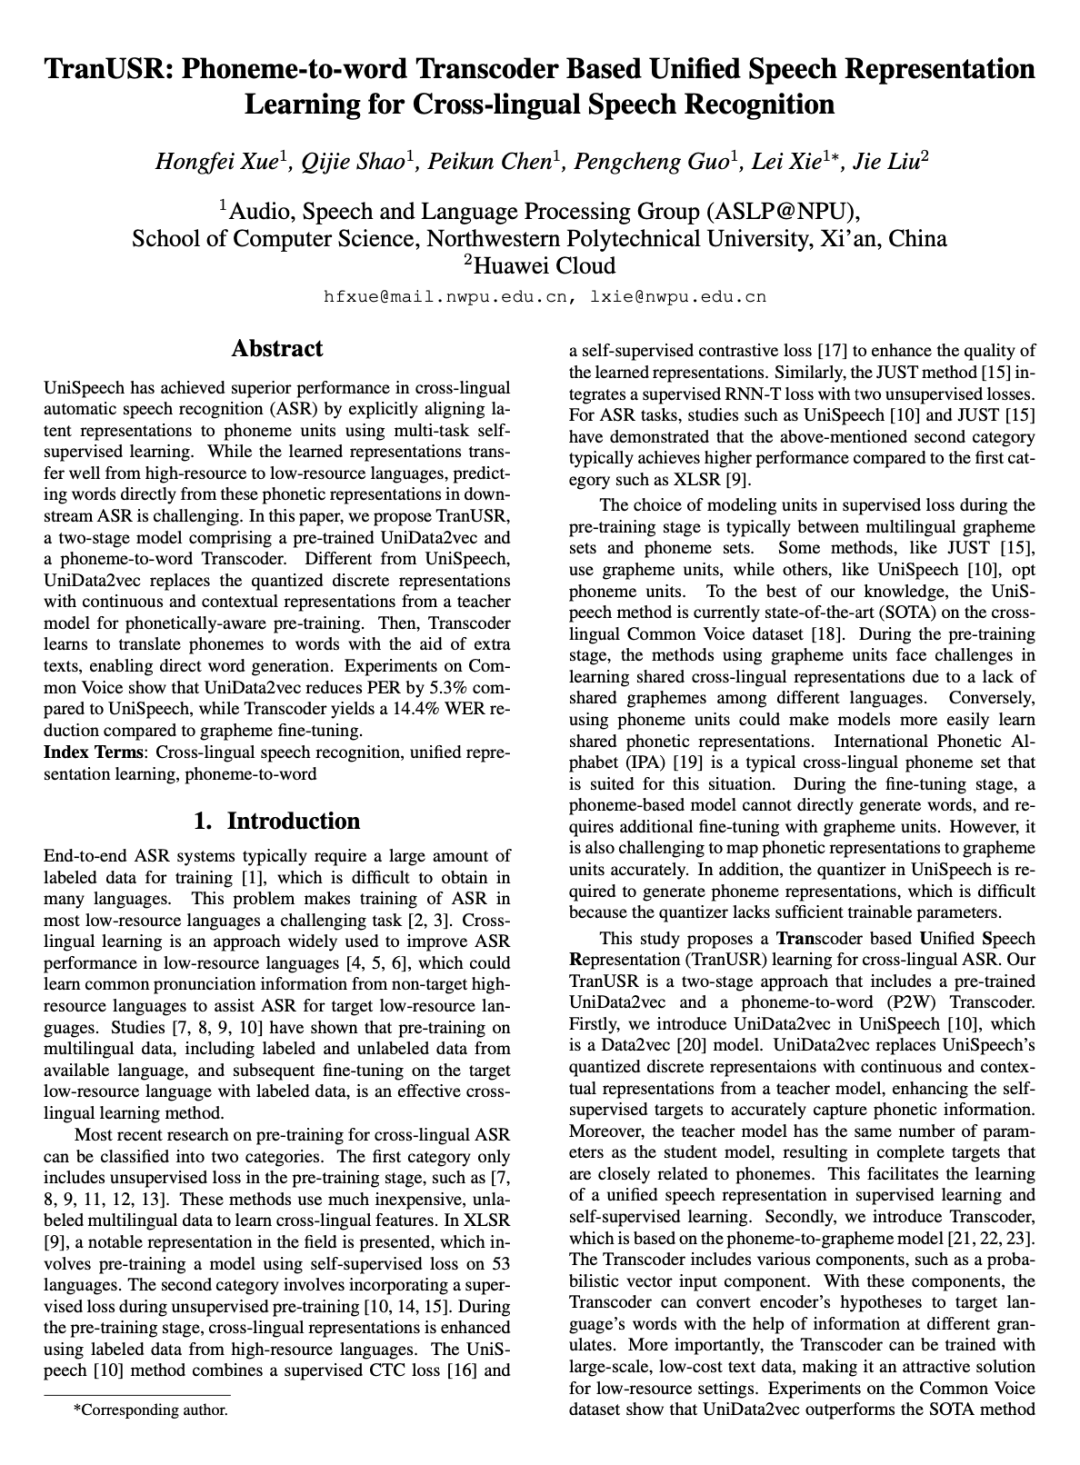
图1 发表论文截图
近期的跨语言语音识别(Cross-lingual ASR)预训练相关研究可以分为两类。第一类方法仅在预训练阶段使用无监督损失,该类方法利用廉价的、无标注的多语言数据来学习跨语言特征。例如,XLSR [1] 使用自监督损失在53种语言上进行预训练。第二类方法在无监督预训练中加入了监督损失,该类方法使用来自高资源语言的标注数据来增强跨语言表示。例如,UniSpeech [2] 方法结合了监督的CTC损失和自监督的对比损失,以提高学习表示的质量。研究表明,对于语音识别任务,像UniSpeech [2] 这样的方法相比于XLSR通常在性能上表现更好。
通过多任务自监督学习,UniSpeech基于联合有标记和无标记语音表征的自监督预训练技术,能够将不同语言的语音表征对齐到语言无关的音素单元,从而学习到一套高质量的语音表征,在跨语言语音识别方面取得了出色的性能。然而,UniSpeech存在一些问题,比如量化器产生的离散自监督目标可能质量不高,难以准确表示不同语言中同一音素之间的差异。此外,虽然UniSpeech学习到的潜在表征可以容易地从高资源语言迁移到低资源语言,但在下游ASR中直接从这些音素相关表征预测词仍然具有挑战性。
为了解决这些问题,本文提出了一种基于转码器的联合语音表示(TranUSR)学习方法,用于跨语言ASR。TranUSR是一个两阶段的方法,包括一个预训练的UniData2vec和一个音素到词(P2W)转码器。UniData2vec利用教师模型中的连续和上下文表示取代了UniSpeech的量化离散表示,以增强自监督目标,准确捕捉音素信息。Transcoder包括多种组件,如概率向量输入组件,通过这些组件,Transcoder能够在不同粒度的信息帮助下将编码器的假设转换为目标语言的单词。在Common Voice数据集上的实验证明,UniData2vec在相对平均音素错误率(PER)上相对降低5.3%。此外,相对于字素微调,Transcoder在相对平均词错误率(WER)上实现了14.4%的相对降低。
如图3(a)所示,TranUSR由两部分组成:UniData2vec和Transcoder。UniData2vec从语音特征中预测音素概率,而Transcoder会将这些概率转换为以单词为单位的句子。
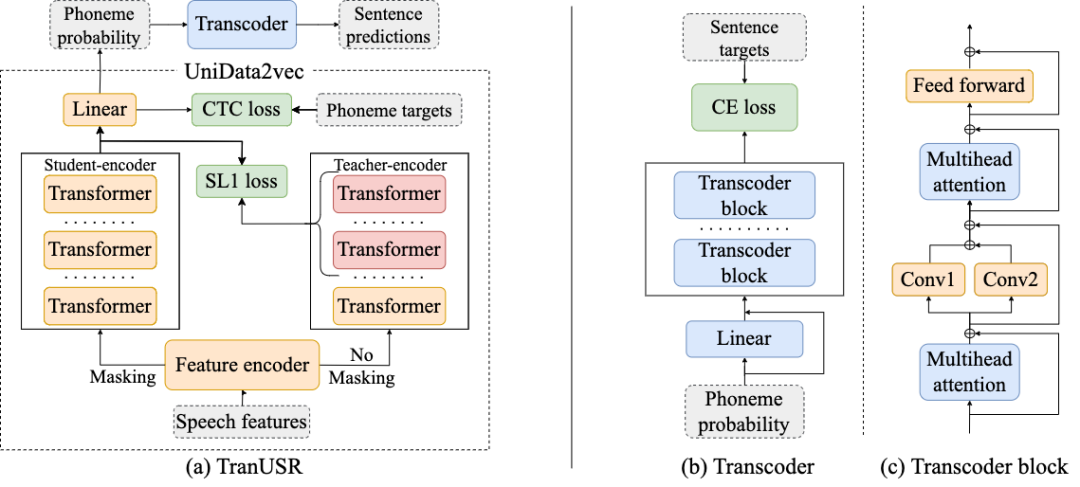
图3:TranUSR的架构图示。子图(a)是TranUSR的概览,(b)是Transcoder P2W模型,(c)是Transcoder块的细节。
2.1 任务描述
本研究中,我们使用四种高资源和低资源数据,可以表示为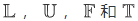 。
 是由语音音频和抄本组成的非目标高资源语言的有标签数据。
 是无标签的目标低资源语言数据,
 是目标语言有标签的据,
 是纯文本目标语言数据。尽管
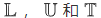 很容易获取,但
我们的任务包括四个步骤:(1)在 上训练一个UniData2vec基础模型,(2)使用UniData2vec初始化并在
 上训练一个UniData2vec
 模型,以学习跨语言的语音感知表示,(3)在每个目标低资源语言数据集
 上微调模型,以提高音素识别能力,(4)使用大型文本数据
 为每种语言训练一个P2W Transcoder模型。
2.2 UniData2vec
自监督损失我们使用自监督的Smooth L1(SL1)损失来鼓励Student-encoder预测Teacher对掩码样本得到的上下文表示Y。具体而言,我们使用指数移动平均(EMA)[3]方法对Teacher-encoder的模型参数进行参数化。训练目标Y是基于Teacher-encoder顶部K层的输出,这些层表示Student-encoder中的掩码时间步。给定上下文表示C和目标Y,我们使用SL1损失函数来回归这些目标值:
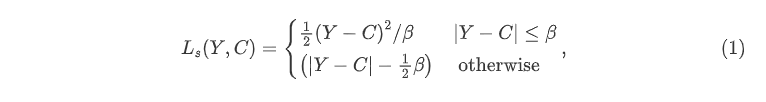
其中 控制从平方损失到L1损失的转变。
联合表示我们结合监督式CTC损失和自监督式SL1损失来训练联合表示模型。在监督训练中,主要的损失函数是CTC损失,由Student-encoder生成的上下文表示C对应于音素单元。由于EMA方法参数化了Teacher-encoder,所以Teacher-encoder生成的自监督目标Y也与音素单元相关。因此,监督训练和自监督训练学到的表示可以在相同的空间中得到约束,而无需像UniSpeech[2]中那样进行替代。损失函数可以分别表示为:
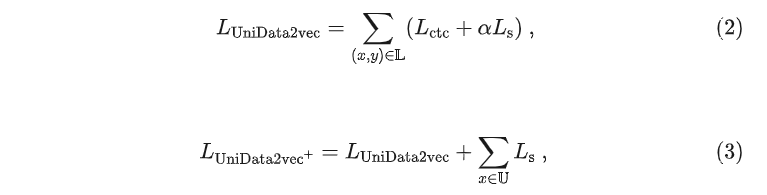
 是一个可调权重的自监督损失。在数据集
 的训练中,它可以设置为(0,0.5)。
2.3 Transcoder
模型结构如图3(b)所示,我们的Transcoder模块由一个线性层和多个Transcoder块组成。每个Transcoder块包含两个卷积层、两个多头注意力块、一个前馈神经网络和多个残差连接,如图3(c)所示。
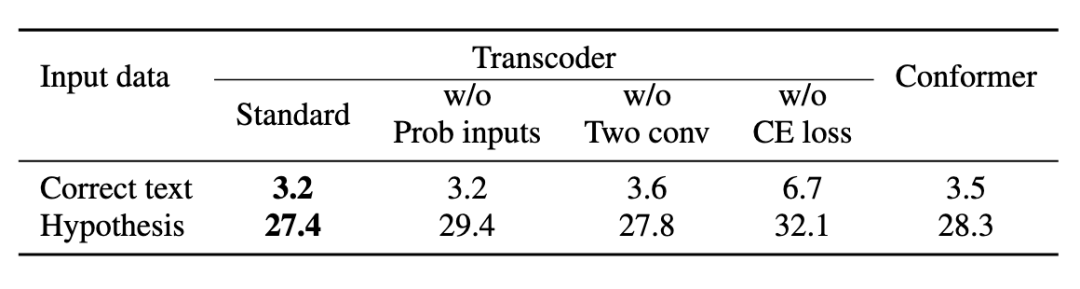
概率向量输入传统的P2W模型通常使用音素的one-hot向量作为输入。然而,当音素序列存在错误时,这可能导致性能下降。我们的Transcoder模型是在正确的文本上进行训练的,并在可能包含错误的UniData2vec假设上进行微调。为了适应这两种类型的输入,我们使用软音素后验概率代替硬性的one-hot向量作为输入。当音素序列来自于正确的文本时,概率向量和one-hot向量是等价的。然而,传统的文本嵌入层只支持硬性的one-hot向量作为输入。为了克服这个限制,我们使用一个可训练的线性层来学习文本嵌入,从而实现对正确文本的预训练和对假设文本的微调。
词内和词间信息提取传统的P2W模型通常使用卷积层来提取单词内音素之间的依赖关系。然而,由于单词包含的音素数量不同,一个单独的卷积层可能无法处理不同长度的单词。为了解决这个问题,我们的Transcoder模块使用了两个具有不同卷积核大小的卷积模型,以提取两个粒度的单词内信息,从而提高对长度不同的单词的建模精度。此外,我们还使用了一个多头注意力块来提取单词间的信息。
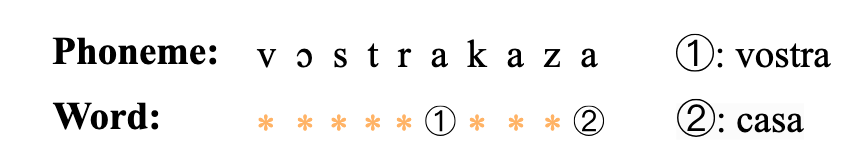
对齐约束损失音素和单词的序列长度在不同语言中可能不同,并且通常使用CTC损失来处理输出和输入序列长度不一致的情况。然而,P2W映射具有明确的对齐边界,不同于音频到单词的映射。为了进一步提高Transcoder的性能,我们使用交叉熵(CE)损失来确保准确的对齐学习。由于CE损失要求输入和输出具有相同的长度,我们通过在单词前添加"*"标记来实现序列的对齐。例如,对于意大利语句子"vostra casa",我们按照图4所示的方式进行对齐。通过这种对齐方式,我们的Transcoder可以准确地将音素映射到单词。
3.1 实验数据
本文使用了两个数据集:Common Voice 6.0 [4]和TED2020 [5]。为了与UniSpeech进行比较,我们选择了以下八种语言进行实验:英语(en)、西班牙语(es)、法语(fr)、意大利语(it)、吉尔吉斯语(ky)、荷兰语(nl)、俄语(ru)和塔尔语(tt)。我们将英语(en)作为非目标语言L,拥有1350小时的数据。其他语言作为目标语言,其持续时间如表1所示。对于微调,我们使用了与UniSpeech相同的设置。TED2020是一个多语言文本语料库,我们选择了以下三种语言作为目标语言T进行评估,每种语言有400k句子:西班牙语(es)、法语(fr)和意大利语(it)。
UniData2vec本文使用fairseq [6]框架来实现UniData2vec模型,并参考了Data2vec [3]中的结构设置。编码器由7个卷积层组成,每个卷积层具有512个通道,步长分别为(5, 2, 2, 2, 2, 2),核宽分别为(10, 3, 3, 3, 2, 2)。教师编码器和学生编码器均由12个Transformer层组成,每个层的尺寸为768,内部尺寸为3072,并且具有8个注意头。目标层的选择是通过对顶部K = 8层的输出进行平均得到的。
4.1 UniData2vec评估
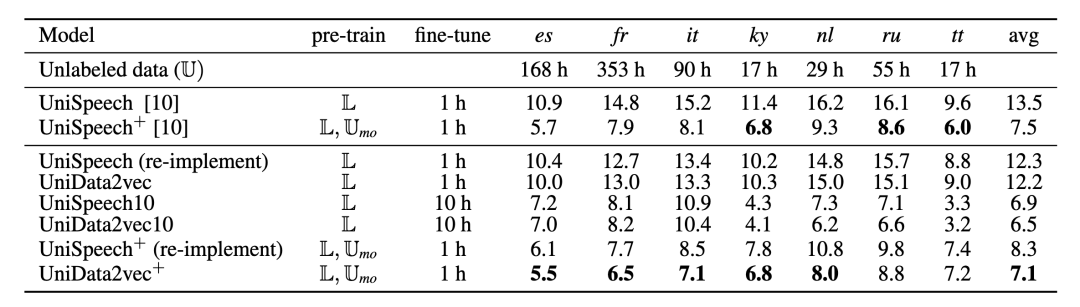
跨语言音素识别在对低资源语言 进行1小时微调后,UniData2vec展现出与-implement的UniSpeech相似的竞争力。然而,当微调数据集增加到10小时时,UniData2vec10的平均音素错误率(PER)相对于UniSpeech10下降5.8%。本文认为这是因为UniData2vec更加关注监督下的CTC损失作为主要损失函数,从而表现出更好的音素识别能力,这需要更多的数据(如10小时)来实现在其他语言上的转移效果。
当使用各自的单语无标签数据集 进行进一步训练时,UniData2vec
 在平均PER方面比UniSpeech
 低5.3%。这种改进在数据量较大的语言中更为显著,如西班牙语(es)、法语(fr)和意大利语(it)中平均PER相对下降11.9%,甚至在法语(fr)中下降17.7%;而在数据量较小的语言中则较为有限,如吉尔吉斯语(ky)、荷兰语(nl)、俄语(ru)和塔尔语(tt)。这是因为在UniData2vec的训练过程中,自监督损失的权重较小,而对于屏蔽位置的预测能力不够,因此 UniData2vec
 的优势需要更多的数据来显现。
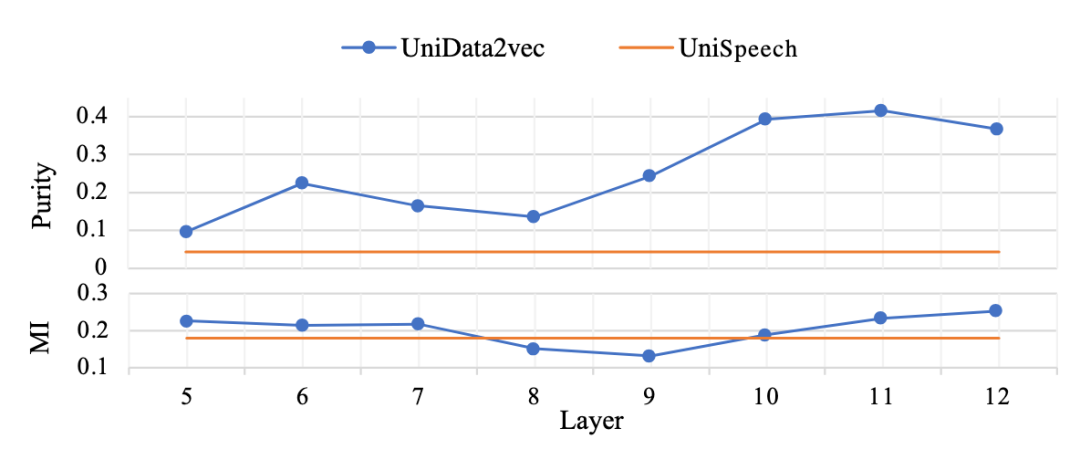
图5:用纯度(Purity)和相互信息(MI)来衡量自监督目标的质量。
自监督目标质量为了验证UniData2vec相对于UniSpeech的联合表征学习的优越性,本文评估了UniData2vec学习的自监督音素信息的质量。按照先前的工作,本文使用K-means对自监督目标的音素信息进行聚类,并测量Purity和MI指标。在UniData2vec中,本文从Teacher-encoder的前8层提取表示,而在UniSpeech中,本文使用离散的潜在表示。如图5所示,UniData2vec展现出比UniSpeech更清晰的Purity,这种差异在更深层次上变得更加明显。这是因为最后一层需要进行音素分类。虽然UniData2vec在MI方面普遍优于UniSpeech,但在第9层出现了性能下降的情况,这可能是因为第9层学习的音素信息较少。
4.2 Transcoder评估
表2:对Transcoder和直接微调UniData2vec+的单词错误率(WER)进行比较。
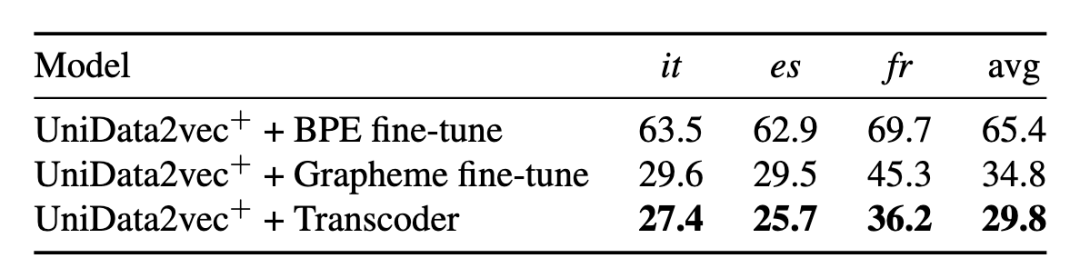
TranUSR vs 直接微调为了展示Transcoder模型的优势,本文将其与直接微调方法进行了比较。直接微调方法是指直接替换UniSpeech或UniData2vec模型的输出层并进行微调,建模单元包括字素和BPE。实验结果如表3所示。在额外的文本数据上进行训练的Transcoder模型表现明显优于基线的BPE模型。Transcoder模型的加权平均词错误率比直接使用字素单元的模型相对低约14.4%,比使用BPE为建模单元的模型相对低约54.4%。纯文本数据比成对的语音-文本数据更便宜和易获取,这使得Transcoder模型更加实用。
表3:每个组件对转码器的WER(错误词率)的消融。实验中仅使用意大利文本。