
 西工大音频语音与语言处理研究组
语音识别(ASR)作为可以准确高效转录语音的技术,已经取得了长足进步。但是当遇到口音等特殊语音条件时,识别错误率急剧攀升。语言模型(LM)可以利用ASR产生的假设(hypothesis)完成错误纠正。最近的一些工作利用大语言模型(LLM)卓越的文本理解能力,提出了一种生成式错误纠正(GER)的方法,用以更好地挖掘ASR假设中的语言信息。
最近,西北工业大学音频语音与语言处理研究组(ASLP@NPU)与华为合作的论文“MMGER: Multi-modal and Multi-granularity Generative Error Correction with LLM for Joint Accent and Speech Recognition”被重要期刊IEEE Signal Processing Letters接收。该论文在GER系列工作的基础上,探究了其在具有挑战性口音语音场景中的应用。具体来说,该论文提出了一种可以加入到联合语音识别和口音识别(ASR-AR)训练的多模态多粒度生成式错误纠正方法(MMGER),在中文多口音数据集KeSpeech上,MMGER比标准基线模型的口音识别准确率相对提高了26.72%,语音识别字错误率相对降低了27.55%,达到了KeSpeech数据集上当前最低字错误率。现对该论文进行简要的解读。
背景动机
尽管近年来语音识别(ASR)的能力取得了长足的进步,但是当ASR面对复杂的声学条件如背景噪声以及口音时会产生很多错误。语言模型重打分方法(LM Rescoring)已经广泛应用于ASR解码中以提升ASR性能。此外,LM也通过利用ASR产生最佳假设(1-best)或者N个最佳假设(N-best)完成ASR纠错。最近的工作利用大语言模型(LLM)卓越的文本理解能力,提出了一种生成式错误纠正的框架(Generative Error Correction,GER)[1,2,3,4],以更好地挖掘ASR产生的N-best假设中的语言信息。通过参数高效的LLM微调,GER在学习从假设到转录的映射方面表现出了卓越的性能,显著优于传统的LM Rescoring方法。
尽管GER具有显著的性能,但是其具有一定的局限性。首先,GER本质上是一个级联系统,先通过WavLM[5]和Whisper[6]等语音基础模型生成N-best假设,然后通过LLM学习这些假设与真实转录之间的映射。通过这种方式产生的N-best假设是固定的,可能会限制GER的性能以及泛化能力。其次,GER仅利用N-best假设中的语言信息来预测转录,缺乏对语音中声学信息的利用。
本论文探究了GER在具有挑战性的口音语音场景中的应用。口音发音作为标准发音的偏差,受到说话者的教育背景、地理区域以及母语等因素的影响。最近的研究发现多口音挑战可以同时从声学和语言学两方面解决,联合ASR和口音识别(AR)的多任务学习框架(ASR-AR)已经成为一个广泛应用的解决方案[7]。该框架通常由一个共享编码器和两个分支组成,一个分支用于ASR任务,另一个分支用于AR任务。一方面,同时利用声学信息和来自ASR分支的语言学信息可以有效提高AR性能;另一方面,AR任务中的口音信息可以帮助ASR适应发音或者语言的变化,从而增强ASR在口音语音的性能。
为此,本论文提出了一种利用多模态纠错和多粒度纠错的ASR-AR GER模型MMGER,在多口音普通话数据集KeSpeech[8]上验证了该方法的有效性,与标准基线模型相比,MMGER的口音识别准确率(AR ACC)相对提高了26.72%,语音识别字错误率(ASR CER)相对降低了27.55%,获得了KeSpeech数据集上最低的CER。
提出的方案
总体概述
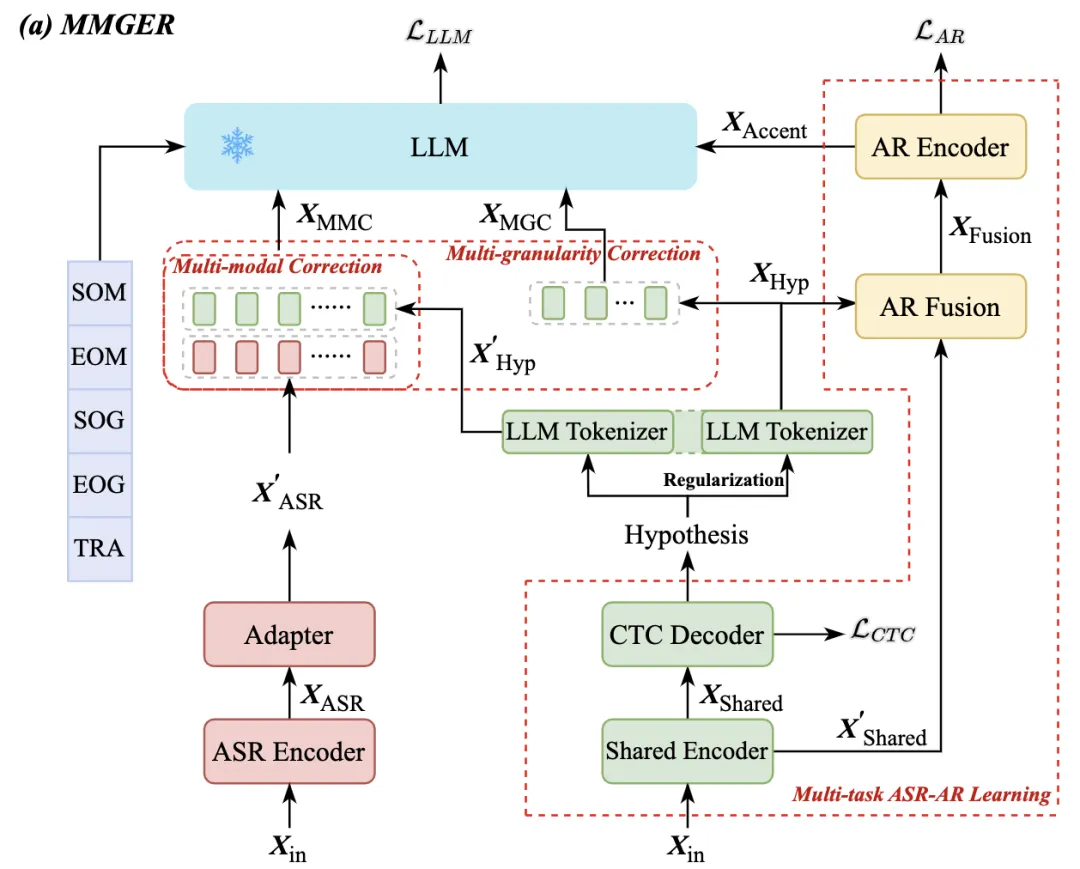
图1 MMGER总体结构图
多任务ASR-AR学习
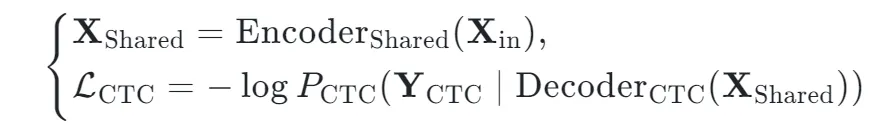
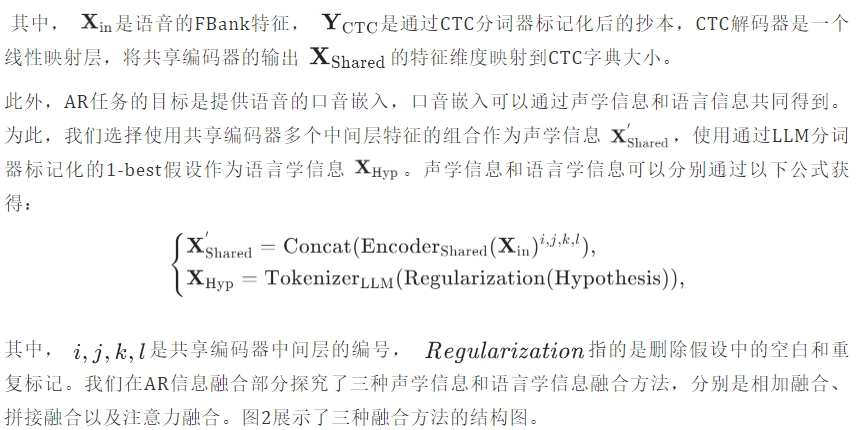
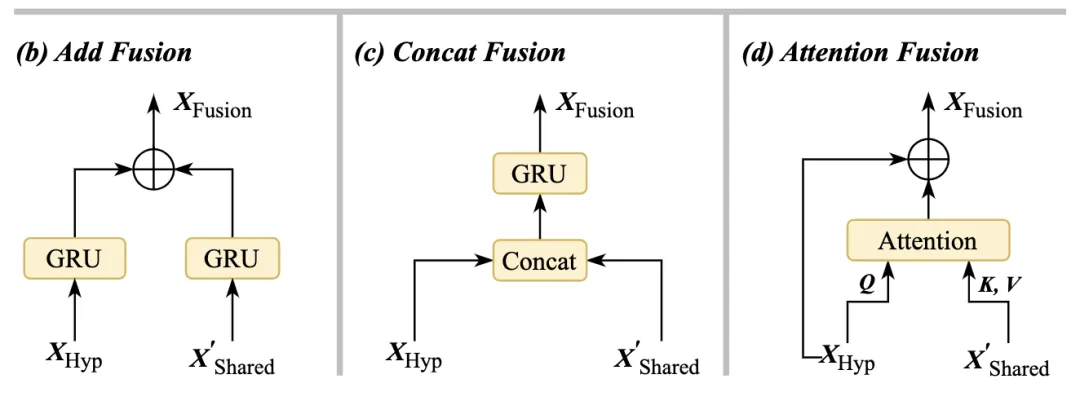
图2 三种多模态信息融合方法结构图
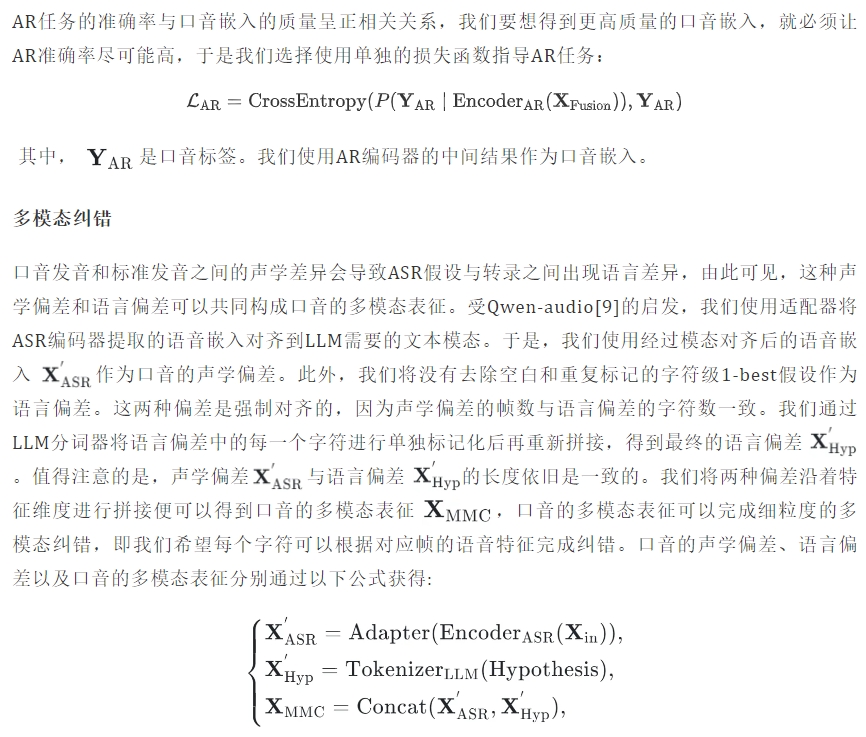
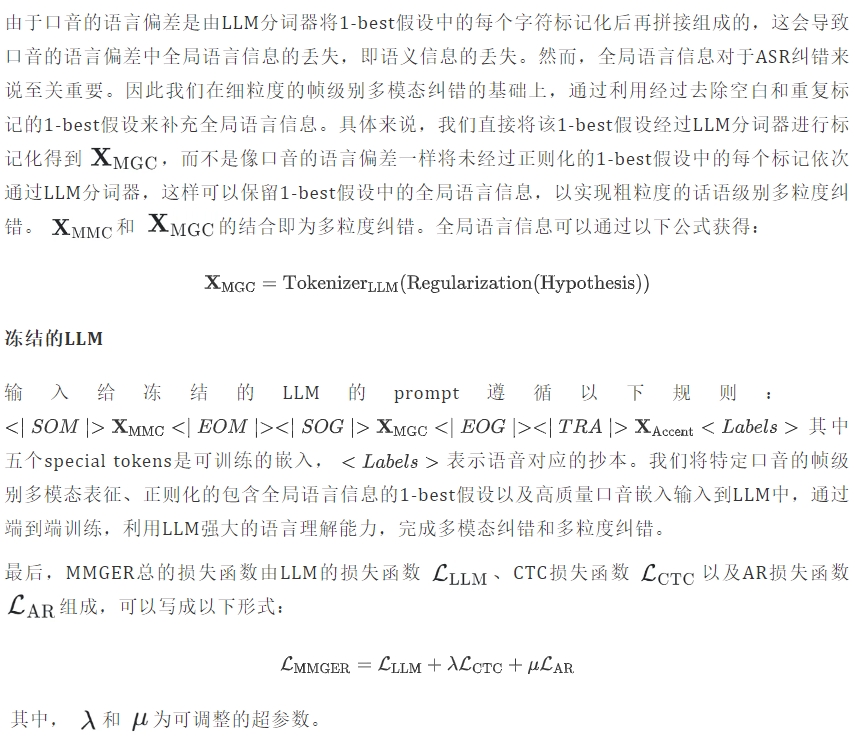
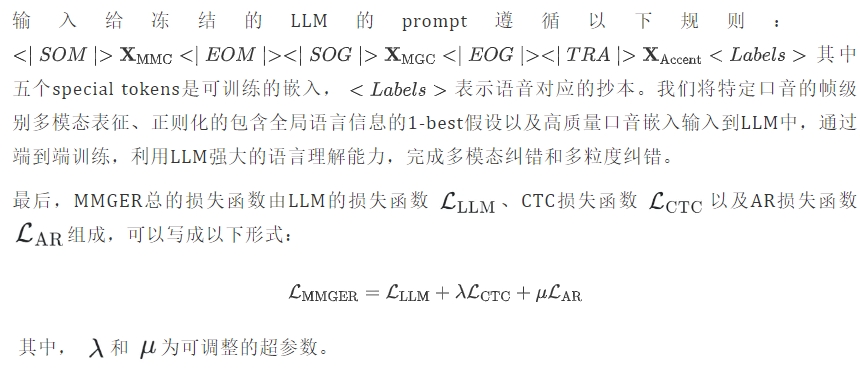
实验结果
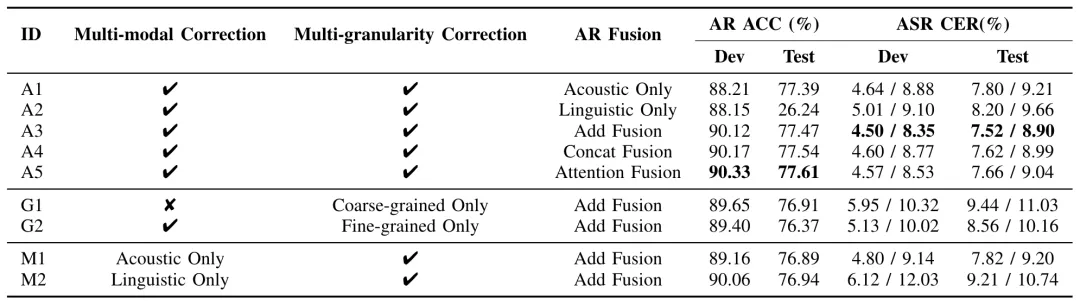
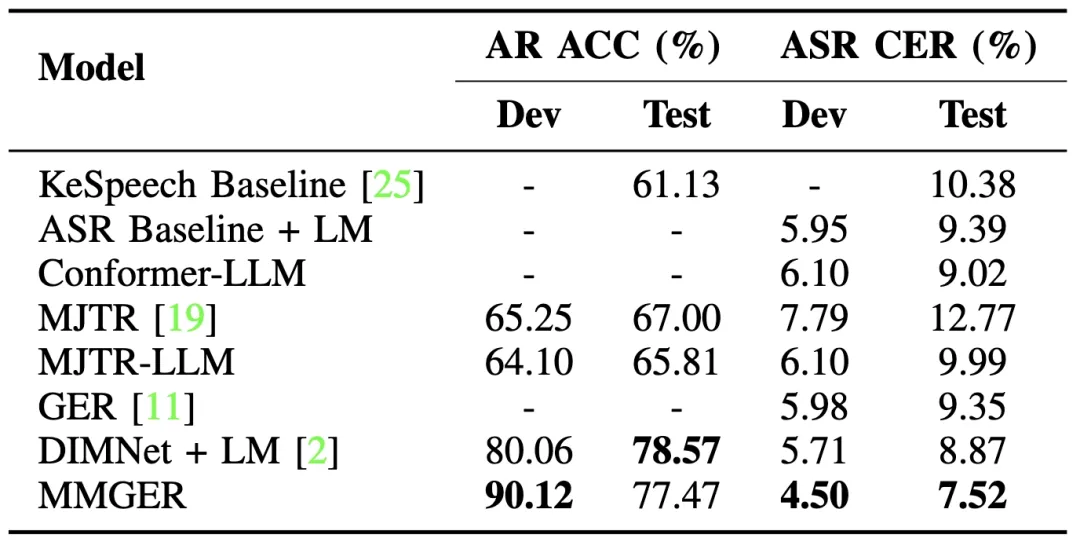
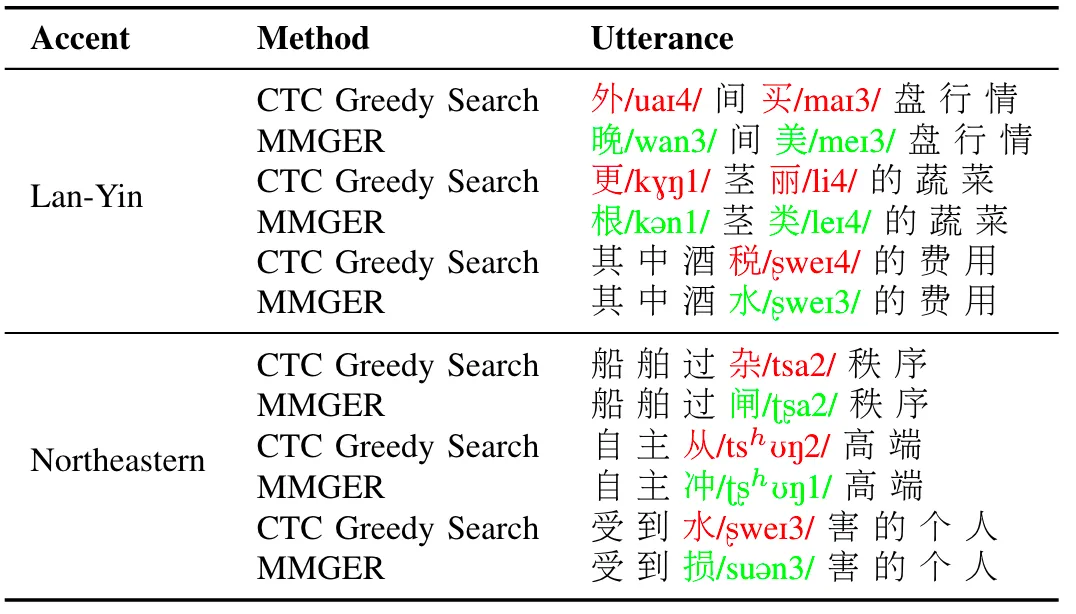
结论
在这篇论文中,我们提出了一种利用多模态纠错和多粒度纠错的ASR-AR GER模型MMGER。多任务ASR-AR学习模块用来生成动态的1-best假设以及口音嵌入,消除了GER中使用固定N-best假设的限制,促进模型适应特定口音的声学和语言变化。我们还将帧级别的口音声学偏差以及语言偏差拼接起来完成细粒度的多模态纠错,在此基础上,我们通过正则化的1-best假设中包含的全局语言信息来实现话语级别的粗粒度纠错。最后,我们在多口音普通话数据集KeSpeech上验证了MMGER方案的有效性。
参考文献
[1] Chen Chen, Yuchen Hu, Chao-Han Huck Yang, Sabato Marco Siniscalchi, Pin-Yu Chen, and Eng-Siong Chng, “Hyporadise: An open baseline for generative speech recognition with large language models,” Advances in Neural Information Processing Systems, vol. 36, 2024.
[2] Chen Chen, Yuchen Hu, Chao-Han Huck Yang, Hexin Liu, Sabato Marco Siniscalchi, and Eng Siong Chng, “Generative error correction for code-switching speech recognition using large language models,” arXiv preprint arXiv:2310.13013, 2023.
[3] Chen Chen, Ruizhe Li, Yuchen Hu, Sabato Marco Siniscalchi, Pin-Yu Chen, EngSiong Chng, and Chao-Han Huck Yang, “It’s never too late: Fusing acoustic information into large language models for automatic speech recognition,” in Proc. ICLR, 2024.
[4] Yuchen Hu, Chen Chen, Chao-Han Huck Yang, Ruizhe Li, Chao Zhang, Pin-Yu Chen, and Eng Siong Chng, “Large language models are efficient learners of noise-robust speech recognition,” in Proc. ICLR, 2024.
[5] Sanyuan Chen, Chengyi Wang, Zhengyang Chen, Yu Wu, Shujie Liu, Zhuo Chen, Jinyu Li, Naoyuki Kanda, Takuya Yoshioka, Xiong Xiao, et al., “Wavlm: Large-scale self-supervised pre-training for full stack speech processing,” IEEE Journal of Selected Topics in Signal Processing, vol. 16, pp. 1505–1518, 2022.
[6] Alec Radford, Jong Wook Kim, Tao Xu, Greg Brockman, Christine McLeavey, and Ilya Sutskever, “Robust speech recognition via large-scale weak supervision,” in Proc. ICML, 2023, pp. 28492–28518.
[7] Qijie Shao, Pengcheng Guo, Jinghao Yan, Pengfei Hu, and Lei Xie, “Decoupling and Interacting Multi-Task Learning Network for Joint Speech and Accent Recognition,” IEEE/ACM Transactions on Audio, Speech, and Language Processing, vol. 32, pp. 459–470, 2023.
[8] Zhiyuan Tang, Dong Wang, Yanguang Xu, Jianwei Sun, Xiaoning Lei, Shuaijiang Zhao, Cheng Wen, Xingjun Tan, Chuandong Xie, Shuran Zhou, et al., “Kespeech: An open source speech dataset of mandarin and its eight subdialects,” in Proc. NeurIPS Datasets and Benchmarks Track, 2021.
[9] Yunfei Chu, Jin Xu, Xiaohuan Zhou, Qian Yang, Shiliang Zhang, Zhijie Yan, Chang Zhou, and Jingren Zhou, “Qwen-audio: Advancing universal audio understanding via unified large-scale audio-language models,” arXiv preprint arXiv:2311.07919, 2023.
