
 每日语音速递
文本到语音(TTS)合成技术正处在一个由大语言模型(LLM)驱动的范式变革时代。目前,学界主流的“下一令牌预测”范式统一了语音生成的框架,但其依赖的“离散化”基石也带来了信息瓶颈、生成幻觉等固有缺陷。虽然已有研究开始转向连续语音表示,但又面临着训练困难、错误累计等新挑战。
最近,西北工业大学音频语音与语言处理研究组(ASLP@NPU)的论文“KALL-E: Autoregressive Speech Synthesis with Next-Distribution Prediction”被人工智能研究领域顶级会议AAAI 2026接收。该论文提出了一种基于语言模型的连续表帧预测方法,以实现基于下一分布预测的自回归语音合成。现对该论文进行简要的解读。
论文题目:KALL-E: Autoregressive Speech Synthesis with Next-Distribution Prediction
作者列表:夏康翔*,朱新发*,姚继珣,田文杰,李文豪,谢磊
论文预印版:https://arxiv.org/pdf/2412.16846
Demo page:https://supernova-neko.github.io/KAll-E_demo/
当前主流的大语言模型(LLM)驱动的文本到语音(TTS)合成技术路线是将语音合成视为一个“下一令牌预测”问题,即将连续的语音信号通过矢量量化等技术“离散化”为声学令牌序列,再由自回归模型进行预测。然而,这种主流方法存在诸多固有缺陷:首先,离散化过程会导致信息损失,即便是对人类听觉不明显的部分,也会削弱重建语音的质量和细节,无法与连续表示相媲美。其次,离散令牌通常帧率较高,相邻令牌相似性强,这容易导致模型在生成时产生不稳定的输出,如出现过长的静音或连续噪声。为了弥补信息损失,一些方法采用多码本方案,但这又显著增加了模型的训练复杂度和计算成本。
为了克服离散化带来的上述问题,部分研究开始探索在自回归模型中直接使用连续语音表示。然而,这些新方法也面临着新的挑战。一方面,它们普遍采用传统的回归损失函数(如MAE或MSE),这些损失函数基于过于简化的分布假设,难以捕捉语音数据本身复杂和多模态的特性,导致生成的语音模糊、过于平滑或过度平均化。另一方面,一些工作为了增强连续表示的建模能力,在语言模型后增加了额外的处理模块,这使得模型结构变得复杂,并可能削弱语言模型自身的核心建模能力。此外,现有连续表示方法未能充分利用其高信息密度的优势,反而常在过高的帧率下建模,这不仅影响了模型的稳定性,还因序列长度的增加而几何级数地增加了计算量,降低了推理效率。
因此,KALL-E的提出正是为了系统性地解决上述离散化和现有连续化方案的双重困境。其核心动机是构建一个更直接、高效且能充分保留语音信息的自回归语音合成框架。具体而言,它旨在通过“下一分布预测”(next-distribution prediction)和KL散度损失,直接对连续语音特征的复杂分布进行建模,避免传统回归损失的“过平滑”问题;同时,通过Flow-VAE提取更具表现力的连续潜在表示,并利用其高信息密度的特性在极低的帧率下进行建模,从而在保证高质量合成的前提下,大幅提升推理速度和模型稳定性,最终实现一种更为优雅和高效的连续语音表示利用方式。
KALL-E 的核心创新在于提出了一种全新的自回归文本到语音(TTS)范式,即“下一分布预测”(next-distribution prediction)。如图1所示,KALL-E 则直接在连续空间中进行建模,它不预测下一个离散令牌,而是直接预测下一帧连续语音特征的概率分布(具体为一个高斯分布的均值和方差)。该方法通过优化预测分布与真实分布之间的KL散度(Kullback-Leibler divergence)损失函数来进行训练,从而避免了离散量化带来的信息瓶颈,更好地捕捉了语音信号的复杂性和多模态特性。
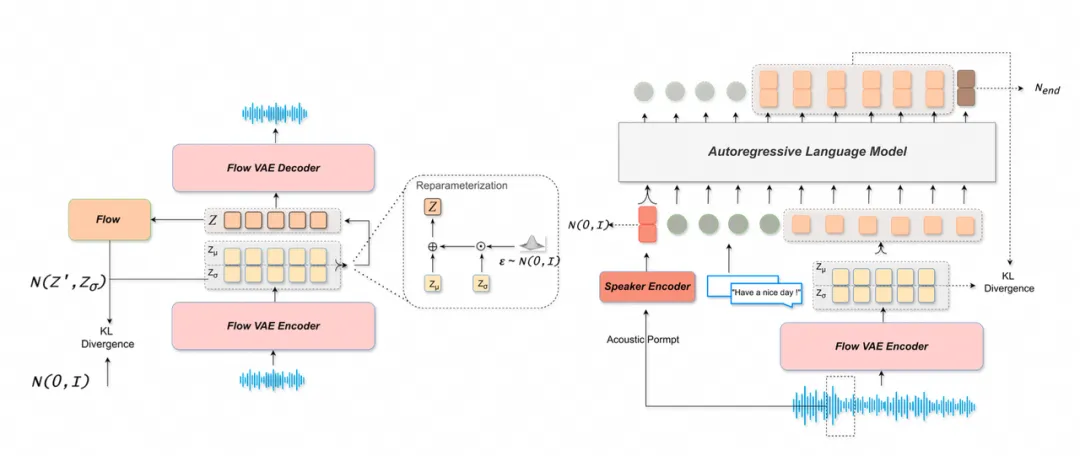
图1 KALL-E模型结构
Flow-VAE:用于提取高质量连续语音表征
为了给自回归模型提供高质量的连续语音表征作为学习目标,KALL-E 采用了一种名为 Flow-VAE 的变分自编码器。与强制将潜在空间约束为标准高斯分布的传统 VAE 不同,Flow-VAE 在其编码器和先验分布之间引入了归一化流(Normalizing Flow)模块。这个模块通过一系列可逆变换,将简单的先验分布(如标准高斯分布)映射到一个更复杂、更具表达力的后验分布。这样做的好处是,它允许模型学习到一个更加丰富多样的潜在空间,既能高质量地重建原始语音波形,又能捕捉到更精细的声学细节和变化。实验证明,相比于其他 VAE 或离散编码器,Flow-VAE 提取的连续表征更适合自回归语言模型的学习,因为它在保留语音信息的同时,其分布特性(如更宽的均值分布和更大的方差)有助于提升生成语音的多样性和模型的鲁棒性。同时,由于连续表征的信息密度高,Flow-VAE 可以在极低的帧率(如12.5Hz)下工作,这为后续模型实现高效推理奠定了基础。
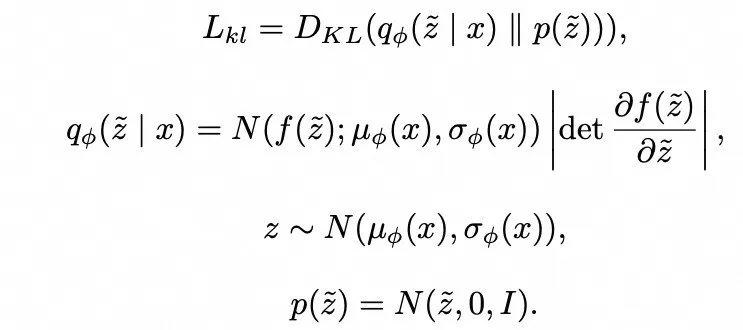
自回归语言模型:基于 Transformer 的分布预测器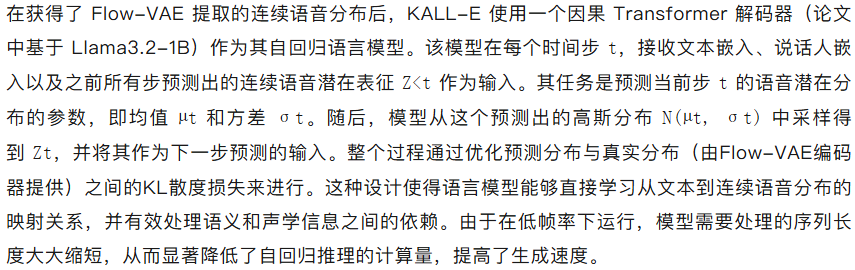
测试时训练(TTT):利用单一样本进行快速说话人自适应
为了进一步提升模型对新说话人的适应能力并充分利用连续表征的高信息密度,KALL-E 引入了一种轻量级的“测试时训练”(Test-Time Training, TTT)策略。该方法仅需一句目标说话人的音频样本,就能在推理阶段对模型进行微调。具体流程如下:首先,使用预训练好的 Flow-VAE 编码器从该单一样本中提取其潜在分布;接着,通过重参数化技巧从该分布中采样多次,生成一个小的训练数据集;最后,冻结说话人编码器,仅用这个小数据集对语言模型进行几个周期的微调。这种方法能够有效缓解仅用单个样本进行微调时可能出现的过拟合问题,同时使模型能更好地捕捉目标说话人的特定风格、口音和其他副语言学特征,显著提升了生成语音在说话人相似度和可懂度方面的表现。
模型训练主要使用了开源的 Emilia 数据集。其中,Flow-VAE 的无监督训练使用了 Emilia 的全部语音数据;自回归语言模型则使用了 Emilia 中约 9.67万小时的中英文数据。为了提升模型质量,还使用了一个约3000小时、经过二次转录和清洗的高质量数据集进行第二阶段微调。此外,为了增强模型的情感表达能力,还引入了 ESD 数据集。在评估阶段,Flow-VAE 的重构性能在 LibriSpeech test-clean 子集上进行测试,而整体的文本到语音(TTS)能力则在 Seed-TTS 的中英文测试集(test-zh, test-en)上进行评估。
VAE 评估
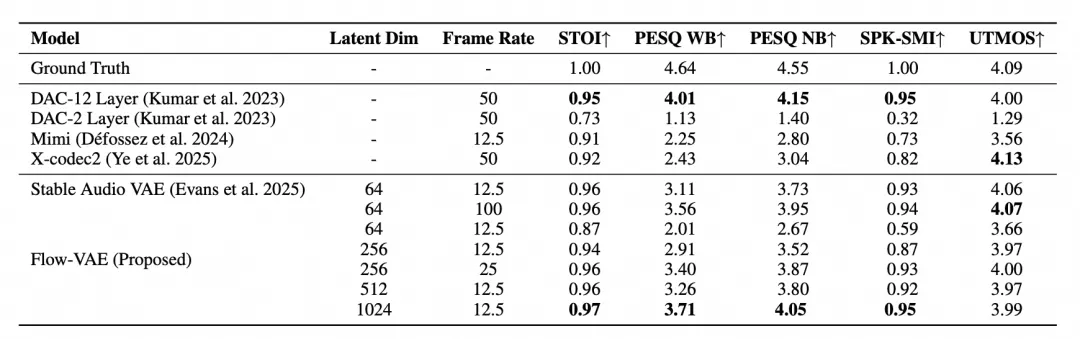
如表1所示,与离散分词器相比,Flow-VAE 能够在极低的帧率(12.5 Hz)下保持高质量的语音重构,显著优于大多数离散方案。实验证明,虽然增加隐变量维度和帧率可以提升重构质量,但 KALL-E 通过增加隐变量维度(至1024维),成功在低帧率下实现了高质量重构(PESQ-WB 达到 3.71)。这表明连续表征在保留信息方面具有天然优势。
表1 LibriSpeech 测试子集上离散分词器和连续 VAE 的音频重建结果。
通过对比 Flow-VAE 和 Stable Audio VAE 的隐变量分布(图2),文章发现 Flow-VAE 学习到了更宽的均值分布和更大的方差分布。更宽的均值分布有助于模型更好地区分不同语音帧,而更大的方差则提升了语言模型建模的鲁棒性,允许其在预测时有更大的容忍度,并可能促进了生成语音的多样性。
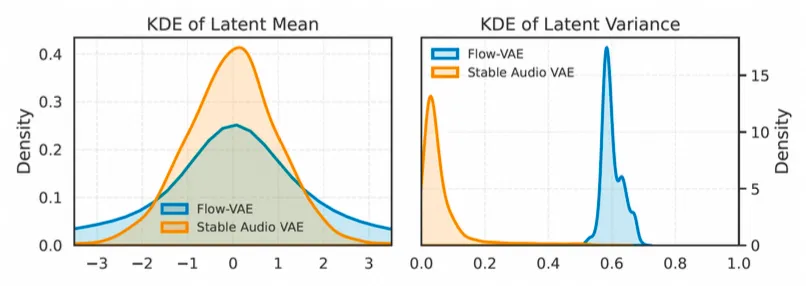
图2均值和方差分布图
TTS 评估
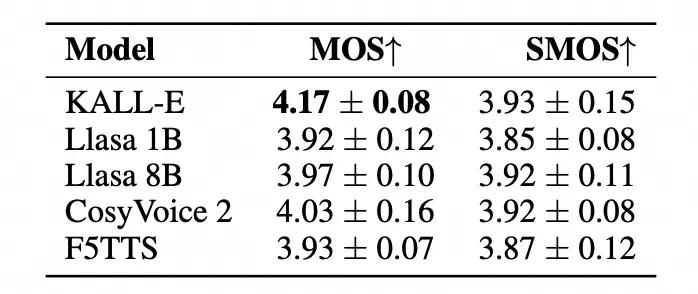
语音克隆与自然度:客观评估(表2)显示,KALL-E 在中英文测试集上均取得了最低的词/字错误率(CER/WER),证明了其合成语音的高清晰度和准确性。引入测试时训练(TTT)后,模型在保持低错误率的同时,显著提升了说话人相似度(SIM)。主观评估(表3)进一步证实了 KALL-E 的优势,其自然度得分(MOS)在所有对比模型中位列第一,显著优于同量级的 Llasa-1B,甚至超过了参数量更大的 Llasa-8B。
表2 客观评测指标
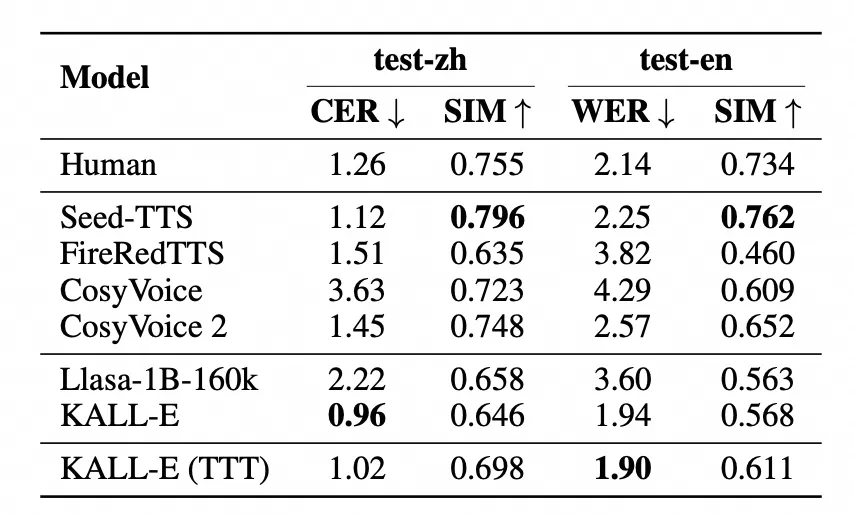
表3主关评测指标
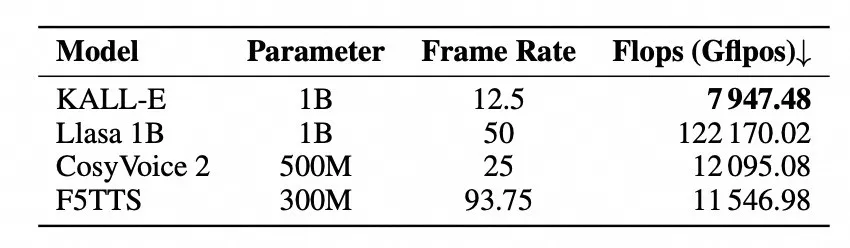
推理效率:如表4所示,KALL-E 凭借其极低的 12.5 Hz 帧率,在推理效率上表现出色。尽管其模型参数量达到1B,但合成10秒音频所需的计算量(GFLOPs)远低于所有对比模型,包括参数量更小的 CosyVoice 2 和非自回归模型 F5TTS,展示了其高效的生成能力。
表4 比较不同模型推理 10 秒音频的速度
上下文感知能力:为了测试模型的情感推理能力,实验仅使用带情感色彩的文本进行合成,并用 Emotion2Vec 进行情感识别。结果(图3)显示,与 Llasa-8B 相比,KALL-E 能够更准确地从纯文本中推断并生成相应的情感,这归功于预训练语言模型的语义理解能力以及连续语音表征对副语言信息的有效保留。
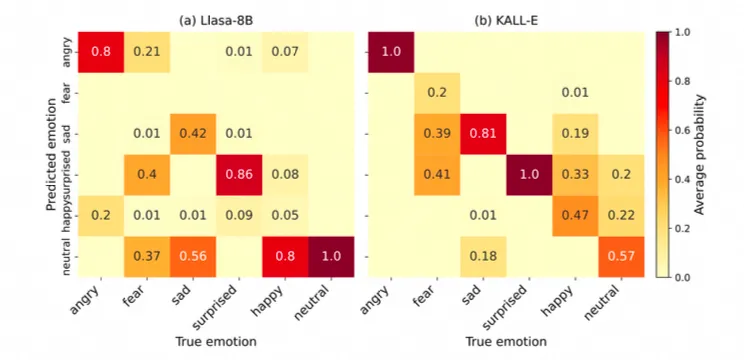
图3无条件生成语音的情感与文本一致性
消融研究总结
消融研究部分深入探究了模型内部关键组件(Flow-VAE 的配置和测试时训练)对最终性能的影响,进一步验证了 KALL-E 设计的合理性。
Flow-VAE 消融实验:该实验评估了不同 Flow-VAE 配置对语言模型性能的影响。结果表明,降低隐变量维度主要影响说话人相似度,而对词错误率影响较小。最关键的发现是,当用同等维度的 Stable Audio VAE 替换 Flow-VAE 后,模型性能出现断崖式下滑(CER 大幅上升,SIM 大幅下降)。这有力地证明了 KALL-E 所提出的 Flow-VAE 架构及其学习到的隐空间分布更适合作为自回归语言模型的学习目标。
测试时训练(TTT)消融实验:该实验探究了 TTT 过程中用于微调的数据量大小(N)对模型性能的影响。结果显示,随着 N 的增加,说话人相似度(SIM)几乎单调提升,表明 TTT 能够有效捕捉说话人特征。同时,字错误率(CER)在 N 达到约200时达到最低点,之后略有回升,作者推测这是由于轻微过拟合了参考语音中的非流利之处。该实验证明,TTT 是一种有效的自适应方法,能够用极少量样本同时提升合成语音的身份相似度和可懂度。
[1] Cong, J.; Yang, S.; Xie, L.; and Su, D. 2021. Glow-WaveGAN: Learning Speech Representations from GAN-Based Variational Auto-Encoder for High Fidelity Flow-Based Speech Synthesis. 22nd Annual Conference of the International Speech Communication Association, Interspeech 2021, Brno, Czechia, August 30 - September 3, 2021, 2182–2186. ISCA
[2] Jia, D.; Chen, Z.; Chen, J.; Du, C.; Wu, J.; Cong, J.; Zhuang, X.; Li, C.; Wei, Z.; Wang, Y.; and Wang, Y. 2025. DiTAR: Diffusion Transformer Autoregressive Modeling for Speech Generation. CoRR, abs/2502.03930.
[3] Kim, J.; Kong, J.; and Son, J. 2021. Conditional Variational Autoencoder with Adversarial Learning for End-to-End Text-to-Speech. In Meila, M.; and Zhang, T., eds., Proceedings of the 38th International Conference on Machine Learning, ICML 2021, 18-24 July 2021, Virtual Event, volume 139 of Proceedings of Machine Learning Research, 5530–5540. PMLR.
[4] Lee, S.; Ping, W.; Ginsburg, B.; Catanzaro, B.; and Yoon, S. BigVGAN: A Universal Neural Vocoder with Large-Scale Training. In The Eleventh International Conference on Learning Representations, ICLR 2023, Kigali, Rwanda, May 1-5, 2023.
