
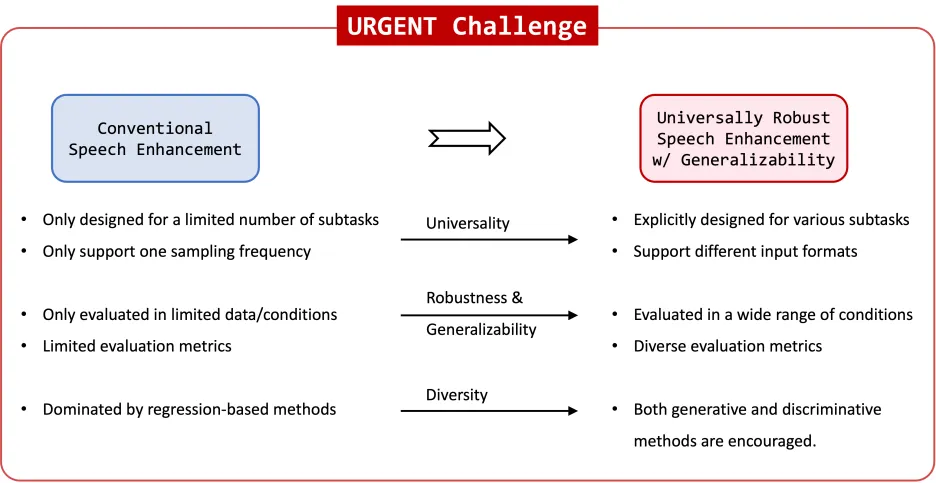
由上海交通大学听觉认知与计算声学实验室(AudioCC Lab)联合卡内基梅隆大学、早稻田大学、Meta、布伦瑞克工业大学等单位联合举办的URGENT 2024 语音增强挑战赛(Universality, Robustness, and Generalizability for EnhancemeNT)正式开启,该挑战赛是人工智能顶级会议 NeurIPS 2024 的官方比赛。URGENT 2024挑战赛旨在构建通用的语音增强模型统一处理具有不同失真和不同采样率等情况的输入语音信号,并评估模型在多样化测试数据上的鲁棒性和泛化性,欢迎大家报名参加!
赛事官网:https://urgent-challenge.github.io/urgent2024/
比赛时间
开始时间:2024 年 6 月 10 日
比赛目标
随着在单一任务上语音增强模型性能的不断提升,越来越多的研究开始关注使用同一模型处理多种不同的语音任务[1][2][3][4]。基于对语音增强模型普适性日益增长的关注,以及生成式语音增强方法的兴起,我们举办了URGENT挑战赛,其目标是:
致力于构建具有强泛化性的通用语音增强模型,激发更多在此方向的研究。 推动面向更真实场景的语音增强的研究进展。 在多样化场景下(包括不同的失真和采样率)对最先进的判别式和生成式语音增强方法进行系统性比较,为后续研究提供有益的启发。 为通用语音增强这一研究方向提供初步的基准,使研究人员能够从不同角度(公平地)轻松比较不同的方法。 通过提供一套限制性的训练数据(基于公开数据),确保不同方法比较时具有公平性,以便得到具有参考价值的结论。
任务介绍
本次挑战赛仅设置单个赛道,任务是构建一个通用的语音增强系统,使其能够自适应地处理具有不同失真的输入语音(对应不同的语音增强子任务)和不同的输入采样率。
数据
训练数据将由多个公开语音数据库、噪声数据库和RIR(房间冲激响应)数据库组成。为保证公平性,在挑战期间我们限制参赛者仅能使用指定的数据库进行数据仿真。我们鼓励参赛者应用数据增强技术,例如动态混合,以实现最佳的模型性能和泛化性。相关的数据准备脚本已发布在官方的GitHub仓库中,详情请查看:https://urgent-challenge.github.io/urgent2024/data/
基线系统
我们还在ESPnet工具包中提供了基线模型和相应的运行样例,以帮助参赛者开始系统开发。关于基线框架的介绍,可参考本挑战赛的 arXiv 文章[5]。详情请查看:https://urgent-challenge.github.io/urgent2024/baseline/
评估指标
不同于之前的语音增强比赛,本次挑战赛将采用多样化指标来评估增强后的音频,以全面了解现有生成式和判别式语音增强方法的能力。这些指标分为四个不同类别:
非侵入性指标(例如DNSMOS、NISQA)用于无参考的语音质量评估。
侵入性指标(例如PESQ、ESTOI、SDR、MCD、LSD)用于客观的语音质量评估。
下游任务独立指标(例如LPS、SpeechBERTScore)用于进行语言无关、说话人无关和下游任务无关的评估。
下游任务相关指标(例如说话人相似度、词准确率WAcc)用于评估语音增强结果与不同下游任务间的兼容性。
关于评估方案的详细信息,请查看:https://urgent-challenge.github.io/urgent2024/rules/
上述评估指标均已在官方GitHub仓库中提供代码:https://github.com/urgent-challenge/urgent2024_challenge/tree/main/evaluation_metrics
联系方式
欢迎加入挑战赛的官方 Slack 聊天频道进行提问和沟通,加入方式见:https://urgent-challenge.github.io/urgent2024/ 如果无法加入 Slack,也可以扫描二维码,加官方微信群:https://urgent-challenge.github.io/urgent2024/wechat_qrcode.jpg 此外,也可以通过发送邮件进行沟通:urgent.challenge@gmail.com。
研讨会
挑战赛组织者
张王优(上海交通大学)
Robin Scheibler(LINE公司)
Samuele Cornell(卡内基梅隆大学)
李晨达(上海交通大学)
Kohei Saijo(早稻田大学)
倪兆衡(Meta)
Anurag Kumar(Meta)
Marvin Sach(布伦瑞克工业大学)
王巍(上海交通大学)
Shinji Watanabe(卡内基梅隆大学)
Tim Fingscheidt(布伦瑞克工业大学)
钱彦旻(上海交通大学)
参考文献
[1] Haohe Liu, Xubo Liu, Qiuqiang Kong, Qiao Tian, Yan Zhao, DeLiang Wang, Chuanzeng Huang, and Yuxuan Wang, “VoiceFixer: A Unified Framework for High-Fidelity Speech Restoration,” in Proc. Interspeech, 2022, pp. 4232—4236.
[2] Joan Serrà, Santiago Pascual, Jordi Pons, R Oguz Araz, and Davide Scaini, “Universal Speech Enhancement with Score-Based Diffusion,” arXiv preprint arXiv:2206.03065, 2022.
[3] Xu Li, Qirui Wang, and Xiaoyu Liu, “MaskSR: Masked Language Model for Full-band Speech Restoration,” arXiv preprint arXiv:2406.02092, 2024.
[4] Robin Scheibler, Yusuke Fujita, Yuma Shirahata, and Tatsuya Komatsu, “Universal Score-based Speech Enhancement with High Content Preservation,” arXiv preprint arXiv:2406.12194, 2024.
[5] Wangyou Zhang, Robin Scheibler, Kohei Saijo, Samuele Cornell, Chenda Li, Zhaoheng Ni, Anurag Kumar, Jan Pirklbauer, Marvin Sach, Shinji Watanabe, Tim Fingscheidt, and Yanmin Qian, “URGENT Challenge: Universality, Robustness, and Generalizability For Speech Enhancement,” arXiv preprint arXiv:2406.04660, 2024.
[6] Wangyou Zhang, Kohei Saijo, Zhong-Qiu Wang, Shinji Watanabe, and Yanmin Qian, “Toward Universal Speech Enhancement for Diverse Input Conditions,” in Proc. IEEE ASRU, 2023.
[7] Wangyou Zhang, Jee-weon Jung, and Yanmin Qian, “Improving Design of Input Condition Invariant Speech Enhancement,” in Proc. IEEE ICASSP, 2024, pp. 10696–10700.
[8] Wangyou Zhang, Kohei Saijo, Jee-weon Jung, Chenda Li, Shinji Watanabe, and Yanmin Qian, “Beyond Performance Plateaus: A Comprehensive Study on Scalability in Speech Enhancement,” arXiv preprint arXiv:2406.04269, 2024.