
由上海交通大学听觉认知与计算声学实验室、卡内基梅隆大学、早稻田大学、布伦瑞克工业大学、Meta、Google Deepmind等单位联合举办的第三届URGENT语音增强挑战赛(Universality, Robustness, and Generalizability for EnhancemeNT)于9月1日正式开启!
第三届URGENT挑战赛是ICASSP 2026 Grand Challenge之一,旨在使用单个通用的语音增强模型统一处理具有不同失真,不同采样率,不同年龄、情感、语言、风格等情况的输入语音信号,并评估模型在多样化测试数据上的鲁棒性和泛化性。优秀参赛队伍可以受邀在ICASSP 2026提交系统报告论文,欢迎大家报名参加!
赛事官网:https://urgent-challenge.github.io/urgent2026/
比赛时间
开始时间:2025 年 9 月 1 日
结束时间:2025 年 11 月 7 日 23:59:59 (AOE 时区)
ICASSP 2026邀请论文投稿截止时间:2025 年 12 月 7 日
详情请查看:https://urgent-challenge.github.io/urgent2026/timeline
比赛目标
ICASSP 2026 URGENT挑战赛的目标是引起业界对构建通用(Universal)、鲁棒(Robust)且具备良好泛化能力(Generalizable)的语音增强模型的更广泛关注。今年的挑战赛重点聚焦以下几方面:
1. 大规模数据下的数据管理与利用:我们注意到近期的一些语音增强工作在尝试利用大规模训练数据时,遇到了明显的数据规模增长边际效应。本次比赛将侧重于探索更高效的大规模数据利用方式。
2. 在往届URGENT比赛的基础上,此次比赛将进一步强调模型的通用性: 将语音增强的应用扩展至包含不同年龄、不同口音、不同情感、更多语种、唱歌声、低语等更丰富的场景。
3. 语音质量评估赛道:本赛道致力于开发针对语音增强任务的语音质量评估模型。此次比赛提供了大规模、多样失真类型的数据集,充分利用了前两届挑战赛中积累的大量人工评分数据,用于开发适用于语音增强的语音质量评估模型。
赛道1:通用语音增强
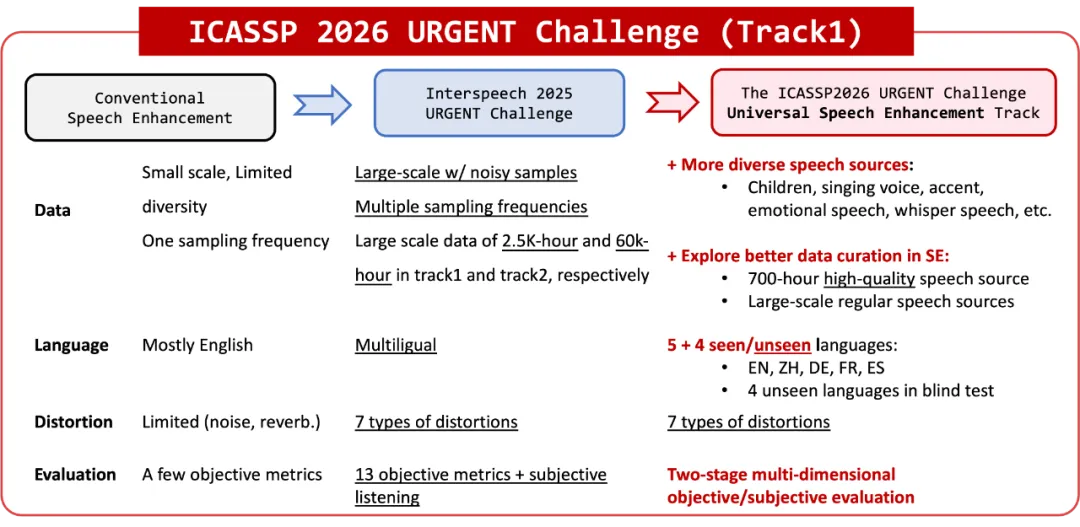
本赛道的任务是构建一个单一的语音增强系统,该系统需具备良好的适应性与泛化能力,能够处理多种失真类型(包括叠加噪声、混响、削波、带宽扩展、编码失真、数据包丢失和风噪)以及不同的输入语音格式(如多种采样率),并可应用于差异化的语音(不同语种、年龄、情感、歌声、轻语等)。
数据
如何高效地利用大规模数据训练是本次比赛的侧重点。我们挑选了700小时相对质量较高的语音源,并额外加入若干开源数据集进一步丰富语音的多样性。我们在官方的GitHub仓库发布了基线数据准备脚本,支持数据仿真以及训练阶段的动态混合。参赛者也可以直接从HuggingFace平台直接下载预仿真的版本快速开始模型训练。
除了基线提供的数据集,我们允许参赛队伍使用往届URGENT比赛的超过6万小时的大规模数据,探索高效的大规模数据利用方式,突破语音增强训练的数据增长边际效应。
基线系统
我们提供了两套模型:判别式语音增强,以及基于Flow的生成式语音增强作为基线,以帮助参赛者开始系统开发。具体的训练脚本及预训练模型,请点击“阅读原文”查看官网,或访问GitHub仓库获取:https://github.com/urgent-challenge/urgent2026_challenge_track1/
评估指标
为了更全面地评估增强后音频的质量和实用性,在最终排名阶段,本次挑战赛将采用两阶段、多维度的指标体系,对各类语音增强方法进行深入评测。在第一阶段,我们会通过多维度客观指标对参赛模型进行综合打分,在盲测数据集上排名前6的系统将进入第二阶段进行主观评测打分,确定最终名次。
客观评估指标分为以下四类:
- 非侵入性指标(例如DNSMOS、NISQA、UTMOS等)用于无参考的语音质量评估。
- 侵入性指标(例如PESQ、ESTOI等)用于客观的语音质量评估。
- 下游任务独立指标(例如LPS、SpeechBERTScore等)用于进行语言无关、说话人无关和下游任务无关的评估。
- 下游任务相关指标(例如说话人相似度、情感相似度等)用于评估语音增强结果与不同下游任务间的兼容性。
主观评估通过众包平台完成,参考ITU-T P.808进行:
- 绝对类别评分(ACR),得到的平均意见得分(MOS);
- 比较类别评分(CCR),得到的比较平均意见得分(CMOS)。
赛道2:语音质量评估
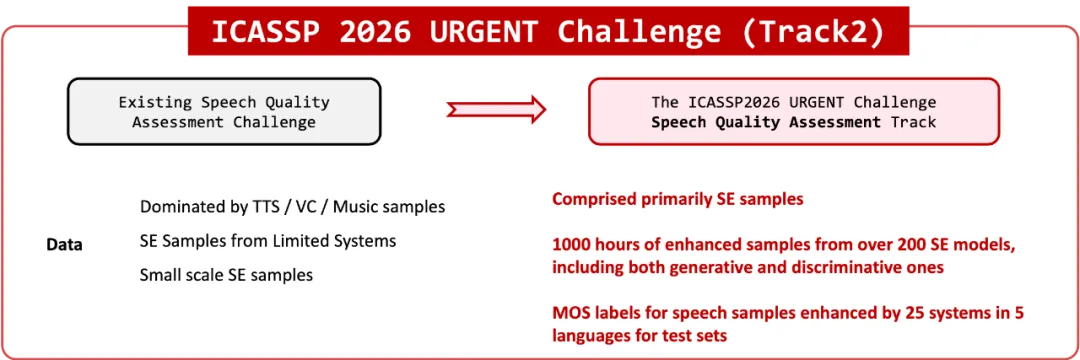
本赛道旨在构建一个稳健且具备良好泛化能力的语音质量评估(Speech Quality Assessment, SQA)模型,用于预测增强语音的平均意见分(Mean Opinion Scores, MOS)。不同于主要聚焦于音乐与合成语音的 VoiceMOS 和 AudioMOS 系列竞赛,本赛道的核心目标在于评估增强语音的质量。为此,我们提供过去两届比赛的大量增强系统处理过的增强语音,包含人工MOS标注。
数据
为帮助参赛者及研究社区构建更优的增强系统语音质量评估模型,我们提供了来自 URGENT24 和 URGENT25 参赛者提交的增强语音数据,这是首个面向增强系统的大规模语音质量评估数据集。该数据集涵盖 200 余个不同系统生成的1000 小时增强语音,其中来自 25 个系统的部分语音样本配备了人工标注的 MOS 分数,覆盖普通话、英语、法语、德语和西班牙语五种语言,并包含判别式与生成式两类系统。我们期望这些来源多样的增强语音数据能够协助参赛者开发出更适用于增强系统的语音质量评估模型,并进一步推广至语音合成和语音转换模型的质量评估任务中。
基线系统
我们提供了基于多指标预测模型 Uni-VERSA-Ext 的 MOS 预测基线。具体的训练脚本及预训练模型,请点击“阅读原文”查看官网,或访问 GitHub 仓库获取:https://github.com/urgent-challenge/urgent2026_challenge_track2/
同时,您也可以通过 Colab 直接体验基线模型的效果:https://colab.research.google.com/drive/1Y2OkPE0hGSG4XRj_b7RsmWMVSg4KkhM7
评估指标
系统将基于预测的 Mean Opinion Scores (MOS) 与真实 MOS 标签之间的相关性指标和误差指标进行评估。具体使用的指标如下:
- Spearman’s Rank Correlation Coefficient (SRCC) 和 Kendall’s Tau (KTAU):用于评估预测分数与真实分数在排名上的相关性。
- Mean Squared Error (MSE):衡量预测分数与真实分数之间的均方误差。
- Linear Correlation Coefficient (LCC):评估预测分数与真实分数之间线性关系。
联系方式
- 欢迎加入挑战赛的官方 Slack 聊天频道进行提问和沟通,加入方式见:https://urgent-challenge.github.io/urgent2026/
- 此外,也可以通过发送邮件进行沟通:urgent.challenge@gmail.com。
- 或扫码加入微信赛事沟通群:
赛事组织者
- 李晨达(上海交通大学)
- 王巍(上海交通大学)
- 张王优(上海交通大学)
- Kohei Saijo(早稻田大学)
- Marvin Sach(布伦瑞克工业大学)
- Samuele Cornell(卡内基梅隆大学)
- 付艺辉(布伦瑞克工业大学)
- Robin Scheibler(Google Deepmind)
- 倪兆衡(Meta)
- Anurag Kumar(Google Deepmind)
- Tim Fingscheidt(布伦瑞克工业大学)
- Shinji Watanabe(卡内基梅隆大学)
- 钱彦旻(上海交通大学)