
 语音小管家
本期推送将介绍上海交通大学听觉认知与计算声学实验室与 VUI Labs 联合完成的研究论文《DeepASMR: LLM-Based Zero-Shot ASMR Speech Generation》,分享一项基于大语言模型的零样本 ASMR 语音生成研究,解读其研究背景、核心方法与实验成果。
随着大规模生成式文本到语音(TTS)技术的快速发展,NaturalSpeech、Voicebox、F5-TTS、CosyVoice 等模型在朗读式(read-style)语音上已经达到接近真人的自然度,并支持零样本音色克隆。然而,当前 TTS 研究几乎都聚焦于"有声、朗读风格"的中性语音,对高情感、非常规发声风格的建模能力仍然有限。ASMR(Autonomous Sensory Meridian Response,自主性感觉经络反应)作为一种以极轻柔气声化发声为特征的特殊语音风格,被广泛用于放松、助眠、缓解焦虑与慢性疼痛,被听众誉为"声音安眠药",但至今尚无 TTS 系统能真正做到"零样本 ASMR 合成"——即只用目标说话人的普通语音,就合成他/她本人音色的 ASMR。如何在缺乏目标说话人 ASMR 参考的情况下,实现风格与音色的解耦生成,成为语音合成领域亟待突破的关键问题。
近期,上海交通大学听觉认知与计算声学实验室与 VUI Labs 合作的论文 "DeepASMR: LLM-Based Zero-Shot ASMR Speech Generation" 聚焦 ASMR 语音合成领域,针对该技术在零样本泛化困难、气声无声成分难以合成等方面的问题,提出了融合大语言模型(LLM)语义建模、条件流匹配声学解码、虚拟说话人池 Task Prompt 自动选择与两阶段"风格–音色解耦"训练的创新解决方案,相关成果为放松助眠、心理健康、沉浸式媒体等场景提供了重要技术支撑。
DeepASMR: LLM-Based Zero-Shot ASMR Speech Generation
作者列表:张乐莹、周庭孝、孙海洋、毕梦霄、钱彦旻
合作单位:上海交通大学、VUI Labs
论文原文:https://ieeexplore.ieee.org/document/11623470
代码开源:https://github.com/vivian556123/DeepASMR
数据集开源:https://huggingface.co/datasets/Leying/DeepASMR-dataset
Demo:https://vivian556123.github.io/deepasmr-demo/
研究背景与动机
ASMR 作为一种独特的语音风格,其声学特征与常规语音存在本质差异:
- 发声机制不同:ASMR 大量使用清声(unvoiced)气声,声带几乎不振动,与正常语音以浊音(voiced)为主的模式形成鲜明对比;
- 韵律特征不同:ASMR 语速慢、元音时长更长、共振峰频率更高,且富含呼吸声、微小口腔摩擦等 ASMR 特有的沉浸感线索;
- 生理效应独特:ASMR 会促使大脑分泌内啡肽与血清素、降低皮质醇水平,从而带来显著的放松与助眠效果。
尽管现代 TTS 已能高保真合成朗读语音,但在 ASMR 生成上仍面临两大瓶颈:
- 零样本泛化不足:现有 In-Context Learning、Voice Conversion、任务微调等方法几乎都要求目标说话人本人的 ASMR 参考音频,无法从一段普通语音直接迁移到 ASMR 风格;
- 声学真实度受限:现有方法往往把耳语当作"风格迁移"或"加噪"处理,忽略了气声与无声语言内容之间的复杂交互,难以真正再现 ASMR 的沉浸感。
为此,本文提出以下创新策略:
- 提出首个零样本、说话人无关的 ASMR 生成框架 DeepASMR,仅用目标说话人一段普通朗读语音即可合成他/她的 ASMR 语音;
- 首次揭示并利用离散语音 token 中"风格主导、音色残余"的信息不对称性,为分层建模提供实证依据;
- 设计基于虚拟说话人池(Virtual Speaker Pool)的 Task Prompt 自动检索机制,缓解跨风格合成中的"音色漂移"问题;
- 构建目前最大规模、公开可用的中英双语 ASMR 语音数据集 DeepASMR-DB(670 小时、34 位说话人);
- 提出融合客观指标、主观 MOS、LLM 打分、无声语音分析的多维度评测协议,突破传统指标对 ASMR 评估的局限。
技术方案
🔍 整体框架:LLM + Flow-Matching 两阶段生成架构
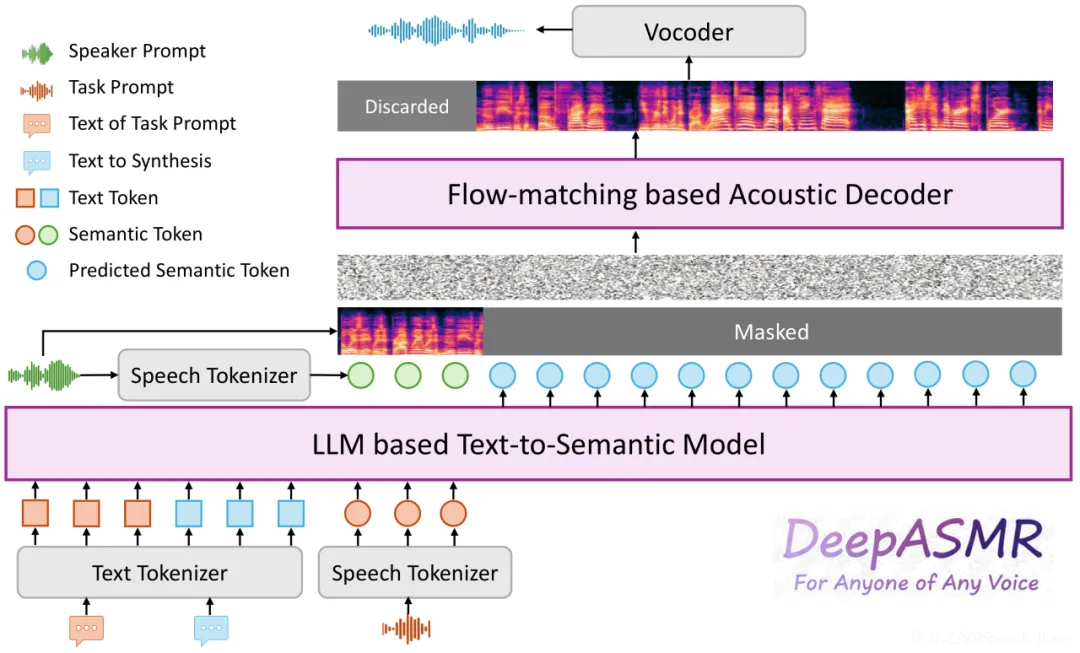
图1 DeepASMR 整体框架示意图
DeepASMR 采用两阶段级联的生成架构,将语义建模与声学重建解耦。输入包含三部分:目标文本 T、任务提示 Task Prompt(提供目标风格信息)、说话人提示 Speaker Prompt(提供目标音色信息),输出为目标说话人音色的目标风格语音。
第一阶段:LLM 文本到语义模块
以 Qwen2.5-0.5B 初始化的 decoder-only 大模型作为"内容–风格编码器",输入拼接 Task Prompt的文本、目标文本和Task Prompt的离散语音token,自回归预测一段离散语音 token(S3 tokens),使用标准 Cross-Entropy 损失优化。
第二阶段:Flow-Matching 声学解码器
基于 Voicebox 结构的条件流匹配网络,以第一阶段的 token 序列和 Speaker Prompt 的 mel 谱作为条件,重建目标 mel 谱,再经 一个独立的HiFi-GAN 声码器合成波形。该模块负责补齐精细音色细节。
🔍 Token 级"风格–音色不对称性"分析
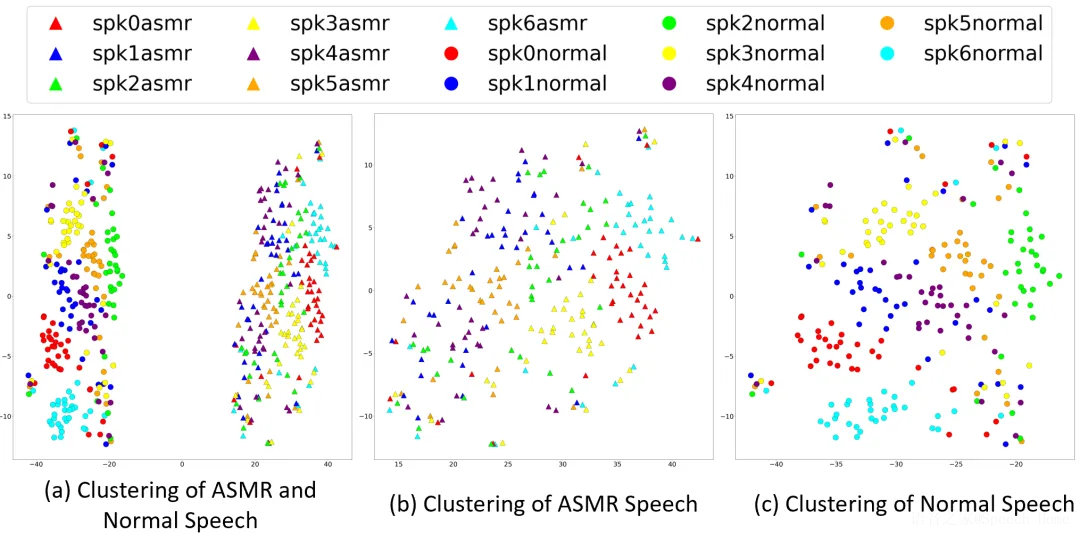
图2 S3 tokenizer 隐藏状态的 t-SNE 可视化结果
我们对 S3 tokenizer 量化前的隐藏状态做 t-SNE 可视化,发现两个关键现象:(1)风格主导分布:Normal 与 ASMR 在嵌入空间中存在清晰的超平面分离,风格差异主导了 token 空间的方差;(2)音色残余信息:同风格簇内不同说话人仍表现出弱但可辨的聚类倾向。进一步用 CNN 说话人分类器在 S3 token 隐藏状态上训练,说话人识别准确率可达 86.4%(Mel-spectrogram 基线 90%,随机猜测 2.8%),定量证实"token 保留了大量说话人信息"。这正是"用 LLM 建模风格 + Flow-Matching 建模音色"双阶段策略的理论依据。
🔍 虚拟说话人池与 Task Prompt 自动选择
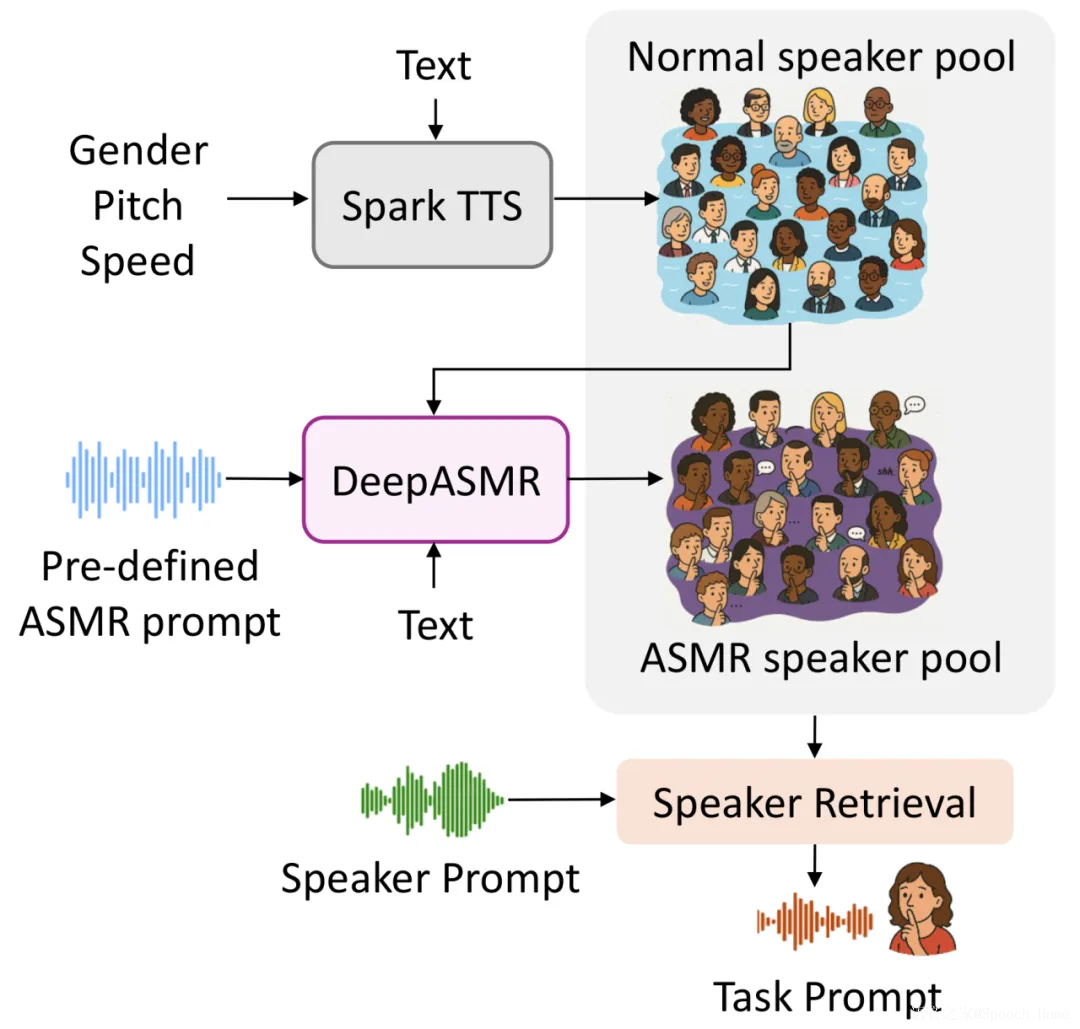
图3 虚拟说话人池构建与 Task Prompt 检索示意图
在跨风格合成(Normal→ASMR)任务中,如果随意选一段他人 ASMR 作为 Task Prompt,输出音色会向该参考说话人漂移,产生"音色串扰"。为此我们构建了两个虚拟说话人池:(1)Normal Pool:由 SparkTTS 系统地在性别、音高、语速三个维度上变换生成 50 条合成语音,覆盖多样音色画像;(2)ASMR Pool:以预定义的高质量 ASMR 样本作为 Task Prompt、以 Normal Pool 中 50 条语音作为 Speaker Prompt,通过 DeepASMR 一一映射生成 50 条 ASMR 语音。推理时,利用 WeSpeaker 提取目标说话人 embedding,与池中候选做余弦相似度检索,选取最相近的合成样本作为 Task Prompt。该方案兼具可扩展性与隐私保护,避免了直接使用真实 ASMR 参考的音色漂移问题。
🔍 DeepASMR-DB 数据集构建
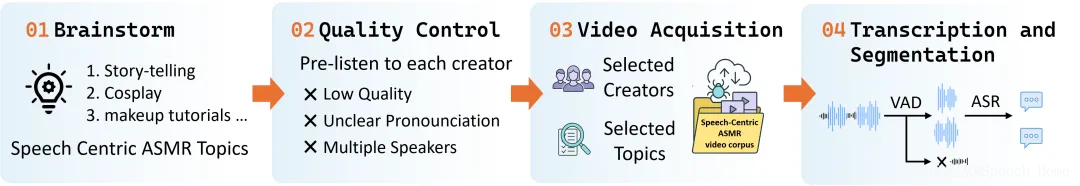
图4 DeepASMR-DB 数据构建流程
配套论文,我们发布了首个大规模公开 ASMR 语音数据集 DeepASMR-DB。数据构建流程包括四个阶段:
(1)主题筛选:优先选取九类以语音为主的 ASMR 内容(故事叙述、问答、Cosplay、化妆教程、诗朗诵、科普/历史、看图说话、游戏解说、个人观点),并排除以敲击、咀嚼为主的非语音触发内容;
(2)创作者质量把控:人工审核创作者的发声一致性与录音质量,仅保留至少 80% 采样片段合格的创作者;
(3)视频采集:对每位入选创作者的目标主题视频进行系统化下载;
(4)转写与切分:使用 Microsoft Fast Transcription API 完成 ASR 标注,切分时刻意保留呼吸声与轻微口腔摩擦音等 ASMR 特征线索,仅剔除纯静音段。
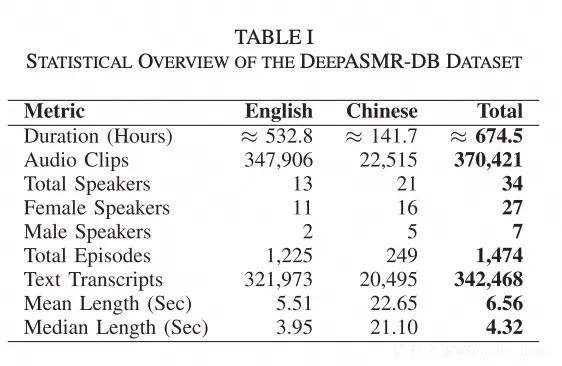
表1 DeepASMR-DB 数据集统计概览
最终数据集共包含 674.5 小时音频、370,421 条精细标注片段、1,474 个视频、34 位独立说话人(女 27 / 男 7),中英双语(英文 532.8 小时 / 中文 141.7 小时),是目前已知最大规模的公开 ASMR 语音数据集,采用 CC BY-NC 4.0 协议发布。
实验数据及配置
🔍 训练与测试数据
训练阶段采用两阶段策略:(1)预训练:在 200,000 小时内部数据(中文 8 万 + 英文 12 万小时)上训练 250k 步;(2)微调:在 DeepASMR-DB 与 Emilia(正常语音)混合数据上继续训练,LLM 与声学解码器分别微调 10 与 40 个 epoch。混合数据策略对于防止模型对 ASMR 过拟合、保留正常语音合成能力至关重要。
测试集设计为 8 个子集(2 种语言 × 4 个子任务):Normal→Normal(N2N)、ASMR→ASMR(A2A)为同风格合成;ASMR→Normal(A2N)、Normal→ASMR(N2A)为跨风格合成,其中 N2A 是本文核心任务。英文测试采用 CHAINS(36 位说话人),中文测试采用 Whisper40(40 位说话人),所有说话人与训练数据完全不重叠。
🔍 评测指标
- 客观指标: WER/CER(Whisper 与 Paraformer 转写)、SIM(WavLM-Large 提取的说话人相似度);
- 主观指标: 16 位听音者的 OI-MOS(整体听感)与 ASMR-MOS(放松/酥麻感),采用 web-MUSHRA 模板随机化呈现顺序以避免偏差;
- LLM-based 指标: 基于 Gemini 2.5 Pro 的连续风格打分(−1 = Normal,+1 = ASMR),在 0.2 阈值下与人工评价的一致率为 88%,Pearson 相关系数 0.83;
- 清音语音指标: 基于 PYIN 算法的帧级分析,计算 Global Unvoiced Ratio(清音帧占比 R_UV),用于量化模型是否真正合成了气声。
实验结果
🔍 客观指标评测与 LLM 风格打分
01 同风格合成结果
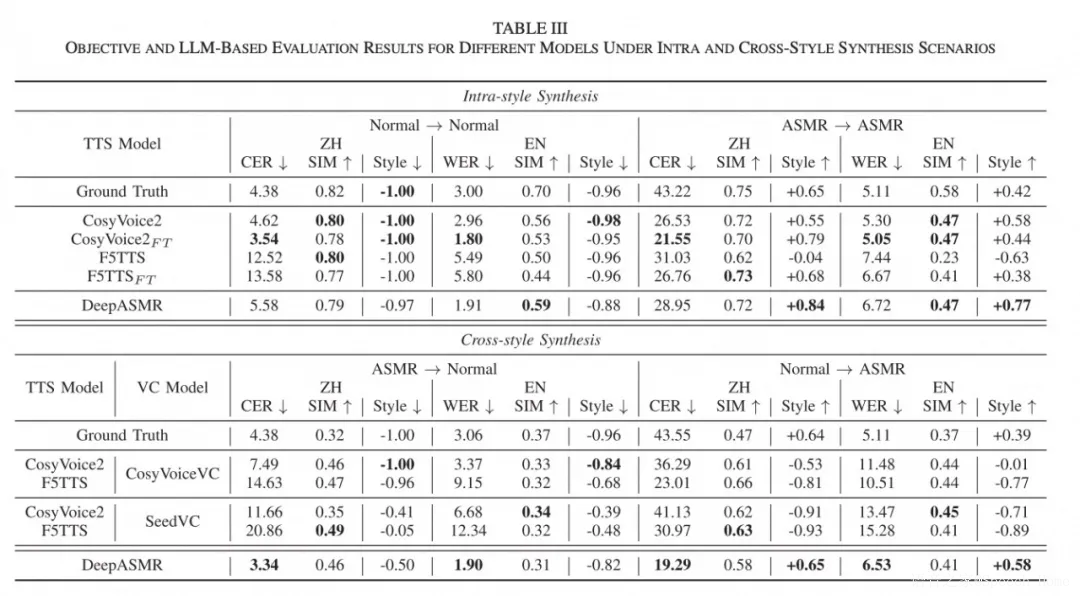
表2 不同模型在同风格与跨风格合成任务上的客观与 LLM 评测结果
在 A2A 任务上,DeepASMR 取得了所有模型中最高的 LLM 风格分数(ZH +0.84 / EN +0.77),显著超过 CosyVoice2 与 F5TTS 的原版及在 DeepASMR-DB 上微调后的版本,说明其对 ASMR 风格的建模最为忠实。在 N2N 任务上,DeepASMR 与主流通用 TTS 保持相当水平,说明"专攻 ASMR"并未损害正常语音合成能力。
02 跨风格合成结果
在最具挑战的 N2A(Normal→ASMR)任务上,DeepASMR 在两种语言上均取得了最低的错词率(英文 WER 6.53%、中文 CER 19.29%),显著优于所有 TTS+VC 级联基线。更重要的是,DeepASMR 是唯一一个在跨风格任务中取得较高的Style 分数(ZH +0.65 / EN +0.58)的模型,与真值风格强度高度接近;而所有 VC 级联基线的 Style 分数普遍为负,说明它们根本没有把风格转换过去。在 SIM 上,DeepASMR 几乎达到"跨风格保音色"的理论上限——真值本身在同说话人跨风格时 SIM 也只有 0.37–0.47。
🔍 主观 MOS 评测
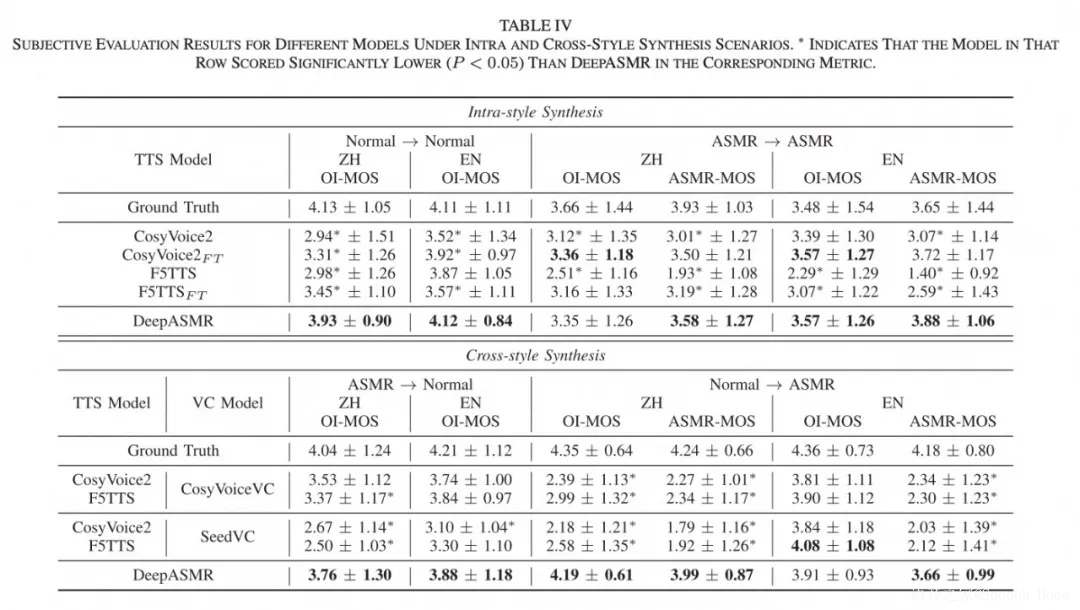
表3 不同模型在同风格与跨风格合成任务上的主观 MOS 评测结果
在 N2A 任务上,DeepASMR 的 ASMR-MOS 达到 ZH 3.99 / EN 3.66,接近真值 ASMR 水平,大幅领先所有级联基线(多数带 * 号显著低于 DeepASMR,P<0.05)。有趣的是,SeedVC 在英文 N2A 上 OI-MOS 较高但 ASMR-MOS 很低——它合成的是"清晰的耳语式正常语音"而非真正的 ASMR,缺乏那种酥麻感的清音纹理。这进一步证明 DeepASMR 是当前唯一能同时在音质与 ASMR 舒适度上兼顾的方案。
🔍 Task Prompt 选择策略消融
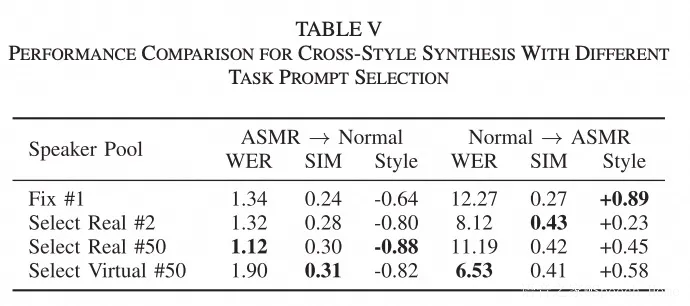
表4 不同 Task Prompt 选择策略在跨风格任务上的性能对比
对比四种策略:固定单条 prompt、从 2 条真实语音检索、从 50 条真实语音检索、从我们提出的 50 条虚拟语音池检索。固定 prompt 会导致最严重的音色漂移;扩大候选池能显著改善说话人保持;而我们提出的虚拟池方案与真实池方案性能相当,同时具备可扩展性与隐私友好性,验证了合成语料同样可以成为虚拟语音池。
🔍 训练数据配比消融
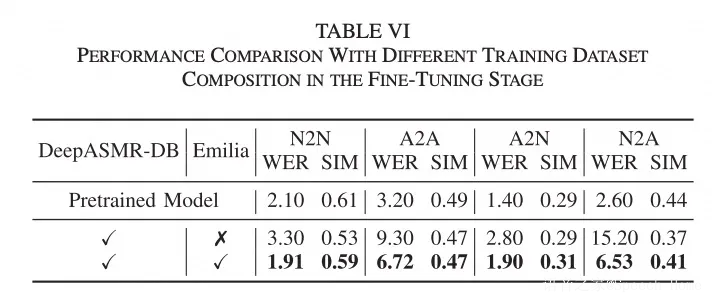
表5 不同微调数据构成对模型性能的影响
仅在 DeepASMR-DB 上微调会引发"灾难性遗忘"——模型丢失对正常语音的通用建模能力。混入 Emilia 正常语音数据后,不仅 N2N 的 WER 从 3.30 降至 1.91,甚至 N2A 的 WER 也从 15.20 大幅降至 6.53。这说明保留正常语音的通用理解能力,反而更好地服务于风格转换任务。
🔍 迭代推理精修
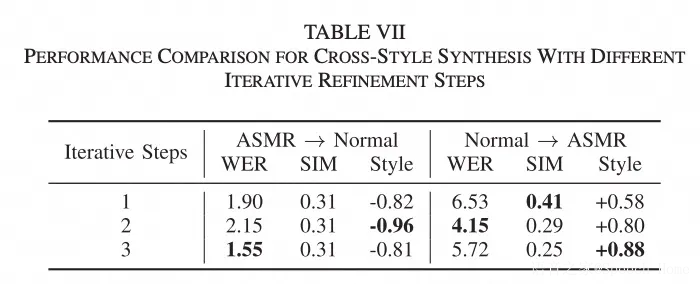
表6 不同迭代推理步数下的跨风格合成性能
将输出再作为 Speaker Prompt 迭代 2–3 次,能进一步强化 ASMR 风格(Style 从 +0.58 提升到 +0.88),但会牺牲一定音色相似度(SIM 从 0.41 降到 0.25)。因此默认使用 1 步作为平衡点;若下游任务对"酥麻感"要求极高、对音色一致性要求相对宽松,可增加迭代步数以获得更极致的 ASMR 体验。
🔍 无声语音能力分析
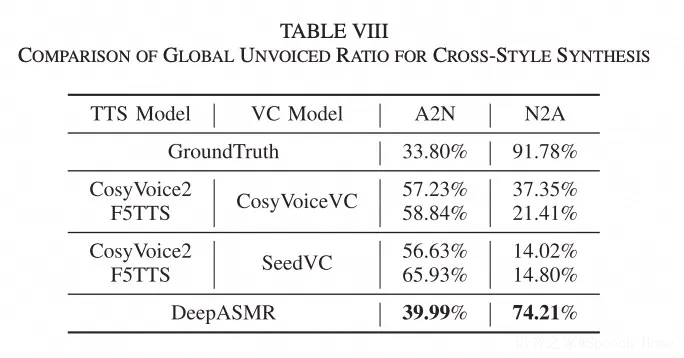
表7 不同模型在跨风格合成任务上的 Global Unvoiced Ratio 对比
在 N2A 任务上,DeepASMR 达到 74.21% 的无声帧占比,远超所有 TTS+VC 级联基线(普遍低于 40%),说明只有 DeepASMR 真正"关闭了声带振动",合成出真实的气声 ASMR。在反向的 A2N 任务上,DeepASMR 又能准确回到接近真人正常语音的清音比例,说明模型可以在"浊音"和"清音"两种发声机制间稳定切换。
🔍 与商业 TTS 模型对比
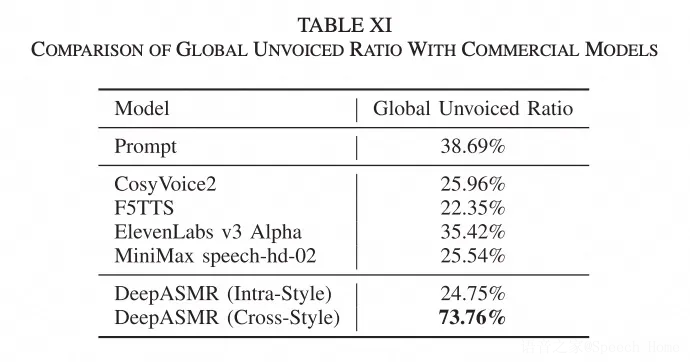
表8 DeepASMR 与商业模型在 Global Unvoiced Ratio 上的对比
我们进一步与 ElevenLabs v3 Alpha、MiniMax speech-hd-02 等商业大模型对比。这些商业模型自然度高,但 ASMR 合成主要依赖声带振动,其清音占比仅为 25%–35%,仅覆盖了 ASMR 声学光谱中较窄的一段。DeepASMR 在跨风格设置下清音占比高达 73.76%,是目前唯一能在未见说话人上合成"真正气声 ASMR"的方案。
本文总结
本文提出的 DeepASMR 框架,通过五大创新点突破了 ASMR 合成的现有瓶颈:
- 提出首个零样本、说话人无关的 ASMR 生成框架,仅需一段目标说话人的普通朗读语音即可合成其 ASMR;
- 揭示了离散语音 token 中"风格主导、音色残余"的信息不对称性,为 LLM + Flow-Matching 的双阶段分层建模提供了实证与理论依据;
- 设计基于虚拟说话人池的 Task Prompt 自动检索机制,有效缓解跨风格合成中的音色漂移问题;
- 发布 670 小时、34 位说话人、中英双语的 DeepASMR-DB 数据集,是目前最大的公开 ASMR 语料库;
- 提出融合客观、主观、LLM 打分与无声语音分析的多维度评测协议,全面刻画 ASMR 生成质量。
在 CHAINS 与 Whisper40 等公开测试集上,DeepASMR 在 ASMR 合成质量、说话人保持度、无声语音真实度等多个维度上均实现了当前最优(SOTA)性能,同时在常规 TTS 任务上保持了与主流方法相当的表现,为放松助眠、心理健康、沉浸式媒体等应用场景提供了高质量的语音合成技术支撑。同时,我们也就 DeepASMR 可能带来的语音伪造与声纹安全盲区风险进行了公开讨论,呼吁在推动生成技术的同时同步发展相应的反伪造检测方法。
参考文献
[1] K. Poerio et al., "More than a feeling: Autonomous sensory meridian response (ASMR) is characterized by reliable changes in affect and physiology," PLoS ONE, 2018.
[2] Z. Du et al., "CosyVoice: A scalable multilingual zero-shot text-to-speech synthesizer based on supervised semantic tokens," arXiv preprint, 2024.
[3] Y. Chen et al., "F5-TTS: A fairytaler that fakes fluent and faithful speech with flow matching," ACL 2025.
[4] M. Le et al., "Voicebox: Text-guided multilingual universal speech generation at scale," NeurIPS, 2023.
[5] A. Qwen et al., "Qwen2.5 technical report," arXiv preprint, 2025.
[6] H. He et al., "Emilia: An extensive, multilingual, and diverse speech dataset for large-scale speech generation," SLT 2024.
