
 新一代Kaldi
上一期我们发布了最终版的 Zipformer 模型及其在 LibriSpeech 上表现,为了证明模型不是针对 LibriSpeech 的调优, 本期将更新 Zipformer 在 WenetSpeech 数据集上的结果,本文不涉及任何模型细节的描述,只是更新结果及发布模型,Demo 视频见文末。
模型配置
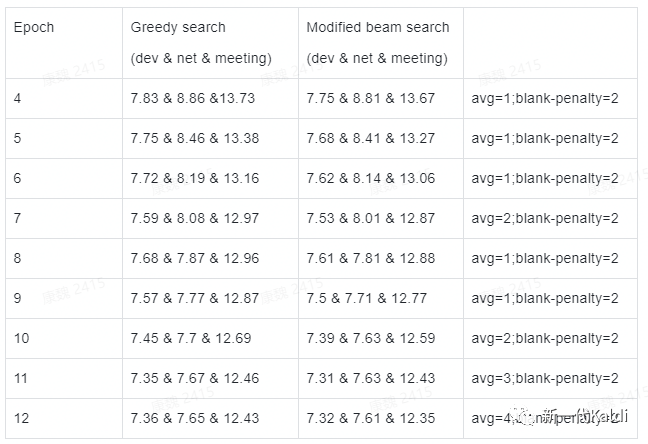
非流式模型结果
注:模型训练过程中使用了 3 倍扩增,即可以认为这里的 Epoch 为未扩增的 1/3
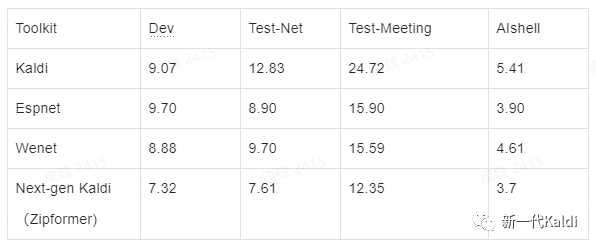
与现有开源工具结果的比较
注:数据来源为 WenetSpeech 原论文,Zipformer 结果为 epoch=12, beam search 结果。
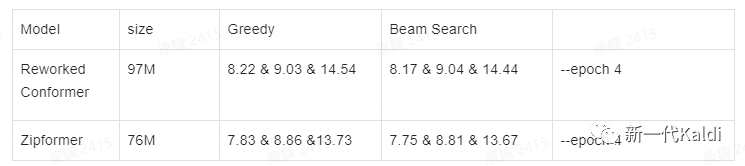
与 Icefall 中 reworked conformer 模型的比较
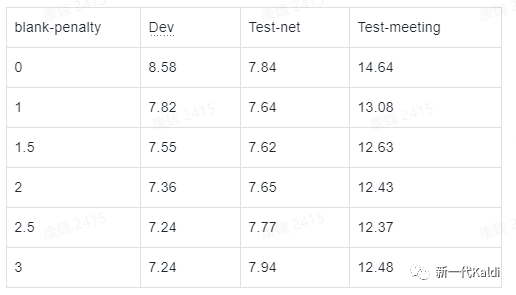
关于 blank-penalty
实验中我们发现解码时对 blank 做一些惩罚可以提高识别准确率,这一现象在我们之前的 reworked comformer 模型中并不出现。下表为 epoch=12, greedy search 的结果。
模型下载链接:
https://huggingface.co/pkufool/icefall-asr-zipformer-wenetspeech-20230615
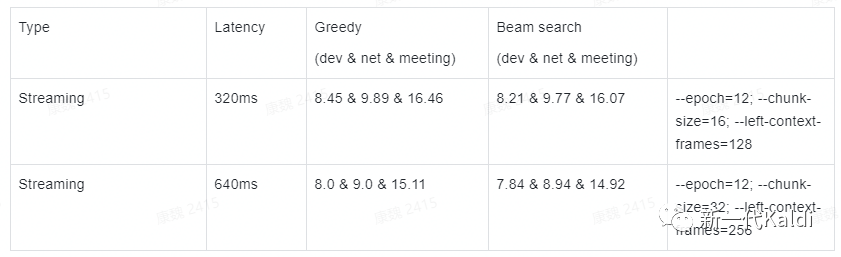
流式模型的结果
最佳结果
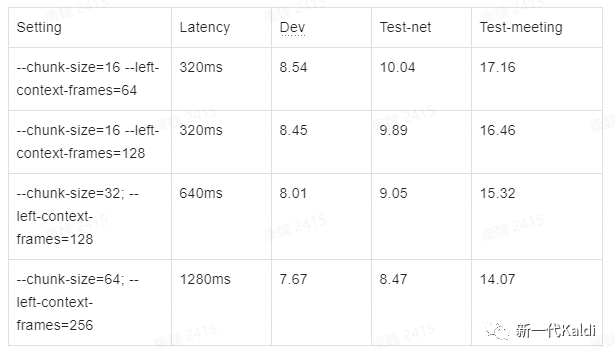
其他时延配置的结果
下表为 epoch=12 的 Greedy search 结果,blank-penalty=1.5
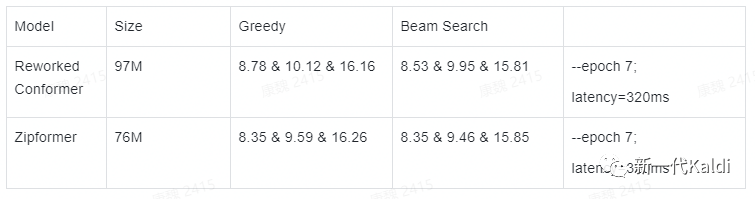
跟 reworked conformer 结果的比较
模型下载链接:
https://huggingface.co/pkufool/icefall-asr-zipformer-streaming-wenetspeech-20230615
总结
Zipformer 模型在大数据量 (10000小时)中文数据集上也取得了优异的结果,数据显示 Zipformer 在 WenetSpeech 数据集的识别错误率上优于现有的系统,这表明 Zipformer 是一个完全胜任工业级应用的高效模型。
