
 语音小管家
1. 简介
新一代Kaldi部署框架sherpa-onnx[1]支持的编程语言API大家庭中, 最近增加了一个新成员Dart[2],使得支持的编程语言达到了 10 种。
支持了Dart, 意味着大家可以在Dart中使用sherpa-onnx提供的所有功能,即
• 语音合成 (Text to speech)
• 语音识别 (Speech recognition)
• 语音活动检测 (Voice activity detection)
• 声音事件检测 (Audio tagging)
• 说话人识别和验证 (Speaker identification and verification)
• 关键词检测 (keyword spotting)
下图总结了sherpa-onnx目前支持的编程语言及DartAPI 支持的功能。
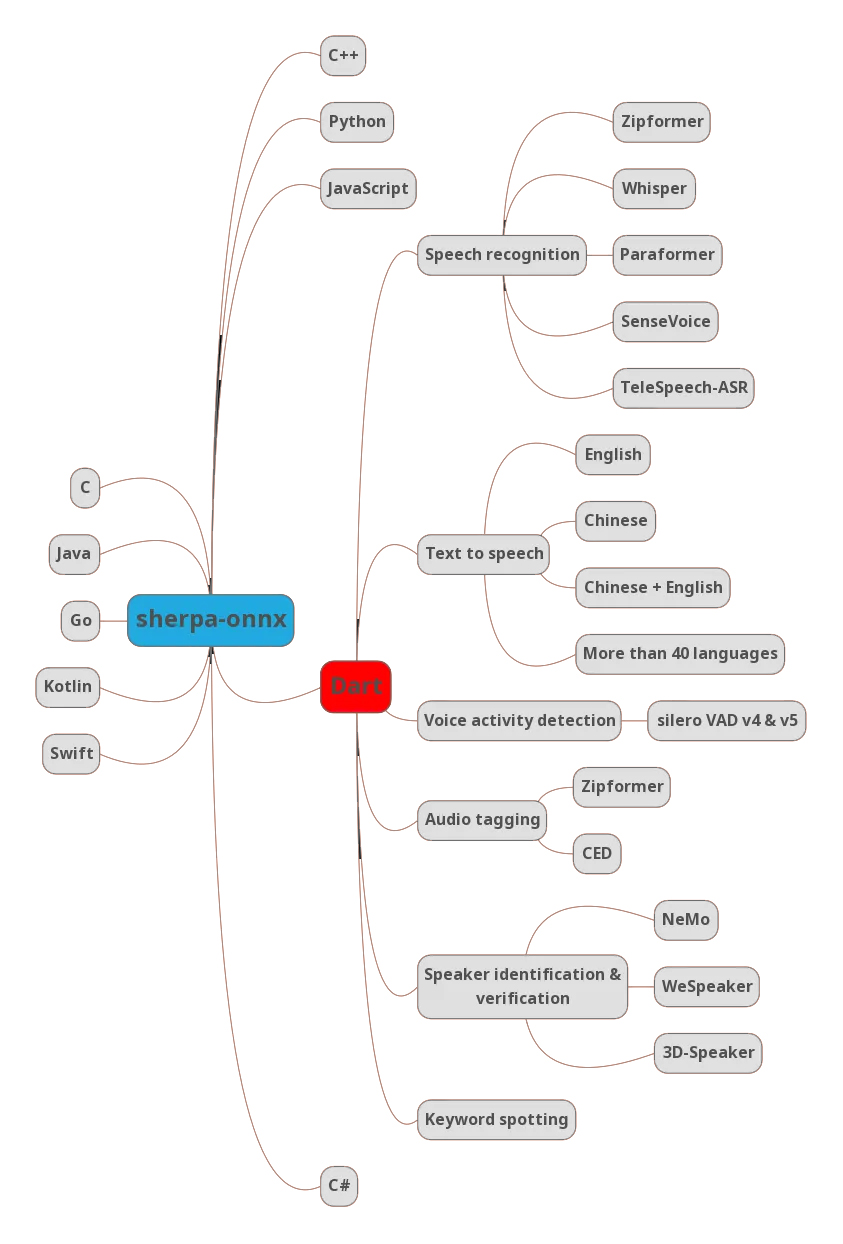
注: 上述图片的高清 pdf 文档,可以从下面地址[3]获得
https://github.com/k2-fsa/next-gen-kaldi-wechat/blob/master/pdf/sherpa-onnx-dart-functions.pdf
支持了Dart, 也意味着大家可以利用Flutter[4]开发跨平台的应用。对此,我们提供了sherpa_onnx包,并发布在 https://pub.dev/ 。如下图所示。
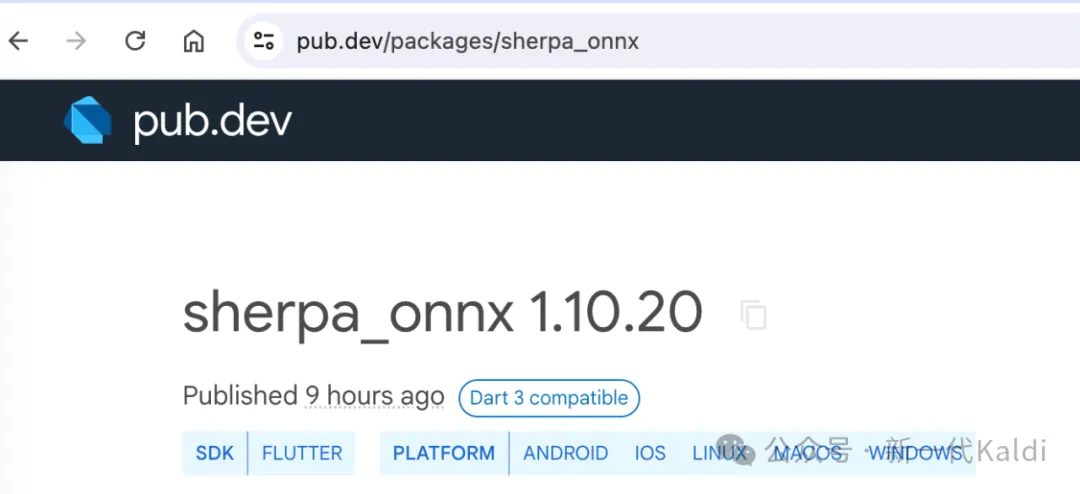
发布的 Dart 包,支持如下平台:
• Android (arm64-v8a, armv7-eabi, x86, x86_64)
• iOS (arm64)
• Linux (x64)
• macOS (x64, arm64)
• Windows (x64)
本文剩余部分通过手把手教的方式,介绍如何通过Dart和Flutter,使用语音合成、语音识别、语音活动检测和声音事件检测。
2. 安装
我们提供了sherpa_onnxDart 包[5], 大家可以像使用其他Dart包一样,在pubspec.yaml文件中加入如下两行即可:
dependencies:sherpa_onnx: ^1.10.20注:推荐永远使用最新版本。
我们提供的Dart包里面包含了每个平台的预编译动态库。因此安装过程只涉及文件下载, 并不需要编译sherpa-onnx的C++源代码。
3. 语音合成
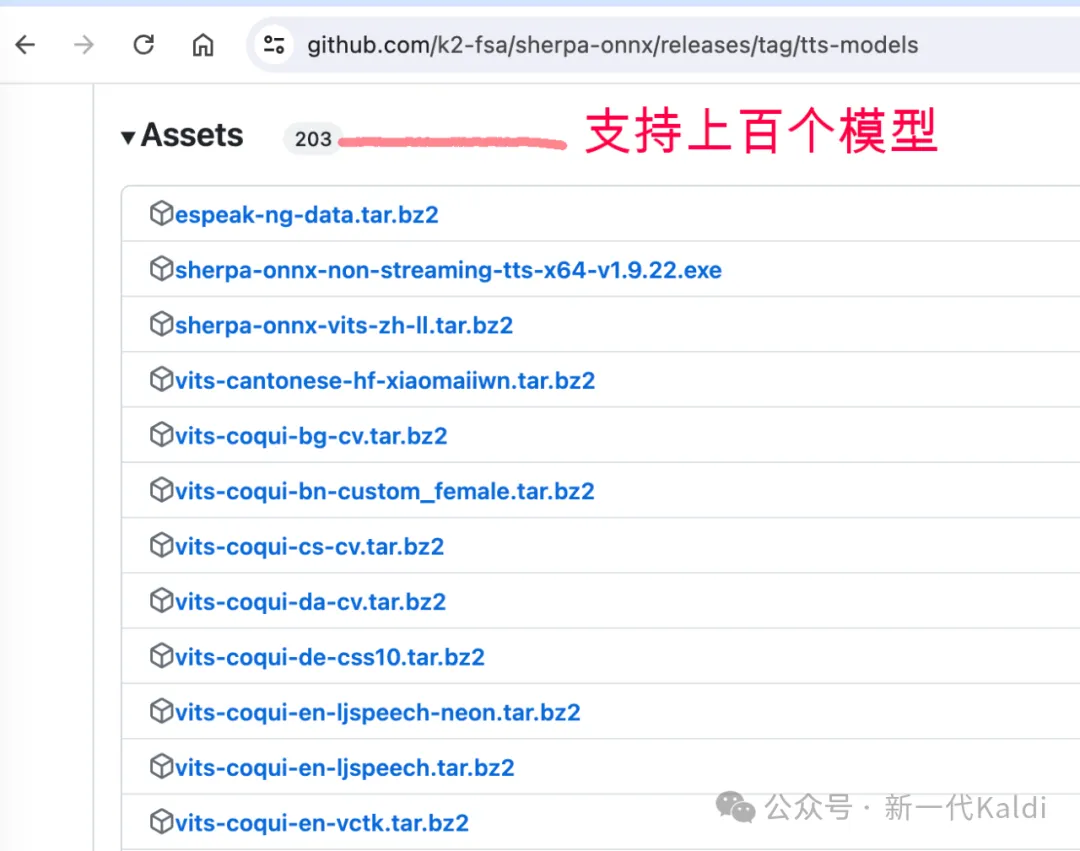
目前我们支持基于VITS[6]的语音合成模型。提供超过40种语言的语音合成, 比如中文、英文、中英文、德语等。
我们提供的语音合成模型,可以从下述地址[7]下载
https://github.com/k2-fsa/sherpa-onnx/releases/tag/tts-models
下面我们分别介绍使用纯DartAPI 的语音合成和基于 Flutter 的语音合成。
3.1 基于 Dart 的语音合成
基于纯Dart的语音合成例子代码,可以从下述网址[8]找到。
https://github.com/k2-fsa/sherpa-onnx/tree/master/dart-api-examples/tts
我们使用一个英文的模型作为例子,演示如何运行:
gitclonehttps://github.com/k2-fsa/sherpa-onnxcdsherpa-onnx/dart-api-examples/ttsdart pub getcurl -SL -O https://github.com/k2-fsa/sherpa-onnx/releases/download/tts-models/vits-piper-en_US-libritts_r-medium.tar.bz2tar xf vits-piper-en_US-libritts_r-medium.tar.bz2rmvits-piper-en_US-libritts_r-medium.tar.bz2dart run \./bin/piper.dart \--model ./vits-piper-en_US-libritts_r-medium/en_US-libritts_r-medium.onnx \--tokens ./vits-piper-en_US-libritts_r-medium/tokens.txt \--data-dir ./vits-piper-en_US-libritts_r-medium/espeak-ng-data \--sid 109 \--speed 1.0 \--text'liliana, the most beautiful and lovely assistant of our team!'\--output-wav en-109.wavdart run \./bin/piper.dart \--model ./vits-piper-en_US-libritts_r-medium/en_US-libritts_r-medium.onnx \--tokens ./vits-piper-en_US-libritts_r-medium/tokens.txt \--data-dir ./vits-piper-en_US-libritts_r-medium/espeak-ng-data \--sid 200 \--speed 1.0 \--text"That's one small step for a man, a giant leap for mankind."\--output-wav en-200.wavdart run \./bin/piper.dart \--model ./vits-piper-en_US-libritts_r-medium/en_US-libritts_r-medium.onnx \--tokens ./vits-piper-en_US-libritts_r-medium/tokens.txt \--data-dir ./vits-piper-en_US-libritts_r-medium/espeak-ng-data \--sid 500 \--speed 1.0 \--text"Ask not what your country can do for you; ask what you can do for your country."\--output-wav en-500.wav生成的音频如下
3.2 基于 Flutter 的语音合成
基于 Flutter 的语音合成例子代码可以在下述链接[9]找到
https://github.com/k2-fsa/sherpa-onnx/tree/master/flutter-examples/tts为了方便大家操作,我们特意制作了一个视频,从零开始,一步一步向大家演示如何进行中英文的语音合成。视频如下:
注:你也可以前往 B 站观看上述视频。地址[10]为 https://www.bilibili.com/video/BV1fgvyeqEMp/
注:视频里用的是 macOS,但基于 Flutter 的语音合成也能够在 Android, iOS, Linux 和 Windows 等平台运行。
4. 语音识别及语音活动检测
我们提供的DartAPI, 既支持流式实时语音识别(即边说边识别),也支持非流式语音识别(即说完后再识别)。
4.1 流式实时语音识别
实时语音识别的 Flutter 例子代码链接[11]如下
https://github.com/k2-fsa/sherpa-onnx/tree/master/flutter-examples/streaming_asr我们特意分别在 Android, iOS 和 Windows 三个平台上录制了实时语音识别的视频,向大家展示识别的效果。B站视频地址如下
| Android Flutter实时语音识别 | https://www.bilibili.com/video/BV1Cb421E7NC/ |
| iOS Flutter实时语音识别 | https://www.bilibili.com/video/BV1p4421U7Gj/ |
| Windows Flutter 实时语音识别 | https://www.bilibili.com/video/BV1Nm421G7kN/ |
4.2 非流式语音识别
非流式语音识别的 Dart API 例子代码地址[12]如下
https://github.com/k2-fsa/sherpa-onnx/tree/master/dart-api-examples/non-streaming-asr目前我们的 Dart API 支持基于下述模型的非流式语音识别:
•Zipformer[13]
•Whisper[14]
•SenseVoice[15]
•Paraformer[16]
•TeleSpeech-ASR[17]
下面我们以Whisper为例,介绍如何使用 Dart API 识别一个文件。
gitclonehttps://github.com/k2-fsa/sherpa-onnxcdsherpa-onnx/dart-api-examples/non-streaming-asrdart pub getcurl -SL -O https://github.com/k2-fsa/sherpa-onnx/releases/download/asr-models/sherpa-onnx-whisper-tiny.en.tar.bz2tar xvf sherpa-onnx-whisper-tiny.en.tar.bz2rmsherpa-onnx-whisper-tiny.en.tar.bz2dart run \./bin/whisper.dart \--encoder ./sherpa-onnx-whisper-tiny.en/tiny.en-encoder.int8.onnx \--decoder ./sherpa-onnx-whisper-tiny.en/tiny.en-decoder.int8.onnx \--tokens ./sherpa-onnx-whisper-tiny.en/tiny.en-tokens.txt \--input-wav ./sherpa-onnx-whisper-tiny.en/test_wavs/0.wav上述命令的识别结果为
After early nightfall, the yellow lamps would light up here and there the squalid quarter of the brothels.4.3 语音活动检测
我们支持在Dart里面使用silero-vad[18], 同时支持 silero-vad v4 和最新版 v5.
例子代码地址[19]如下
https://github.com/k2-fsa/sherpa-onnx/tree/master/dart-api-examples/vad下面的命令,我们使用 Dart API, 去除音频中非人声部分, 只保留人声。
gitclonehttps://github.com/k2-fsa/sherpa-onnxcdsherpa-onnx/dart-api-examples/vaddart pub getcurl -SL -O https://github.com/k2-fsa/sherpa-onnx/releases/download/asr-models/silero_vad.onnxcurl -SL -O https://github.com/k2-fsa/sherpa-onnx/releases/download/asr-models/lei-jun-test.wavdart run \./bin/vad.dart \--silero-vad ./silero_vad.onnx \--input-wav ./lei-jun-test.wav \--output-wav ./lei-jun-test-no-silence.wav上述命令把lei-jun-test.wav作为输入,去除非人声部分后,输出文件lei-jun-test-no-silence.wav。
4.4 语音活动检测和非流式语音识别相结合
一般的,非流式语音识别模型对输入的音频长度会有限制。比如,Whisper运行一次,只接收30秒的音频。
对于非常长的音频文件,我们可以用 VAD 根据音频中的停顿,对音频进行切割, 然后对切割后的音频,使用非流式模型进行语音识别。如果我们记住切割后的每一段音频的起止时间,就可以生成字幕。
对此,我们特意提供了一个 VAD + 非流式语音识别的例子,代码链接[20]如下:
https://github.com/k2-fsa/sherpa-onnx/tree/master/dart-api-examples/vad-with-non-streaming-asr我们使用上面的测试音频lei-jun-test.wav和SenseVoice模型进行测试。测试命令如下:
gitclonehttps://github.com/k2-fsa/sherpa-onnxcdsherpa-onnx/dart-api-examples/vad-with-non-streaming-asrdart pub getcurl -SL -O https://github.com/k2-fsa/sherpa-onnx/releases/download/asr-models/sherpa-onnx-sense-voice-zh-en-ja-ko-yue-2024-07-17.tar.bz2tar xvf sherpa-onnx-sense-voice-zh-en-ja-ko-yue-2024-07-17.tar.bz2rmsherpa-onnx-sense-voice-zh-en-ja-ko-yue-2024-07-17.tar.bz2curl -SL -O https://github.com/k2-fsa/sherpa-onnx/releases/download/asr-models/lei-jun-test.wavcurl -SL -O https://github.com/k2-fsa/sherpa-onnx/releases/download/asr-models/silero_vad.onnxdart run \./bin/sense-voice.dart \--silero-vad ./silero_vad.onnx \--model ./sherpa-onnx-sense-voice-zh-en-ja-ko-yue-2024-07-17/model.onnx \--tokens ./sherpa-onnx-sense-voice-zh-en-ja-ko-yue-2024-07-17/tokens.txt \--use-itntrue\--input-wav ./lei-jun-test.wav >./lei-jun-test.txt生成的./lei-jun-test.txt文件如下:
注: 运行时,我们使用了
SenseVoice的use_itn=true。因此识别结果中有标点,也对数字做了inverse text normalzation。
28.940 --36.006:朋友们晚上好,欢迎大家来参加今天晚上的活动,谢谢大家。42.124--46.374:这是我第四次颁年度演讲。46.924--50.118:前三次呢,因为疫情的原因。50.412--55.750:都在小米科技园内举办,现场的人很少。56.140--57.574:这是第四次。58.188--66.854:我们仔细想了想,我们还是想办一个比较大的聚会,然后呢让我们的新朋友老朋友一起聚一聚。67.724--70.886:今天的话呢我们就在北京的。71.660--75.142:国家会议中心呢举办了这么一个活动。75.436--79.526:现场呢来了很多人,大概有3500人。79.948--82.278:还有很多很多的朋友呢。82.700--85.798:通过观看直播的方式来参与。86.348--90.886:再一次呢对大家的参加表示感谢,谢谢大家。98.476--99.910:两个月前。100.36--104.49:我参加了今年武汉大学的毕业典礼。105.93--107.33:今年呢是。107.92--110.69:武汉大学建校130周年。111.76--112.84:作为校友。113.36--114.89:被母校邀请。115.21--117.22:在毕业典礼上致辞。118.06--119.56:这对我来说。119.82--122.60:是至高无上的荣誉。123.66--125.67:站在讲台的那一刻。126.25--128.61:面对全校师生。129.20--131.46:关于武大的所有的记忆。131.69--134.18:一下子涌现在脑海里。134.99--137.67:今天呢我就先和大家聊聊。138.28--139.49:大往事。141.84--143.81:那还是36年前。145.93--147.65:1987年。148.68--151.62:我呢考上了武汉大学的计算机系。152.68--155.17:在武汉大学的图书馆里。155.40--156.71:看了一本书。157.58--158.63:微捕之火。159.34--161.64:建立了我一生的梦想。163.31--164.45:看完书以后。165.29--166.44:热血沸腾。167.60--169.32:激动的睡不着觉。170.41--171.24:我还记得。172.01--172.97:那天晚上。173.32--174.66:星光很亮。175.40--177.67:我就在五大的操场上。178.35--179.78:就是屏幕上这个超场。180.78--182.47:走了一圈又一圈。182.96--185.22:走了整整一个晚上。186.48--187.75:我心里有团火。188.94--190.31:我也想搬一个。190.60--191.81:伟大的公司。193.96--194.82:就是这样。197.61--198.82:梦想之火。199.28--202.50:在我心里彻底点燃了。209.77--210.53:但是。210.76--212.55:一个大一的新生。220.97--222.73:一个大一的新生。223.82--227.05:一个从县城里出来的年轻人。228.14--230.63:什么也不会,什么也没有。231.53--236.33:就想创办一家伟大的公司,这不就是天方夜谭吗?237.58--240.10:这么离谱的一个梦想。240.36--242.28:该如何实现呢?243.85--244.93:那天晚上。245.20--246.92:我想了一整晚上。247.98--248.97:说实话。250.35--253.80:越想越糊涂,完全理不清头绪。254.99--256.10:后来我在想。256.78--258.02:干脆别想了。258.35--259.88:把书练好。260.43--261.38:是正慑。262.16--262.98:所以呢。263.37--265.67:我就下定决心认认真真读书。268.49--271.40: 我怎么能够把书读的不同反响呢?5. 声音事件检测
目前我们支持使用Zipformer和CED[21]进行声音事件检测 (audio tagging)。比如,识别给定音频中是否有婴儿哭声,是否有猫叫声、是否有警报声等等。
例子代码地址[22]为
https://github.com/k2-fsa/sherpa-onnx/tree/master/dart-api-examples/audio-tagging下面我们用Zipformer的 audio tagging 模型,演示如何使用。
gitclonehttps://github.com/k2-fsa/sherpa-onnxcdsherpa-onnx/dart-api-examples/audio-taggingdart pub getcurl -SL -O https://github.com/k2-fsa/sherpa-onnx/releases/download/audio-tagging-models/sherpa-onnx-zipformer-audio-tagging-2024-04-09.tar.bz2tar xvf sherpa-onnx-zipformer-audio-tagging-2024-04-09.tar.bz2rmsherpa-onnx-zipformer-audio-tagging-2024-04-09.tar.bz2dart run \./bin/zipformer.dart \--model ./sherpa-onnx-zipformer-audio-tagging-2024-04-09/model.int8.onnx \--labels ./sherpa-onnx-zipformer-audio-tagging-2024-04-09/class_labels_indices.csv \--wav ./sherpa-onnx-zipformer-audio-tagging-2024-04-09/test_wavs/5.wav输出结果为
[AudioEvent(name:Slap, smack, index:467, prob:0.9186466336250305),AudioEvent(name:Finger snapping, index:62, prob:0.9182724952697754),AudioEvent(name:Whip, index:472, prob:0.18996259570121765),AudioEvent(name:Clapping, index:63, prob:0.11238119006156921),AudioEvent(name:Inside, small room, index:506, prob:0.02442842721939087)]模型输出了概率最高的前5个事件。我们可以看到,判断为打响指的概率为0.91.
我们分别选取 6.wav 和 7.wav 进行测试,输出结果如下
6.wav
[AudioEvent(name:Baby cry, infant cry, index:23, prob:0.8852226734161377),AudioEvent(name:Crying, sobbing, index:22, prob:0.5102355480194092),AudioEvent(name:Whimper, index:24, prob:0.0780656635761261),AudioEvent(name:Inside, small room, index:506, prob:0.02283826470375061),AudioEvent(name:Speech, index:0, prob:0.010384321212768555)]判断有婴儿哭声的概率为0.88
7.wav
[AudioEvent(name:Smoke detector, smoke alarm, index:399, prob:0.3430711627006531),AudioEvent(name:Sine wave, index:501, prob:0.30125075578689575),AudioEvent(name:Beep, bleep, index:481, prob:0.24322959780693054),AudioEvent(name:Buzzer, index:398, prob:0.1124192476272583),AudioEvent(name:Fire alarm, index:400, prob:0.08048766851425171)]判断为烟雾报警的概率为0.34.
6. 总结
本文向大家介绍了如何使用sherpa-onnx的DartAPI进行语音识别、语音合成、语音活动检测和声音事件检测 。所有的计算都在本地进行,不需要访问网络。
值得指出的是,虽然本文使用了Dart作为例子,但是大家可以选用我们支持的其他9种语言中任意一种语言去开发本文提到的各种语音功能。
引用链接
[1]sherpa-onnx:http://github.com/k2-fsa/sherpa-onnx
[2]Dart:https://dart.dev/
[3]地址:https://github.com/k2-fsa/next-gen-kaldi-wechat/blob/master/pdf/sherpa-onnx-dart-functions.pdf
[4]Flutter:https://flutter.dev/
[5]Dart 包:https://pub.dev/packages/sherpa_onnx
[6]VITS:https://arxiv.org/pdf/2106.06103
[7]地址:https://github.com/k2-fsa/sherpa-onnx/releases/tag/tts-models
[8]网址:https://github.com/k2-fsa/sherpa-onnx/tree/master/dart-api-examples/tts
[9]链接:https://github.com/k2-fsa/sherpa-onnx/tree/master/flutter-examples/tts
[10]地址:https://www.bilibili.com/video/BV1fgvyeqEMp/
[11]代码链接:https://github.com/k2-fsa/sherpa-onnx/tree/master/flutter-examples/streaming_asr
[12]地址:https://github.com/k2-fsa/sherpa-onnx/tree/master/dart-api-examples/non-streaming-asr
[13]Zipformer:https://arxiv.org/abs/2310.11230
[14]Whisper:https://github.com/openai/whisper
[15]SenseVoice:https://github.com/FunAudioLLM/SenseVoice
[16]Paraformer:https://github.com/modelscope/FunASR
[17]TeleSpeech-ASR:https://github.com/Tele-AI/TeleSpeech-ASR
[18]silero-vad:https://github.com/snakers4/silero-vad
[19]地址:https://github.com/k2-fsa/sherpa-onnx/tree/master/dart-api-examples/vad
[20]链接:https://github.com/k2-fsa/sherpa-onnx/tree/master/dart-api-examples/vad-with-non-streaming-asr
[21]CED:https://github.com/RicherMans/CED
[22]地址:https://github.com/k2-fsa/sherpa-onnx/tree/master/dart-api-examples/audio-tagging
