
 语音小管家
本文介绍新一代 Kaldi 团队基于 Flow Matching 架构的 ZipVoice 零样本单说话人语音合成模型[1]。ZipVoice 解决了现有零样本语音合成模型的参数量大、合成速度慢的痛点,在轻量化建模和推理加速上取得了重要突破,可能是行业内首个可以在 CPU 上实时运行的零样本语音合成模型。
项目的训练推理代码已全部开源:https://github.com/k2-fsa/ZipVoice
该工作已被 ASRU 2025 接收 :https://arxiv.org/pdf/2506.13053
ZipVoice:高效零样本语音合成技术
零样本语音合成模型支持音色克隆,且可在大规模数据上进行训练,由于其应用灵活性高、语音自然度好,得到了业界的广泛关注。但现有的零样本语音合成模型由于参数量大、推理速度慢,对于低计算资源设备的部署很不友好,为了解决这一问题,ZipVoice 通过多个技术创新实现了“小而强”的零样本语音合成模型。
1. 方法介绍
1.1 基于 Zipformer 的高效建模
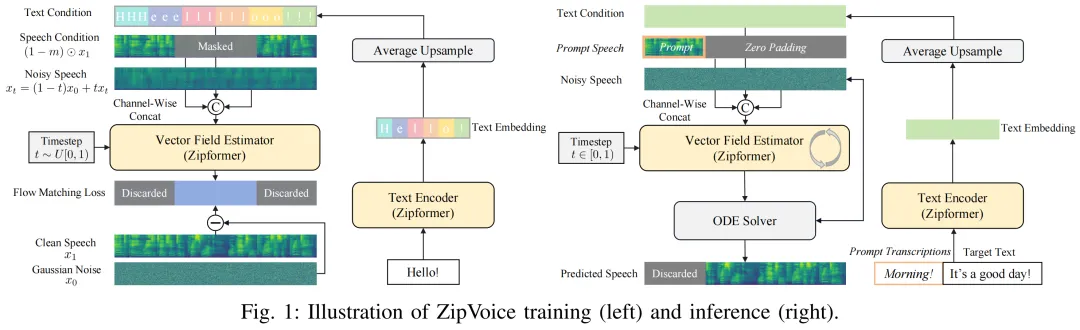
ZipVoice 首次将原本为自动语音识别(ASR)设计的 Zipformer 架构 [2] 引入TTS 任务作为模型的骨干网络,Zipformer 中的三大设计:基于 U-Net 的多尺度高效率结构、卷积与注意力机制的协同处理、以及注意力权重的多次复用都高度适配语音合成任务,从而实现了语音合成模型的高效建模。得益于这一设计,相比基于 DiT 的语音合成模型 [3],在性能相似的情况下,ZipVoice 的参数量减少了约63%。
1.2 平均上采样:简洁且稳定的语音-文本对齐策略
传统非自回归 TTS 模型需显式预测每一文本 token(音素、字符等)的时长,最近的非自回归 TTS 模型通过将文本 token 添加 padding 后直接输入语音预测模型的方式,实现了对时长预测的隐式建模和端到端优化 [4]。但这一方式容易导致对齐混乱与收敛缓慢的问题。为解决这一问题,ZipVoice 提出平均上采样策略,假设每个文本 token 具有相同的时长,对文本 token 进行平均上采样后送入语音预测模型。这种简化的时长假设为模型提供了稳定的初始对齐线索,显著提升了对齐稳定性和收敛速度,有效提升了语音可懂度。
1.3 Flow Distillation:通过减少推理步数实现加速
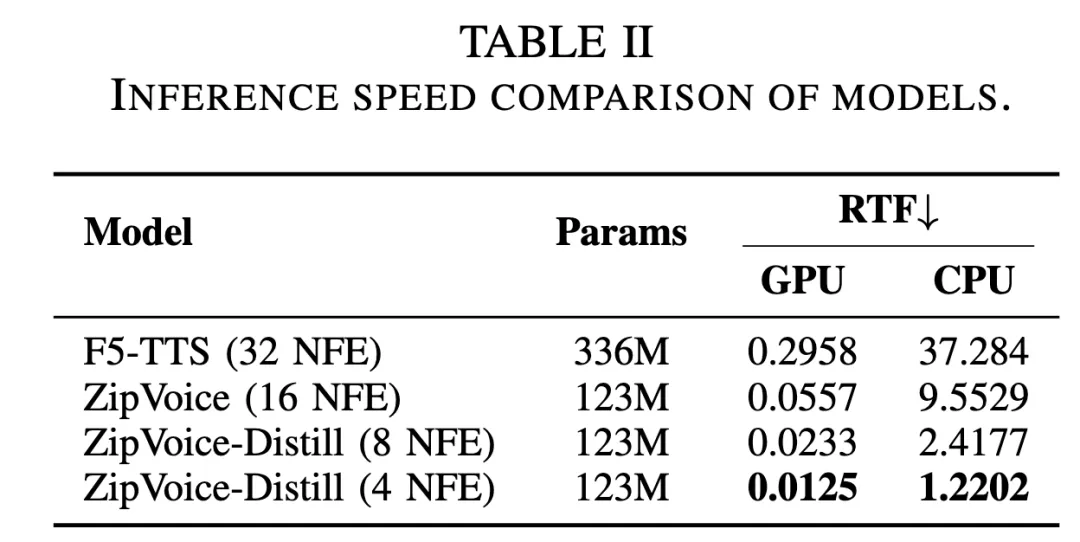
Flow Matching 模型通常需要较多采样步数才能保证语音质量,且其常用的Classifier-free guidance (CFG) [5] 策略会使推理开销增加近一倍。ZipVoice中采用了 Flow Distillation 方法解决这些问题:利用预训练 ZipVoice 模型结合 CFG 技术,通过两步 ODE 求解得到教师预测,学生模型则通过无 CFG 的一步推理逼近教师预测,减少了推理步数要求的同时避免了 CFG 带来的额外推理开销。此外,引入 EMA(指数滑动平均)模型作为第二阶段教师模型,在蒸馏中动态提升教师模型性能。最终,蒸馏后的模型 ZipVoice-Distill 仅通过4步推理即可得到高质量语音,在 CPU 单线程使用 PyTorch 代码推理时即可达到接近实时的速度(RTF≈1)。
2. 实验结果
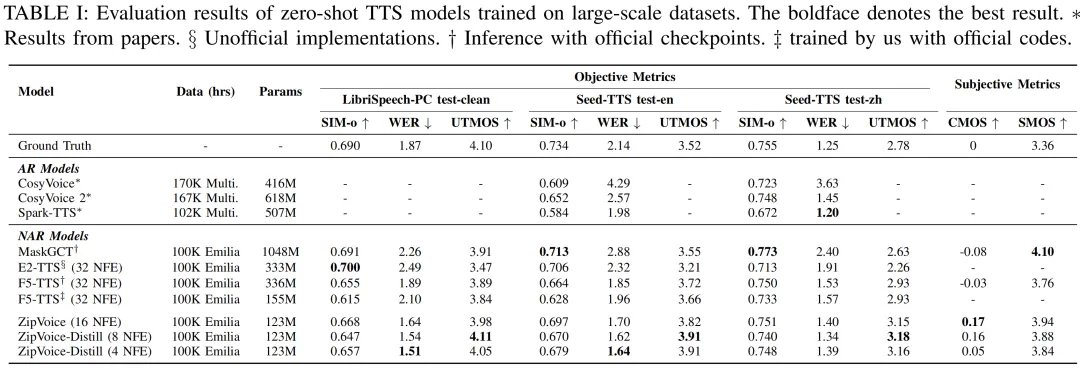
我们在零样本语音合成模型评测常用的 LibriSpeech-PC test-clean、Seed-TTS test-en 和 test-zh 测试集上与现有的多个 SOTA(state-of-the-art)模型进行了对比,实验结果表明,ZipVoice 和 ZipVoice-Distill 在具备更小参数量和更快推理速度的同时,在三个客观指标,即说话人相似度(SIM-o)、词错误率(WER)和 UTMOS,以及两个主观指标(CMOS、SMOS)上都极具竞争力,达到了零样本语音合成模型的 SOTA 性能水平,同时显著减少了模型参数量,加快了推理速度。
展望
综上所述,ZipVoice 零样本语音合成模型具备了低参数量、高推理速度、高语音质量三大优点,为轻量化、高速度要求的语音交互应用场景提供了新的解决方案。未来团队将持续对 ZipVoice 系列模型进行优化,致力于让每一个人都能享受到低成本高质量的语音合成技术。
参考文献
[1] H. Zhu, W. Kang, Z. Yao, L. Guo, F. Kuang, Z. Li, W. Zhuang, L. Lin, and D. Povey, "ZipVoice: Fast and High-Quality Zero-Shot Text-to-Speech with Flow Matching," to appear in 2025 IEEE Automatic Speech Recognition and Understanding Workshop (ASRU).
[2] Z. Yao, L. Guo, X. Yang, W. Kang, F. Kuang, Y. Yang, Z. Jin, L. Lin, and D. Povey, “Zipformer: A faster and better encoder for automatic speech recognition,” in The Twelfth International Conference on Learning Representations, 2024
[3] Y. Chen, Z. Niu, Z. Ma, K. Deng, C. Wang, J. Zhao, K. Yu, and X. Chen, “F5-TTS: A Fairytaler that Fakes Fluent and Faithful Speech with Flow Matching,” arXiv preprint arXiv:2410.06885, 2025
[4] S. E. Eskimez, X. Wang, M. Thakker, C. Li, C.-H. Tsai, Z. Xiao, H. Yang, Z. Zhu, M. Tang, X. Tan, et al., “E2 tts: Embarrassingly easy fully non-autoregressive zero-shot tts,” arXiv preprint arXiv:2406.18009, 2024.
[5]J. Ho and T. Salimans, “Classifier-Free Diffusion Guidance,” in NeurIPS 2021 Workshop on Deep Generative Models and Downstream Applications, 2021,
