
 语音小管家
今天带给大家的是数据收集后的标注。回到语音领域,为了落地语音的应用场景来分类标注的内容。通常是对语音内容转文字、音段和韵律标注。
数据收集来自不同方法,内容也呈现出多样化。标注随着语音数据本身的环境会有着不同的标注要求。例如:客服类的语音数据,有着特殊的环境性质。这样的数据标注会更侧重A&B两端的客户端。客户端的语音内容、情绪、发音等都需要标注。通常我们所用的语音数据均为相对安静场景下的语音,针对内容做一个人工转写和校对的工作。这个过程是一个基本的、简单的标注流程。
针对语音领域的研究,比如:语义分析、语音合成、语音评测、语音教育等都要采用专项标注方法。因为要涉及到领域的专业知识,音素和音段切分标注、对话标注、韵律标注、噪音标注、词性(POS)标注、重音边界标注、语言学现象标注等。这个标注过程是一个复杂的过程,针对标注的精确度也会更严格。
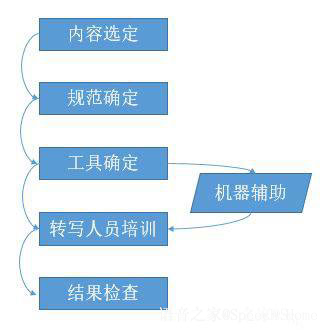
语音的标注从工程上来看,基本上如下图从数据的选定该如何去标注到确定规范、制定工具、是否需要机器辅助、人工参与并做培训、结果的检查这个流程来实施的。
目前在语音领域市场上的产品大多都是落地在家居和车载场景上,然而两大场景的数据又是怎么制作和标注后应用到实际系统上的呢?下一篇我们拿案例来分析,敬请期待。
