
 语音小管家
这篇文章主要来写下kaldi中数据处理的一些内容。如果我们拿到一个新的数据库,我们根据数据准备阶段准备数据,然后咱们开始训练模型。但基础数据往往是单一的,我们怎么才能让数据变多呢。首先这里引用来自阿里巴巴的薛少飞之前的一个ppt:
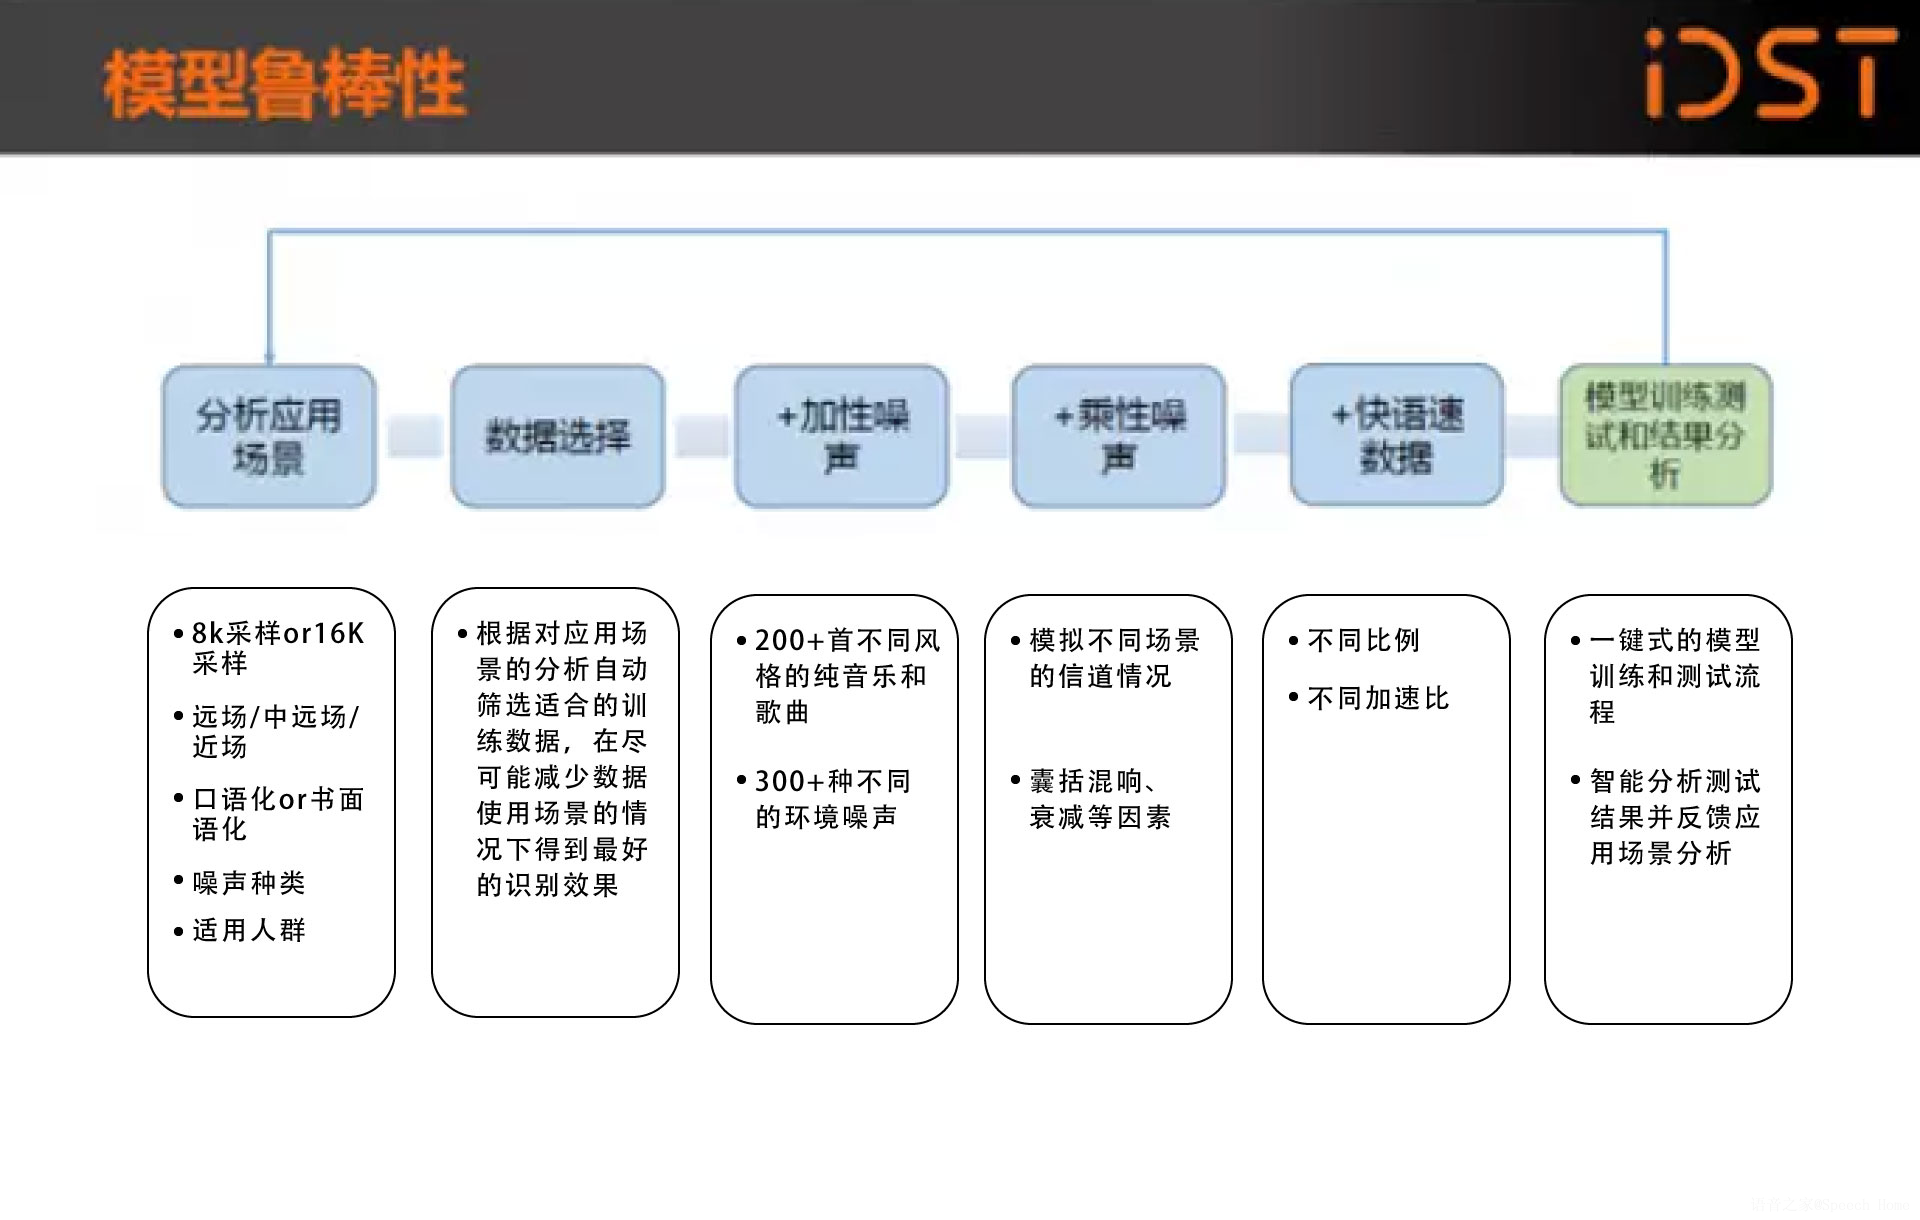
目前在基础数据上增加数据的方法无外乎上述ppt提到的四种方法,分别为:加性噪声,乘性噪声,加音量,变语速等。这四种方法kaldi里都有对应的脚本干这些事情。
加性噪声跟乘性噪声:
加冲击响应或者加性噪声的脚本位于https://github.com/kaldi-asr/kaldi/blob/master/egs/aspire/s5/local/multi_condition/reverberate_data_dir.sh。主要使用的函数对应是wav-reverberate。如果大家做远场的话可以学习下这个脚本,kaldi里有一堆开源的冲击响应函数集合,在https://github.com/kaldi-asr/kaldi/blob/master/egs/aspire/s5/local/multi_condition/prepare_impulses_noises.sh这个脚本里罗列了目前开源的8个组织的冲击响应函数,当然也有一些噪声,目前噪声库有NOISE-92等。
变音量跟变语速:
音量脚本:https://github.com/kaldi-asr/kaldi/blob/master/egs/wsj/s5/utils/data/perturb_data_dir_volume.sh
语速脚本:https://github.com/kaldi-asr/kaldi/blob/master/egs/wsj/s5/utils/data/perturb_data_dir_speed_3way.sh
kaldi的变音量跟变语速都是借助sox这个工具来实现的,具体的命令大家可以参考脚本,音量的变化范围从1.0/8到2;语速的变化范围就0.9,1,1.1。
povey这边分别对上述有论文支撑:
"A study on data augmentation of reverberant speech for robust speech recognition", Tom Ko, Vijayaditya Peddinti, Daniel Povey, Michael L. Seltzer and Sanjeev Khudanpur, ICASSP 2017
"Audio Augmentation for Speech Recognition", Tom Ko, Vijayaditya Peddinti, Daniel Povey and Sanjeev Khudanpur, Interspeech 2015
如果大家把基础数据模型训练出来后,可以尝试使用以上提到的方法来增加数据的多样性,试一试,也许识别率就提高上去了。数据就跟原子弹的燃料一样,匹配数据越多效果会越好!
