
 语音小管家
垃圾,词典里给出的解释是:“废弃无用或肮脏破烂之物”。其实在语音交互这个领域也是有很多“垃圾”需要过滤或者回收再利用,今天就让我们看看语音交互的垃圾分类图签。
本底噪音是指测试设备本身不希望有的声信号(或者说是声源停止发声时周围环境的噪声)。而背景噪音是指在发生、检查、测量、记录系统中与有用信号无关的一切干扰(一般指电声系统中除有用信号以外的总噪声)。
其实在听力学中本底噪音和背景噪音一般难以区分。现在随着DNN等技术的应用,对噪音的鲁棒性有一定的提高,但是当信噪比降低(如零以下)的时候性能还是会下降的很厉害。特别是当背景噪声是人声的时候。当前一些主流的云端引擎,信噪比降低的时候识别会大量地丢字,可能把语音也判断成噪音弄丢了,也可能是识别出的字置信度太低被丢弃了。
那么如何降噪?
首先多通道同步采集硬件是研究前端降噪算法的前提,只有先拿到一些麦克风阵列的数据,才能根据实际采集的数据进行算法的研发和调优。目前市面上主流的codec芯片最多支持4通道同步采集,这对于麦克风阵列来说是不够的,比如echo音响,采用了7个麦克风,再加上一个喇叭的参考信号,所以它至少需要8通道同步采集,即2个4通道的codec芯片。为了使两个codec芯片同步,需要一颗FPGA芯片来协助完成,同时麦克风还需要一些配套的模拟滤波放大电路,中间有很多都是经验性的东西,并且在echo以前,消费电子上很少有集成4个麦克风的情况,所以研究的人很少,这也增加了该硬件的研发难度。
其次是麦克风阵列降噪算法的研发。房间混响会造成麦克风接收到的信号有很长的拖尾,让人听起来感觉发闷,在实际中人耳具有自动解混响的能力,所以人在实际房间中相互交流并没有影响反而觉得声音饱满,但是这个对于语音识别来说是致命的,这大概是因为房间的冲击响应太长,一般有400ms-1000ms,而语音识别一帧的长度只有50ms,即使DNN有记忆能力,但也有限,所以在混响中语音识别率下降。远场语音识别以前由于需求不大,对于去混响研究的不多,一般以倒谱平均、谱减法为主,但这类方法对远场语音识别率提升不大,目前比较好的去混响算法是日本NTT部门研究的多步线性预测方法,有兴趣的可以尝试一下。
最后就是语音识别引擎要和前端降噪算法进行匹配。目前的识别算法还是训练数据和测试数据越匹配效果越好。目前各家的语音识别引擎主要是利用手机上收集的语音进行训练的,因此只适用于近讲情况。同样道理,为了提升远场语音识别,就需要用远场的语音数据训练声学模型,而远场语音数据又太复杂(混响、噪声),这就需要信号处理的手段让数据尽量变的单一一些,最佳的方法就是利用麦克风阵列采集的信号经过前端降噪算法后的数据去训练语音识别引擎,效果应该会有大幅提升。
此外,目前远场语音识别也分为两派,一派认为利用深度学习的办法也可以实现去混响降噪声的目的,另外一派是用麦克风阵列信号处理的方法去除混响和噪声,从目前的产品上看麦克风阵列信号处理的方式在实际中用的更多一些,echo用了7个麦克风,叮咚用了8个麦克风,googlehome也用了两个麦克风。
把口音比作垃圾其实有些不恰当,但口音这个问题一直是语音技术发展的一大难题也是不争的事实。在漫长的人类发展史中,从最初的肢体传递简单的信息,发展到可以用口发声、用耳朵接收声音去传递复杂的信息和自我意识,这中间经历了一个漫长、复杂的衍化过程。直接导致了一个结果——语言种类过于庞杂。比如,在对越自卫反击战时,中国部队选择了一部分温州兵做通讯员,逼迫敌方放弃偷听电台,只因为温州方言复杂且难以破解。
人与人之间的交流和沟通尚且存在障碍,人跟“一个没有感情的听话机器”交流更成为问题。这就是人机交互的第二大问题,如何让机器听懂你。虽然当前的系统都会内置兼容常见方言的多发音字典,训练数据也会包含有口音的数据。但因为语言多种多样,有声调、长短音、韵律、语序,性别年龄上也有所差异,所以目前语音识别对于使用人群较少的语言还处于比较初级的阶段。
而解决这些还是需要采集尽量多的差异化的语音数据。也可以看看小语之前分享过的语音包:
这是和朗读相对应的。这在转写和速录一类的任务中较为突出。因为用户的意识不是在跟机器交流,而是在跟人交流,所以不会去刻意控制语速或者吐字,语音中有大量的连音、吞音、发音变形,还有“嗯,啊,呃”的口语停顿。当前也有针对这一类的研究,但总体性能还不理想。
最近,国内各大厂商百度、讯飞等都公布了自己ASR的识别率超过了97%,对外宣称已经达到了普通人的识别水平,在这里识别率通常指的是“WER(词错误率,WordError Rate)”
WER:为了使识别出来的词序列和标准的词序列之间保持一致,需要进行替换、删除或者插入某些词,这些插入、替换或删除的词的总个数,除以标准的词序列中词的总个数的百分比,即为WER。为了使识别出来的词序列和标准的词序列之间保持一致,需要进行替换,删除,或者插入某些词,WER计算方式如下:
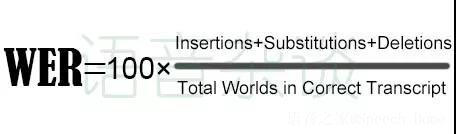
需要注意的是,因为有插入词,所以WER有可能大于100%
这里小语送上一个WER不同算法、不同语料的汇总,包括LibriSpeech语料库,WSJ,Rich Transcriptions,Hub5'00Evaluation (Switchboard / CallHome),Fisher(RT03S FSH)等。
原地址:
https://github.com/gopala-kr/a-week-in-wild-ai/tree/40d15ef1d7874f2752d6dd0674a4c5fd3d62e222/03-speech-processing#language-modelling
这个是难度最大的一种。人其实在这方面也有困难。例如偏远地区的人就听不懂普通话。在日常交流中不识字的老人会看不懂新闻联播。在听跨领域论文时觉得自己特别没有文化。甚至文言文虽然跟普通话都是中文,但是在现在听来也是晦涩难懂。而要求计算机去读懂来自各个领域的各种诡谲的词汇、语意无疑更加难。对于这部分问题,还要有赖于模型论语意表示了。
模型论语义表示的典型框架是把自然语言映射成逻辑表达式(logicform)。比如对于问题“中国面积最大的省份是哪个?”,将其表示成逻辑表达式就是”argmax(λx,province(x)∧loc(x,中国),λx.Area(x))”,进一步拿这个逻辑表达式去知识库中查询,就得到了答案。在计算方法上,典型的就是构建一个semantic parser。
模型论语义表示是对世界知识的完整表示,比前两种方法表达的语义更加完整,但是缺点是semantic parser的构建比较困难,这大大限制了该方法的应用。并且,我们要搭建一个庞大的知识库。知识库的核心节点是各种词,而这些词条散布在互联网上的各个地方。比如,“总参”除了表示总参谋部外,还是南京一家很火的火锅店;“中华冷面”除了是一种面条,还是一首歌名;“王菲的红豆”是指王菲唱的红豆这首歌,但如果说“韩红的红豆”就不对了,因为韩红没有唱过红豆这首歌。要想把这些知识都理解对,就需要一个庞大的知识库,这个知识库中的实体词数以千万计,怎么挖掘,怎么清洗噪音,都是很大的挑战。
一个新理念的推行,注定是一段漫长的路。从细微处做起,似星星之火,定可燎原。垃圾分类如是,AI发展亦如是。
参考链接:
https://www.zhihu.com/question/53318777/answer/135845776
https://blog.csdn.net/nl997566011/article/details/70138893
https://blog.csdn.net/yang_daxia/article/details/84646616
https://zhuanlan.zhihu.com/p/51008521
