
 语音小管家
近日,出门问问联合西北工业大学音频语音与语言处理研究组推出面向产品和工业界的端到端语音识别开源工具WeNet,WeNet致力于消除从端到端模型研究到产品落地中的鸿沟,探索更适合工业级产品的端到端解决方案。
WeNet:https://arxiv.org/pdf/2102.01547.pdf
U2:https://arxiv.org/pdf/2012.05481.pdf
WeNet如何解决这些问题?
为了解决流式问题、统一模型问题和产品落地问题,WeNet选择了如下解决方案,提供了一套简单、高效、易于产品化的解决方案:
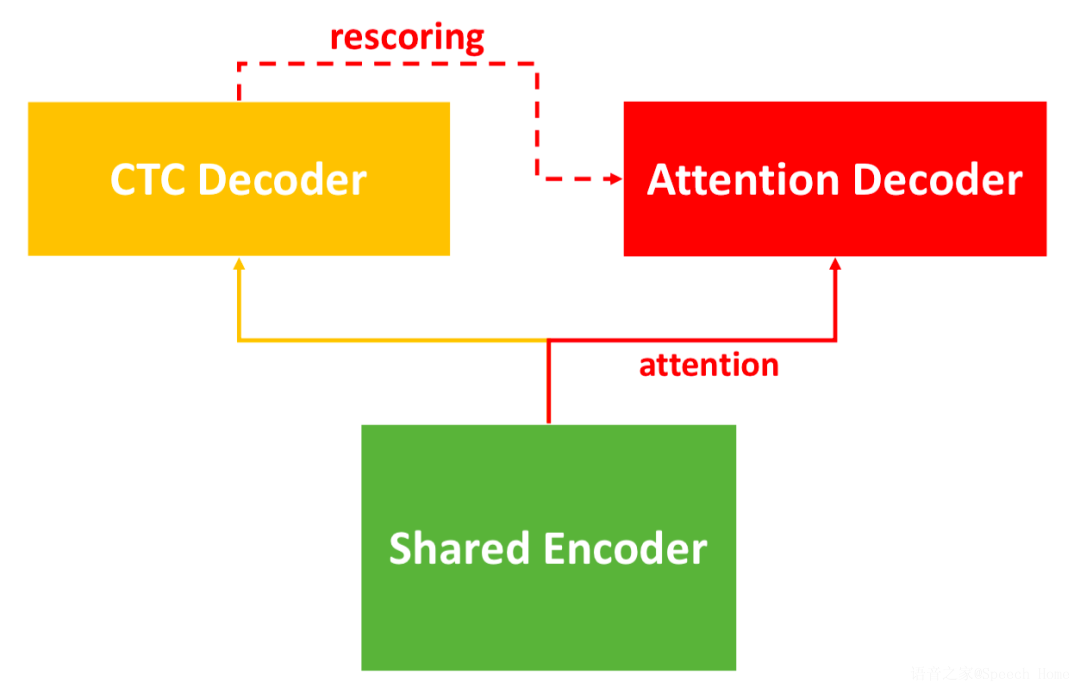
模型架构选择
WeNet中采用的U2模型,如下图所示,该模型使用Joint CTC/AED的结构,训练时使用CTC和Attention Loss联合优化,并且通过dynamic chunk的训练技巧,使Shared Encoder能够处理任意大小的chunk(即任意长度的语音片段)。在识别的时候,先使用CTC Decoder产生得分最高的多个候选结果,再使用Attention Decoder对候选结果进行重打分(Rescoring),并选择重打分后得分最高的结果作为最终识别结果。识别时,当设定chunk为无限大的时候,模型需要拿到完整的一句话才能开始做解码,该模型适用于非流式场景,可以充分利用上下文信息获得最佳识别效果;当设定chunk为有限大小(如每0.5秒语音作为1个chunk)时,Shared Encoder可以进行增量式的前向运算,同时CTC Decoder的结果作为中间结果展示,此时模型可以适用于流时场景,而在流失识别结束时,可利用低延时的重打分算法修复结果,进一步提高最终的识别率。可以看到,依靠该结构,我们同时解决了流式问题和统一模型的问题。
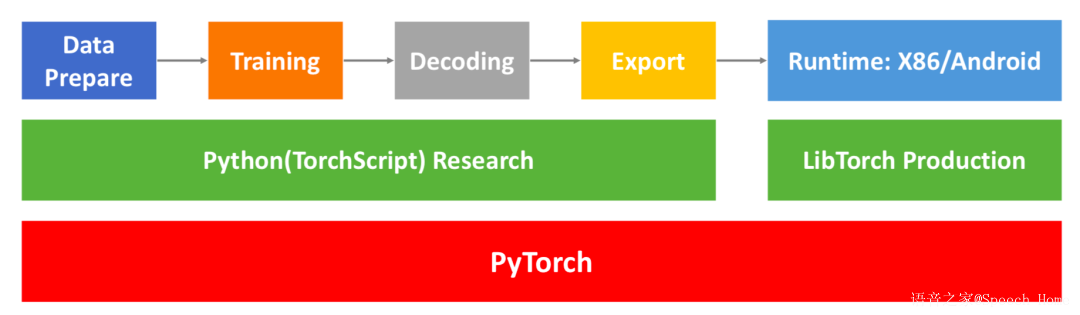
系统设计
为解决落地问题,同时兼顾简单、高效、易于产品化等的准则,WeNet做了如下图的三层系统设计。
Data Prepare:
数据准备部分,WeNet仅需要准备kaldi风格的wav列表文件和标注文件。 Training: WeNet支持on-the-fly特征提取、CTC/AED联合训练和分布式训练。
Decoding:
支持python环境的模型性能评估,方便在正式部署前的模型调试工作。
Export:
研发模型直接导出为产品模型,同时支持导出float模型和量化int8模型。
Runtime:
WeNet中基于LibTorch提供了云端X86和嵌入式端Android的落地方案,并提供相关工具做准确率、实时率RTF(real time factor), 延时(latency)等产品级别指标的基准测试。
嵌入式端Android流式语音识别
WeNet中开发了嵌入式端Android平台的离线流式端到端语音识别,该示例中使用aishell训练的U2 transformer模型,并对模型进行8bit的量化。查看详情参考,可点击此处蓝色字体。
云端X86流式语音识别
为模拟云端流式语音识别,WeNet中开发了基于WebSocket的流式方案,其中包含Server和Client两个部分,如视频演示了一次实时语音请求的过程,左侧为Server界面,右侧为Client界面。查看详情参考,可点击此处蓝色字体。
