
 THUHCSI人机语音交互实验室
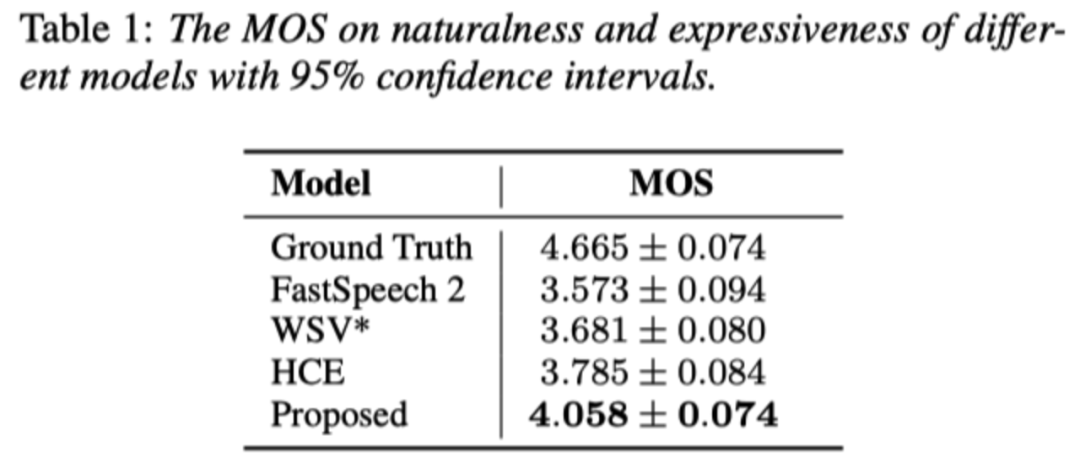
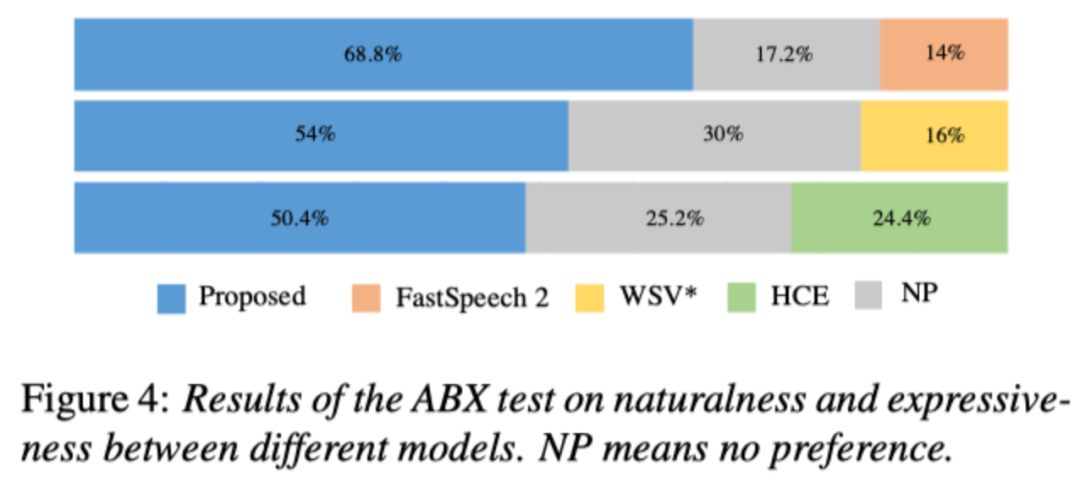
本文由清华大学与虎牙信息科技有限公司、元象唯思控股(深圳)有限公司和香港中文大学合作。 人类语音的风格表达是多尺度的,不仅包括全局尺度的情感表达,还包括局部尺度的韵律表达。 而现有关于表现力语音合成的工作只考虑了单一尺度的说话风格。 针对该问题,本文提出一种基于不同层级上下文语义信息来建模段落级别、句子级别和字级别等不同尺度说话风格的方法,以进一步提升合成语音的表现力。 在中文有声小说数据集上,与只考虑单一尺度说话风格的基线模型相比,本文所提方法的用户偏好率最多可提升38%、主观意见得分最多可提升0.377。
扫码阅读论文
https://arxiv.org/abs/2204.02743
合成样例试听
https://thuhcsi.github.io/interspeech2022-msc-tts/
随着深度学习的发展,基于神经网络的语音合成模型已经可以合成具有中性说话风格的高质量语音。 然而,合成语音的表现力和真人录音相比仍然有明显差距。 这阻碍了语音合成技术在许多领域的应用,如有声读物、播客和语音助手。
02 贡献
本文提出了一种多尺度说话风格建模方法,其核心是基于不同层级上下文语义信息来建模段落级别、句子级别和字级别等不同尺度的说话风格,以进一步提升合成语音的表现力。 该方法在FastSpeech 2的基础上增加了一个多尺度风格提取器和一个多尺度风格预测器。 多尺度风格提取器被用于从全局、句子和每个字对应的语音片段中提取三个不同层级的说话风格表征。 在提取器的基础上,多尺度风格预测器从上下文中提取不同层级的语义信息,然后以残差连接的方式依次预测这各个层级的说话风格表征。 特别地,为了减少不同层级说话风格表征之间的冗余,本文提出用语音表征的残差来表示不同层级的风格变化。 实验表明,本文提出的方法可以显著提升合成语音的自然度和表现力。
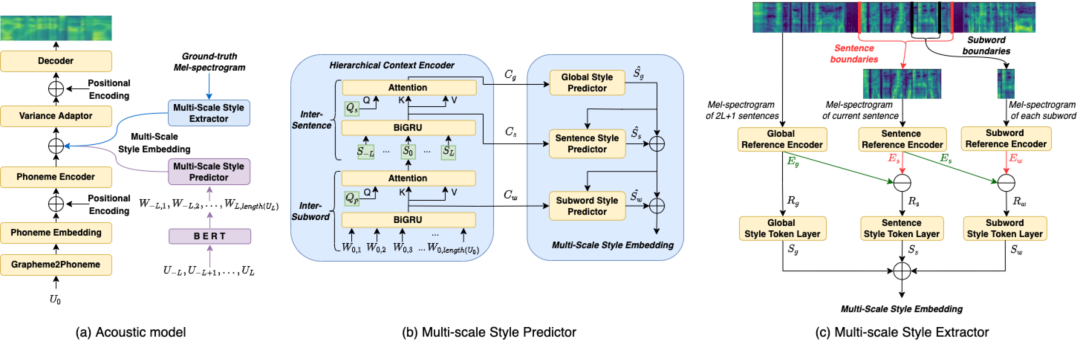
本文提出的模型结构如上图所示,它主要包括: (1)多尺度风格提取器(Multi-scale Style Extractor); (2)多尺度风格预测器(Multi-scale Style Predictor); (3)基于FastSpeech 2的声学模型。 提取器将用于提取三个不同层级的说话风格表征,而预测器用于从上下文中预测这些风格表征。 声学模型在提取器或者预测器的帮助下合成当前句子的语音。
多尺度风格提取器
多尺度风格预测器
04 实验验证
实验数据
基线模型
FastSpeech 2:开源实现的FastSpeech 2模型。
WSV*:词级风格变(Word-level Style Variatios)模型。 为了进行公平的对比,我们用FastSpeech 2代替原始版本的Tacotron 2作为声学模型。 此外,还通过一个额外的双向GRU来考虑上下文信息。
HCE:层级上下文编码器(Hierarchical Context Encoder)模型,它从上下文中预测句子级别的说话风格。
对比实验
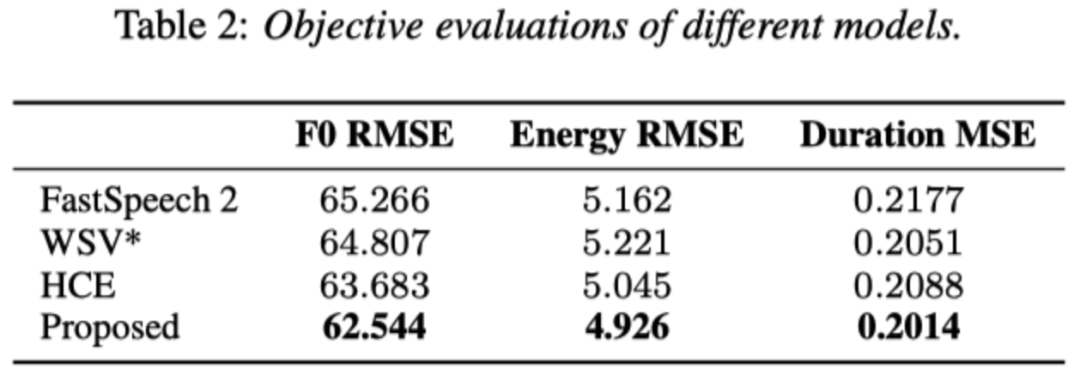
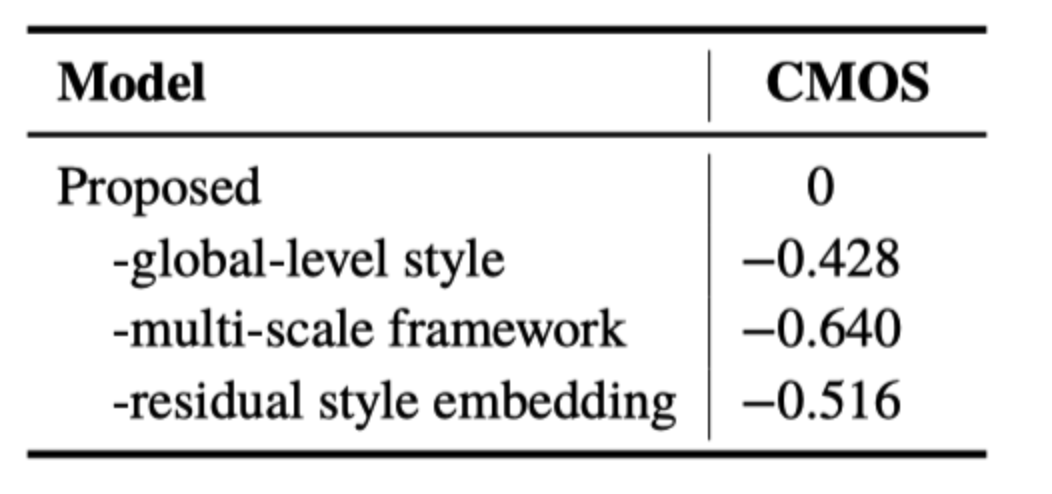
消融实验
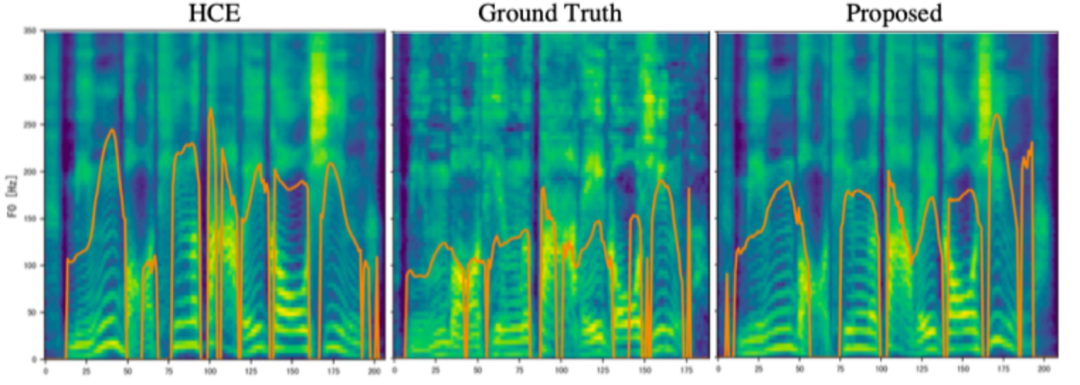
样例分析
样例分析的结果表明,在多尺度说话风格的帮助下,我们的模型成功地学习了人类说话的风格变化,使合成语音拥有更接近于真实语音的韵律变化。
本文提出了一种多尺度说话风格的建模方法,从不同层级上下文语义信息中建模段落级别、句子级别和字级别等不同尺度说话风格,以提高语音合成的表现力。 此外,我们提出了一种基于残差表示的多尺度说话风格提取方法,有效降低了不同尺度风格表征之间的冗余信息。 实验结果表明,本文提出的方法通过从上下文中更准确的预测全局尺度和局部尺度的说话风格,显著提升了合成语音的表现力,使得合成语音拥有更接近于真实语音的韵律变化
