StyleDub: 基于双向注意力机制的跨语言多尺度语音风格迁移联合学习
本文由清华大学与字节跳动合作,研究了自动配音(Automatic dubbing)场景下不同语言之间的语音风格迁移方法。在现有的跨语言自动配音方法中,一般只能实现词级别上的时长迁移,无法实现充分、完整的多尺度语音风格迁移,从而导致合成的配音语音与源语言语音的语音风格有较大偏差,缺乏表现力。本文则基于两种语言之间语音风格迁移规律的双向性,创新性地提出了一种基于双向注意力机制(Bidirectional attention mechanism)的双向跨语言多尺度语音风格迁移联合学习框架 StyleDub,可以从句级别和词级别两个尺度,将源语言配音中的多尺度语音风格自动迁移至目标语言的整句及对应词语上,提升了合成的跨语言配音语音的表现力。本文从游戏配音中收集了一份约 5 小时的中英双语平行配音语料,并通过主观和客观实验验证了所提方法的有效性。扫码阅读论文:https://ieeexplore.ieee.org/abstract/document/10314740
预印版:https://arxiv.org/abs/2305.05203
合成样例试听及开源代码获取:https://github.com/thuhcsi/StyleDub
随着深度学习与语音合成技术的发展,基于神经网络的语音合成系统相比于传统的语音合成算法使用简单,合成的语音也具有更好音质和更高的自然度,进而促进了一系列语音合成相关的下游任务的发展,而自动配音便是其中一个极富有潜力的研究方向。
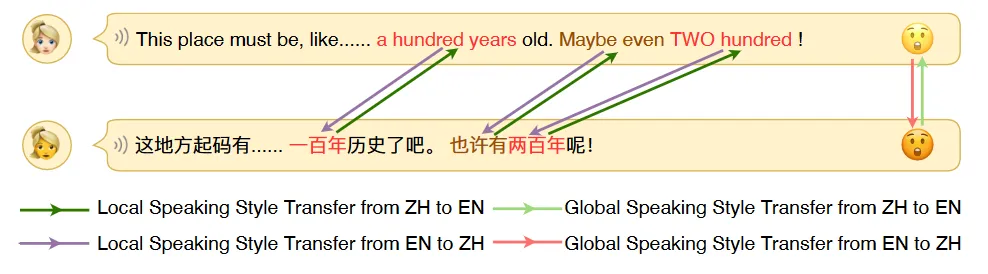
自动配音是指将电影和游戏中的旁白和对话转换为其他语言,可广泛应用于电影和游戏的本土化过程中,以简化繁琐的人工配音过程。如图所示,在电影或游戏制作中,配音演员会使用各种不同的语音风格来展现不同角色的个性、情感和意图。同样地,在句级别配音演员会使用不同的句级别语音风格来表达一句话整体的情感和意图,而在词级别则会使用不同的词级别语音风格来控制每个词的语气和语调,以突出每个话语中的细节。自动配音则除了要将翻译过的文本合成成语音之外,还要进一步考虑到源语言语音中的多尺度语音风格,并在合成过程中将其迁移到目标语言的语音上,以实现自然、本土化的自动配音。
在现有的自动配音系统中,一般通过注意力机制或隐式马尔可夫模型实现两种语言中韵律短语之间的对应,之后根据韵律短语之间的对齐关系,调整目标语言中每个韵律短语的时长或语速,以使得目标语言中的韵律短语的时长与源语言中的匹配。
然而,现有的自动配音系统通常只适用于一些非常简单配音场景,并且无法完整地实现多尺度的语音风格迁移。在现有的自动配音系统中,通常要求配音语言中的韵律短语数量与源语言中的韵律短语数量一致。对于韵律短语数量经常不同的复杂配音场景,这些方法可能无法使用。此外,这些方法只能根据源语言中位置与目标语言中的韵律短语位置相同的韵律短语来调整目标韵律短语的时长,完全忽略了它们的语义信息。对于一些原始语言和配音语言的韵律短语排序差异显著的情况,比如中文和英文之间的语音风格迁移,则合成的语音中可能会产生不恰当的语速。
此外,现有方法中也很少考虑句级别语音风格迁移。对于一些意译而非直译的情况,很有可能翻译的文本与源语言的文本有着完全不同的韵律结构,甚至找不到与源语言文本相同含义的词。在这种情况下,句级别语音风格则是自动配音过程中唯一可以依赖的语音风格,故句级别语音风格迁移对于自动配音也同样重要。而在词级别语音风格迁移上,现有的方法也只能实现时长迁移,无法迁移语音风格中的其他方面。现有的自动配音系统这种在语音风格迁移能力上的不足则会导致合成的语音缺乏情感和意图,严重降低了合成的配音语音的表现力。
为了解决这些问题,改善自动配音中的说话风格转移,本文提出了一种基于双向注意力机制的双向跨语言多尺度语音风格迁移联合学习框架 StyleDub。其中“联合”一词有两重含义,第一重是指该框架实现了句级别和词级别语音风格迁移的联合学习,第二重则是指该框架实现了两种语言之间的两个配音方向上的语音风格迁移的联合学习。相对于现有的只能进行时长迁移的自动配音系统,本文所提的跨语言多尺度语音风格方法通过这种双重联合学习的方式,实现了更加完备的多尺度语音风格迁移,可将源语言中的语音风格,恰当、准确地迁移至目标语言,大幅改善了自动配音系统中合成语音的表现力。
4- 数据观测
本文从游戏《无主之地 3》(Borderlands 3)中收集了一份约 5 小时的中英双语平行语料,并从该语料中首先随机选取了 25 组平行语音用于数据观测。25 位观测者反馈,在中英两种语言的配音中,分别有 78.1% 和 76.1% 的语音有着特殊的、不同于陈述句的句级别语音风格,并且其中 96.8% 的平行语音有着相似的句级别语音风格。在词级别上,在中英两种语言的配音中分别有 83.7% 和 83.1% 的语音中存在一些词有着特殊的、不同于陈述句的词级别语音风格,并且其中分别有 87.1% 和 86.7% 的词,它们的语音风格可以对应到另一种语言上,即在另一种语言的语音中含义相似的词也有着与之相似的词级别语音风格。以上观测结果说明了多尺度语音风格迁移对于自动配音任务的必要性,并揭示了两种语言之间的语音风格迁移规律的双向性。
5- 研究方案
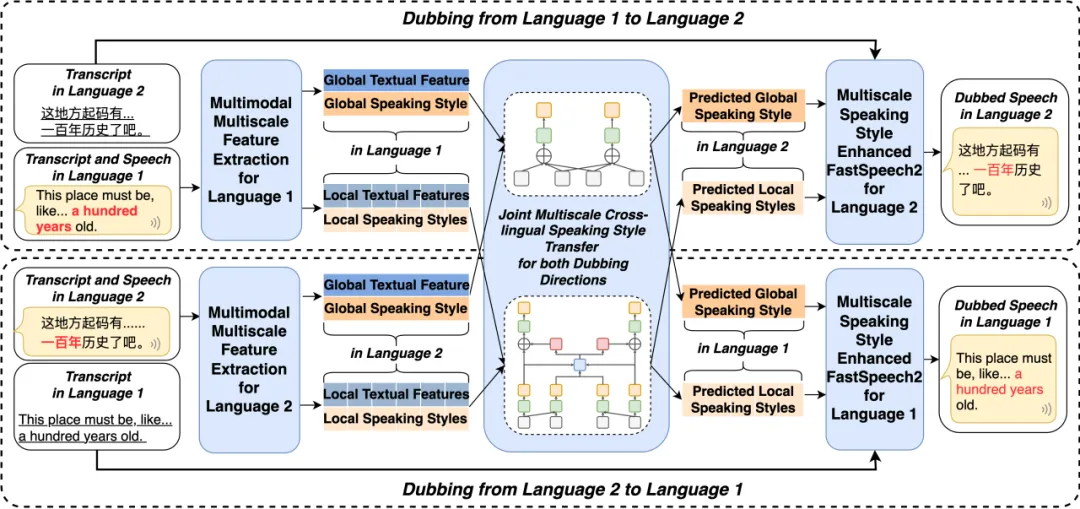
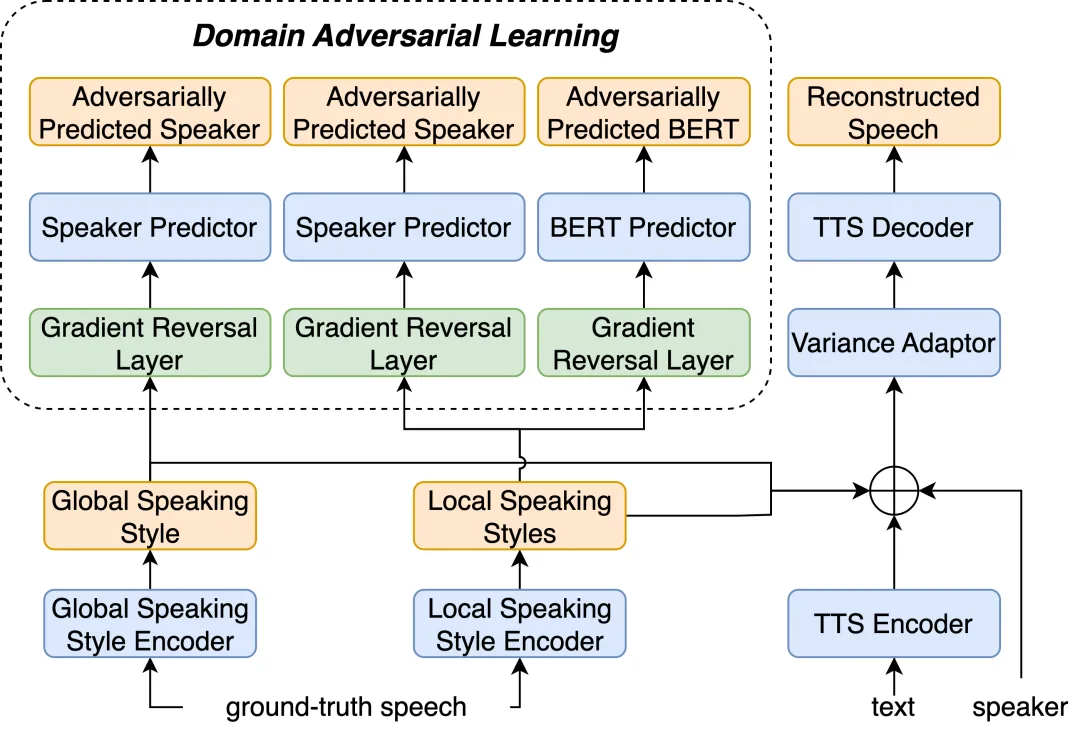
基于数据观测的结果,本文提出了一种双向跨语言多尺度语音风格迁移联合学习框架。该框架将两种语言之间两个配音方向上、两个尺度上的语音风格迁移联合为同一个框架进行学习。其中对于每个方向,则首先提取出两种语言上的多尺度文本和语音风格信息,之后分别通过双向句级别语音风格迁移模块和双向词级别语音风格迁移模块,预测出在另一种语言上的多尺度语音风格,最终通过多尺度语音风格可控的语音合成模型合成出对应的语音。多尺度文本和语音风格信息的提取
对于多尺度文本信息的提取,本文通过 BERT 模型提取了句级别和词级别文本信息。对于多尺度语音风格信息的提取,本文首先通过 GST (Global style token) 建模并提取了句级别语音风格信息。之后,本文参考 GST 的建模方式,借助基于神经网络的强制对齐模型NeuFA 实现了语音信息从帧级别到词级别的转换,进而建模并提取出了每个词的词级别语音风格信息表征 LST(Local style token)。另外,本文在 GST 与 LST 的建模中同时考虑了语音风格信息与说话人信息、文本信息之间的解耦,提升了 GST 与 LST 建模的鲁棒性。
句级别语音风格迁移
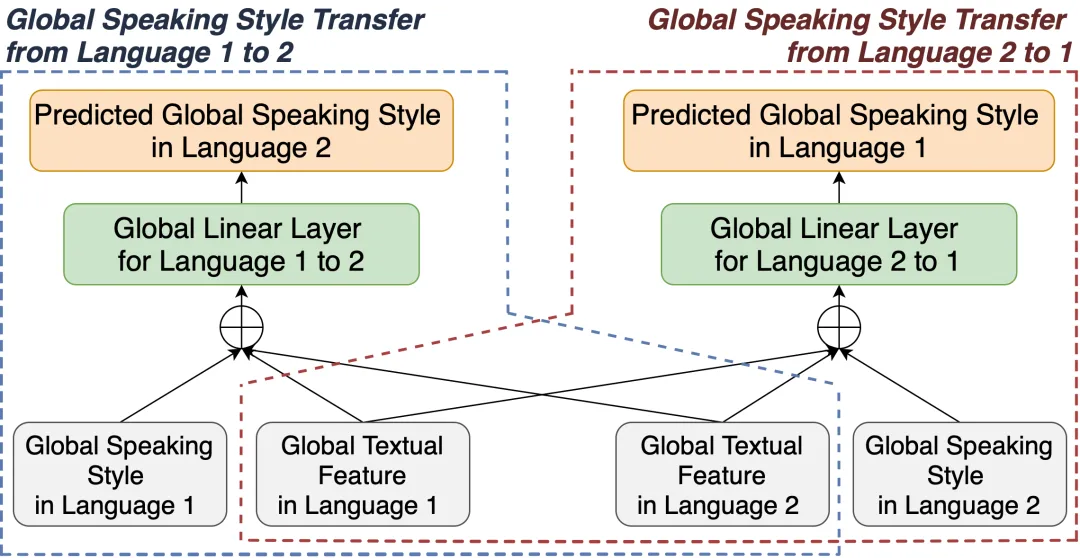
为了实现将一种语言句级别的语音风格迁移至另一种语言上,除了需要考虑源语言语音中的句级别语音风格信息之外,还需要考虑源语言和目标语言文本中的句级别文本信息。只有综合考虑这三者,才能针对直译或意译的不同情况,正确地将源语言的句级别语音风格迁移过来。对于句级别语音风格迁移,鉴于这三种信息均为句级别特征且维度一致,本文所提的框架中使用线性层来将其映射为在另一种语言上的句级别语音风格。词级别语音风格迁移
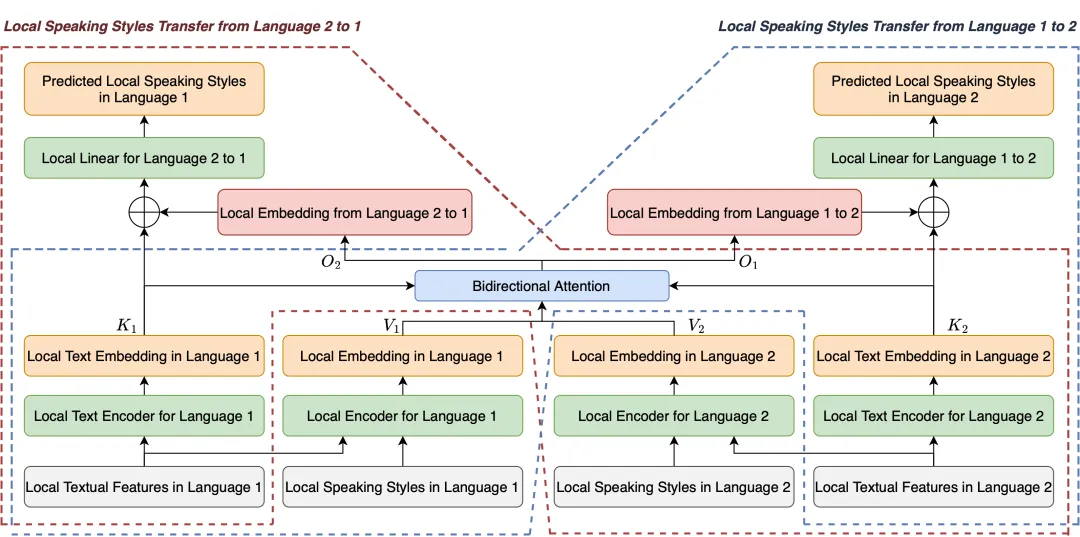
词级别的语音风格迁移的整体思想与句级别语音风格迁移是一致的。然而,由于源语言中词的个数和目标语言中词的个数很可能是不同的,这就导致词级别语音风格迁移不能像句级别语音风格迁移一样仅仅使用线性层预测。基于两种语言之间的语音风格迁移规律的双向性,本文针对两个跨语言语音风格迁移方向各构建了一个编码器-解码器结构,且这两个编码器-解码器结构通过使用了同一个双向乘性注意力机制实现了联合训练,共同优化这两个迁移方向之间的迁移规律学习。此处双向注意力机制输入的两个键序列分别为两种语言的文本信息序列,而值序列则为两种语言的多模态信息序列。而双向注意力机制根据两种语言之间不同词之间词级别文本信息的关系,将一种语言的多模态信息映射到另一种语言上。经过双向注意力机制的映射后,每个方向所汇总的源语言上的多模态信息的维度与目标语言的词文本信息序列的维度则已经一致,之后则仅需为每个迁移方向各自进行拼接,再由线性层预测在另一种语言上的词级别语音风格即可。基于 FastSpeech 2 的多尺度语音风格可控语音合成
最终,预测的在目标语言上的 GST 与 LST 则分别通过复制上采样至音素级别后,与 FastSpeech 2 的编码器输出拼接,合成为在目标语言上具有对应语音风格的语音。为了简化训练过程,本文首先预训练了 GST、LST 提取模块与对应的 FastSpeech 2 模型,并在训练过程中以预测的句级别和词级别语音风格表征与其在另一种语言上的真实值之间的均方误差作为损失函数。
6- 实验验证
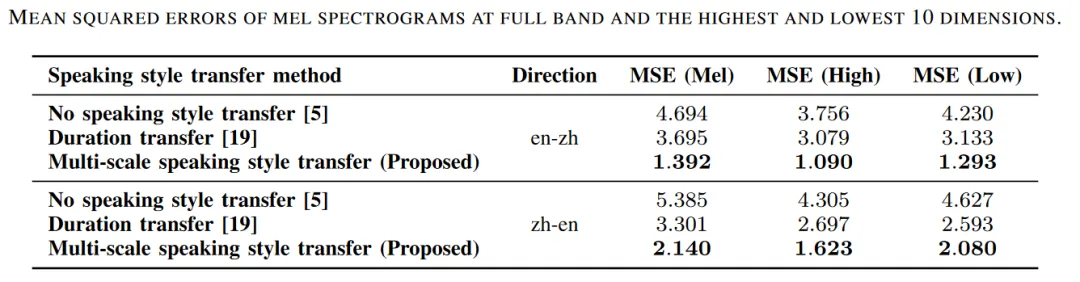
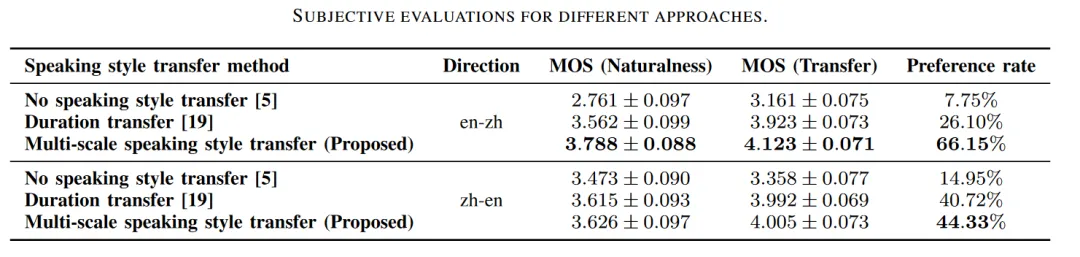
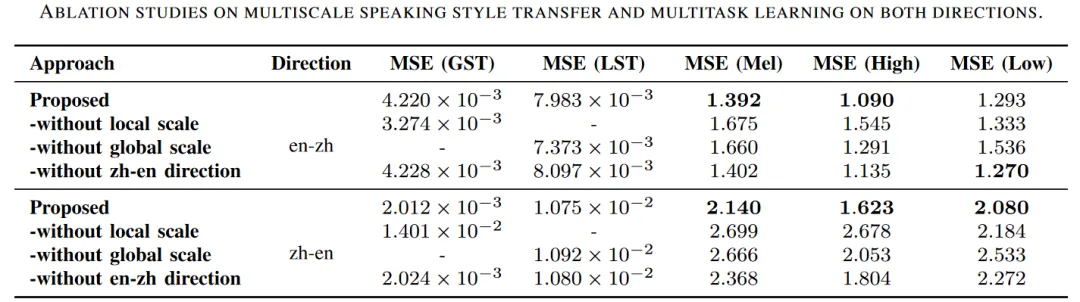
本文对所收集的游戏配音语料大约进行了 9:1 的训练集与测试集的划分,并选取不考虑语音风格迁移的标准 FastSpeech 2 模型,以及同样基于本文所提的双向词级别语音风格迁移模块,但只考虑时长迁移的 FastSpeech 2 模型作为基准模型。在客观评测中,本文比较了不同方法所合成的语音在全频带以及高频带、低频带上的梅尔频谱与真实值之间的均方误差。其中低频带的梅尔频谱的均方误差则在一定程度上反映了所预测的句级别语音风格的准确性,高频带的梅尔频谱的均方误差则在一定程度上反映了所预测的词级别语音风格的准确性。从实验结果可以看出,相比于基准模型,本文所提方法在各客观指标上均有着很大提升。在主观评测中,本文比较了不同方法所合成的语音通过 25 名评测者得出的自然度以及语音风格迁移效果上的主观平均得分(MOS)以及喜好率(Preference rate)。从实验结果可以看出,相比于基准模型,本文所提方法在自然度上与基准方法持平或更优,但在语音风格迁移的效果上要优于基准方法。本文额外注意到,本文所提方法在中-英及英-中这两个迁移方向上的效果存在差异。在英-中方向上,本文所提方法要显著优于基准模型方法。而在中-英方向上,本文所提方法的优势则不那么明显。本文猜测这可能与两种语言配音中语音风格的多样性不同有关,即可能中文配音中语音风格的多样性不如英文配音。在消融实验中,本文探究了去掉一个语音风格迁移尺度与去掉一个语音风格迁移方向对模型造成的影响。从实验结果可以看出,去掉一个语音风格迁移尺度或方向基本上均会导致梅尔频谱差异变大。特别地,在去掉语音风格迁移方向的实验中,可以看到去掉英-中方向对于中-英方向上的语音风格迁移学习影响更大。这也从另一个角度说明了可能中文配音中语音风格的多样性不如英文配音,以及跨语言语音风格迁移中双方向联合学习的必要性。
7- 结论
为了改善跨语言自动配音中目标语言语音的语音风格,本文基于对真实的跨语言配音语料的观测,首次提出了多尺度语音风格迁移任务,同时提出了一种基于双向注意力机制的双向跨语言多尺度语音风格迁移联合学习框架 StyleDub,可广泛应用于影视作品、短视频以及游戏配音的本地化过程。该框架可将源语言配音中的多尺度语音风格,自动迁移至目标语言的整句及对应词语上,提升了合成的跨语言配音语音的表现力。本文通过主客观实验及消融实验验证了所提方法的有效性以及多尺度联合建模、双方向联合建模的必要性。
 THUHCSI人机语音交互实验室