
 THUHCSI人机语音交互实验室
文章来源于THUHCSI人机语音交互实验室,作者HCSIers
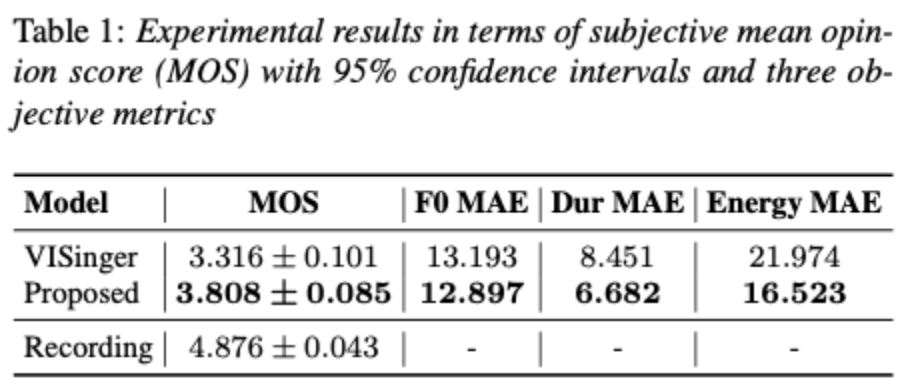
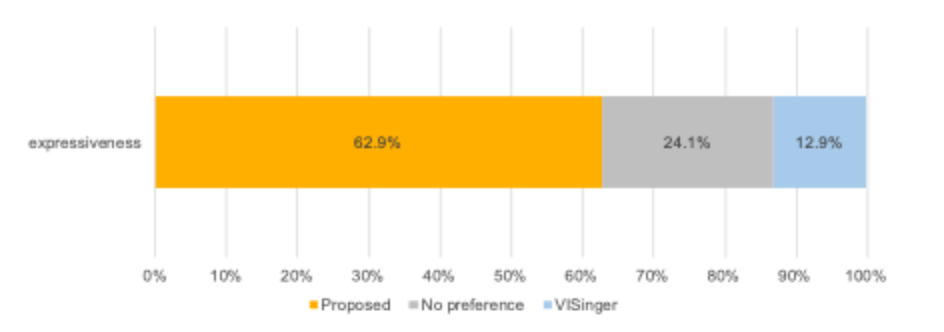
本文由清华大学与虎牙信息科技有限公司、元象唯思控股(深圳)有限公司和香港中文大学合作。人们在演唱时会根据歌词语义进行演绎以提高歌声表现力。现有歌声合成工作通常仅考虑基本乐谱内容,而忽视了歌词所蕴含的语义信息。针对该问题,本文基于VISinger框架提出了一种利用歌词蕴含的语义信息提高歌声表现力的方法:提出歌词语义提取模块,生成更符合歌词意境的高表现力歌声;构建音高及能量预测器,建模歌声的轻重强弱变化,提升歌声感染力。与基线系统VISinger相比,在中文歌声合成任务上,所提方法的用户偏好率最多可提升50%,主观意见得分最多可提升15%。
扫码阅读论文
https://www.isca-speech.org/archive/interspeech_2022/zhou22f_interspeech.html
合成样例试听
https://thuhcsi.github.io/interspeech2022-expressive-svs/
01 背景动机
随着深度学习的发展,基于神经网络的歌声合成模型已经可以按照乐谱信息合成高质量歌声。然而,合成歌声的表现力和真人演唱的录音相比仍有明显差距,使得歌声合成技术在诸多领域的应用受阻,如虚拟歌手,语音助手等。
人们在唱歌时,会根据歌词的语义信息,加入各种细节,如情绪和力度的变化,以增强歌声的感染力和表现力。为了提高合成语音的表现力,在语音合成领域,一些工作将BERT等预训练的语义信息作为语音合成模型的额外输入,取得了很好的效果。在歌声合成领域,虽然现有工作能够较为准确的合成歌声,但是还没有相关工作考虑利用歌词中所蕴含的语义信息,来提升合成歌声的表现力。同时,歌曲相对于语音的能量变化范围更大,如何建模能量以合成更稳定的歌声,也是高表现力歌声合成的重点。
02 贡献
本文设计了一种从歌词文本中提取语义信息的方法,其核心是基于预训练BERT模型从给定歌词文本中提取语义信息,以进一步提升合成歌声的表现力。该方法在VISinger的基础上增加了一个语义信息提取模块,模块包含一个中文预训练BERT模型,上采样模块以及文本编码器。我们认为,歌词的语义嵌入包含了有用的信息,如单词的类型和歌词的含义,这将指导歌声合成模型合成更自然、更具表现力的歌声。歌声的表现力可以体现在丰富的歌声强度和情感变化上。为了对频繁变化的能量进行建模,我们使用了一个包含能量预测器来提高合成歌声的表现力。最后,与直接预测歌声的音高相比,我们的方法预测了唱腔音高相对于乐谱音高的比例,目的是合成更自然的歌声,避免跑调问题。在中文歌声数据集OpenCpop上的客观和主观评价指标都表明,本文提出方法能够提升合成歌声的自然度和表现力。
03 解决方案
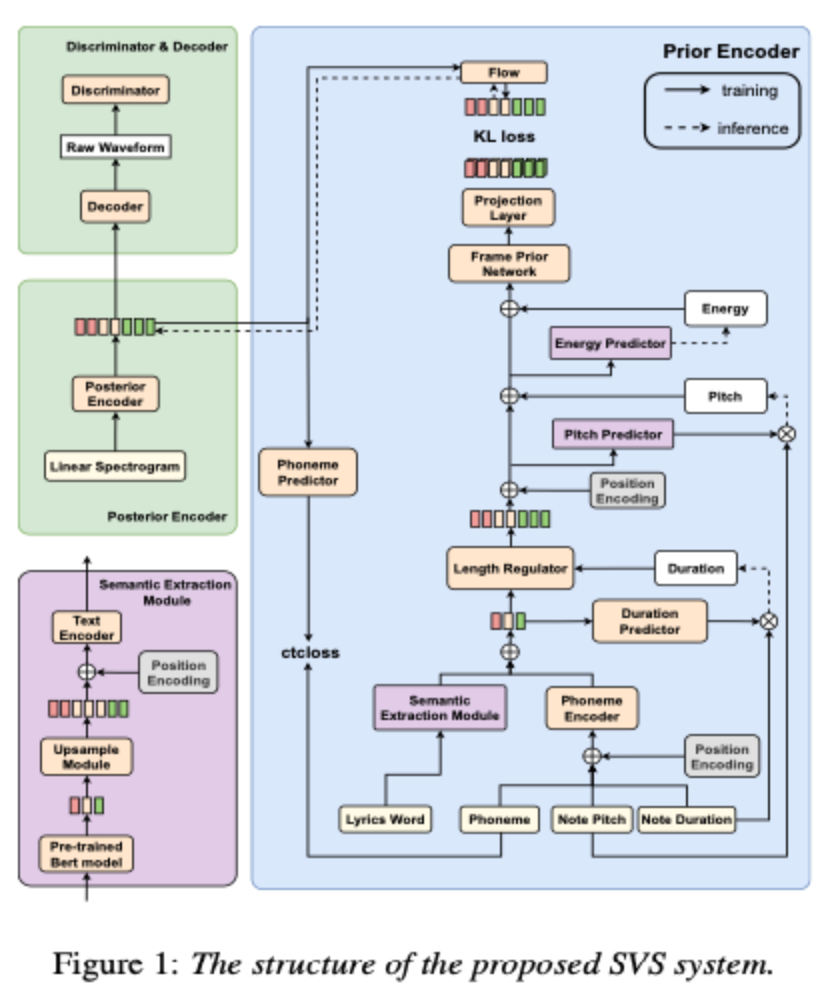
本文提出方法的模型结构如上图所示,模型整体包括一个后验编码器、一个先验编码器和一个解码器。在先验编码器中,如紫色块所示,我们提出了语义信息提取模块(Semantic Extraction Module)、能量预测器(Energy Predictor)并重新设计了音高预测器(Pitch Predictor)。模型整体搭建基于VISinger,语义信息提取模块将用于从歌词文本中提取语义信息,而能量预测器用于对歌声频繁变化的能量进行建模。音高预测器用于从中间特征中预测合成歌声的唱腔音高相对于乐谱音高的比值。
语义信息提取模块
音高预测器
能量预测器
04 实验验证
实验数据
基线系统
对比实验
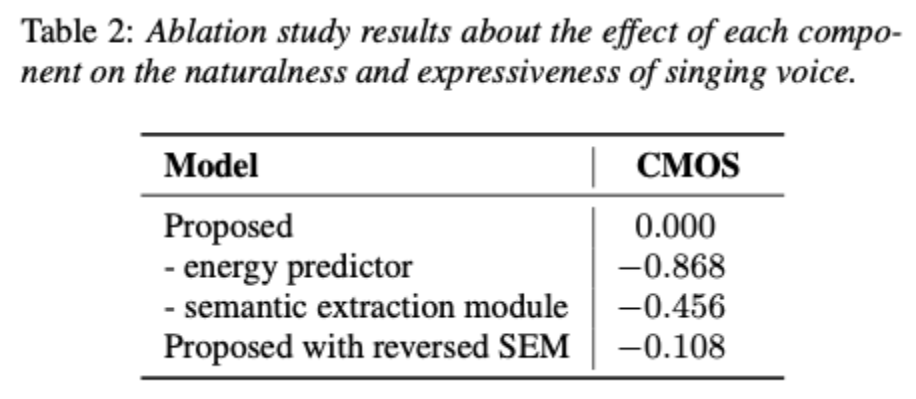
消融实验
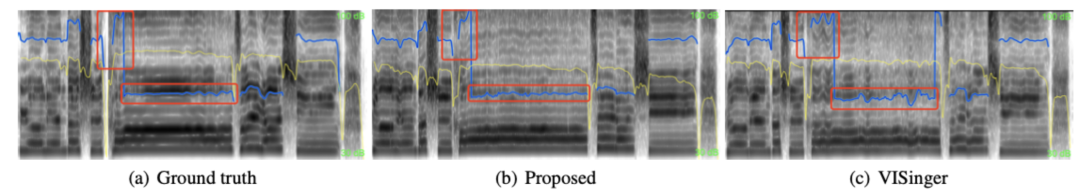
样例分析
05 结语
本文提出了一个高质量的歌声合成系统。该系统的搭建基于VITS的开源代码和VISinger的模型结构。为了提高合成歌声的表现力,我们提出了几点方法,包括语义提取模块、能量预测器和重新设计的音高预测器。在中文歌声数据集Opencpop上的实验表明,我们提出的方法在主观评价和客观指标上都优于VISinger。
在未来,我们将继续探索如何提高合成歌声的表现力,以进一步缩小合成歌声与人类演唱歌声之间的差距。
