
 语音小管家
单位:新疆大学计算机科学与技术学院、清华大学电子工程系
研究背景
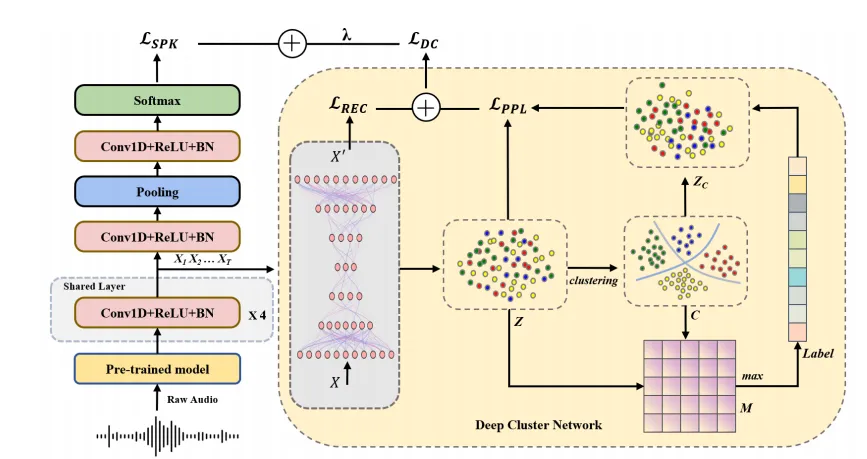
1.深度聚类网络
深度聚类网络采用由多个线性层组成的对称网络。它包含一个编码器和一个解码器。编码器将原始数据转换到低维空间,以获得与瓶颈特征类似的潜在特征。解码器将潜在特征重建为原始数据。本文中将潜在特征维度设置为50,其它网络结构设置与[1]相同。
我们使用预训练模型提取语音表征,然后采用多任务学习的方式联合深度聚类损失和说话人识别损失训练说话人识别网络。深度聚类损失通过深度聚类网络获得,它由伪音素标签(pseudo-phoneme label, PPL)损失[2]和重构损失组成。
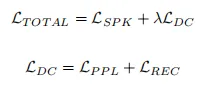
为计算PPL损失和重构损失,将语音中每一帧看作独立的特征。在训练过程中,首先将每批次语音的帧级别特征进行合并,得到只包含帧数和维度的数据X,然后X通过深度聚类网络编码器和解码器,得到潜在特征Z和重构数据X’。
深度聚类网络会进行特征降维处理,以获得有利于聚类的潜在表示,从而更好的进行聚类。在潜在特征Z上计算PPL损失如图1所示,首先对Z进行K-means聚类,得到具有m类中心的C,然后逐帧计算Z与类中心C的相似度,得到相似矩阵M。M中每一行最大值的位置即为伪标签,然后计算潜在特征与伪标签对应的类中心的距离得到PPL损失。此外,通过计算数据X和重构X’的均方误差可以得到重构损失。
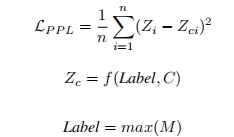
实验结果
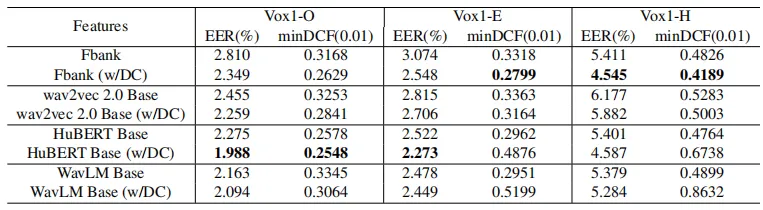
我们使用VoxCeleb2的开发集进行训练并使用VoxCeleb1的三个测试集进行测试。实验结果如表1所示。可以看出,相较于Fbank特征,使用预训练模型提取的特征在Vox1-O和Vox1-E测试集上表现出更好的性能。这表明使用预训练模型可以获取说话人相关的特征。在加入深度聚类损失后,模型在大部分测试集上的性能可以获得提升。进一步观察到,使用Fbank特征的模型不仅在Vox1-E和Vox1-H测试集中性能提升最明显,而且在Vox1-H测试集上获得了比使用预训练模型特征更好的性能。这是因为预训练模型已经学习到了部分说话人相关信息所以提升并不明显。Fbank特征则包含更多未进行学习的特征从而在我们提出的方法中展现出更大的潜力。
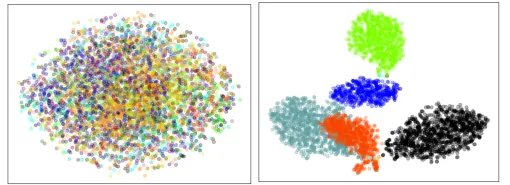
为了验证深度聚类损失对帧级别特征聚类效果的影响,我们从深度聚类网络中提取了5000个潜在特征和每个帧的伪音素标签,通过t-SNE工具包可视化深度聚类损失效果。如图2所示,在没有经过深度聚类损失训练时,帧级别特征分布杂乱无章,经过深度聚类损失训练后,一定程度上了调整了帧级别特征分布。因此,可以得出结论,通过联合计算深度聚类损失和说话人识别损失,可以使网络学习到类似音素的特征,起到发音对齐的效果。
小结
本文中,我们提出了一种深度聚类损失用于说话人识别任务。它在不需要使用额外包含文本标签的语音数据前提下,可以起到类似引入发音信息的效果。此外,为了提升系统性能,我们也对不同输入特征进行探讨,包括Fbank特征和预训练模型提取的特征。在VoxCeleb数据集上的实验结果验证了我们提出方法的有效性。
[2] Mengqi Niu, Liang He, Zhihua Fang, Baowei Zhao, and Kai Wang, “Pseudo-phoneme label loss for text-independent speaker verification,” Applied Sciences, vol. 12, no. 15, 2022.
