
 西工大音频语音与语言处理研究组
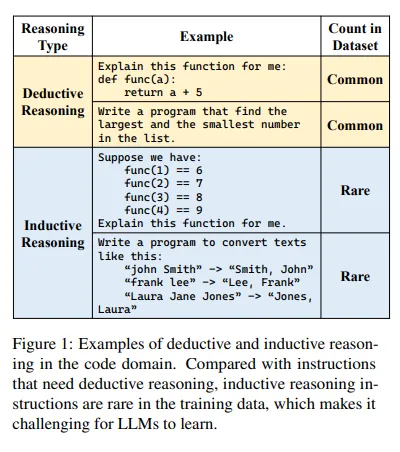
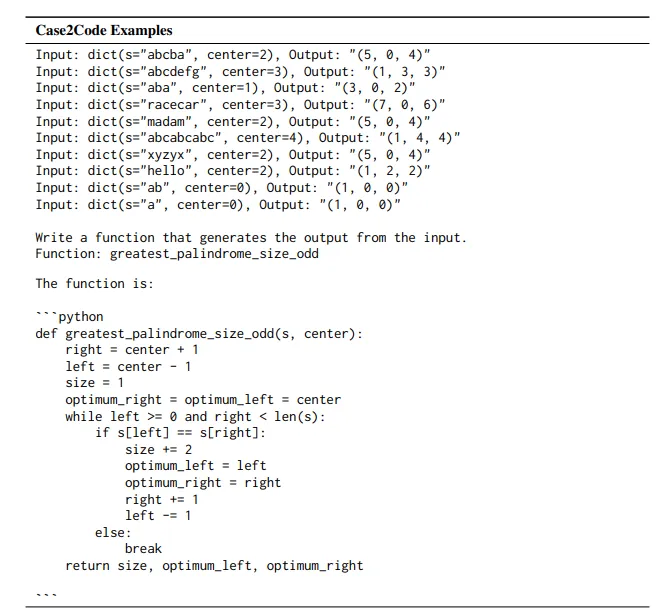
这种数据不平衡让LLMs在归纳推理上学习困难,也缺乏有效评估其归纳能力的标准。为了填补这一空白,复旦大学发起了一项名为Case2Code的挑战,它模拟了现实工作中的一个常见场景:根据几个输入输出示例来编写代码。刷过题的朋友们对这套模式一定不陌生~
除此之外,本文还提出了一套高效获取大规模、多样化Case2Code训练数据的方法。使用1.3M规模的合成数据训练的7B小模型在Case2Code评估集上的准确率大幅提升,最高增幅达18.9%,甚至超越了LLaMA3-70B和GPT-3.5,且与GPT-4旗鼓相当。
论文标题: Case2Code: Learning Inductive Reasoning with Synthetic Data
论文链接:https://arxiv.org/pdf/2407.12504
方法
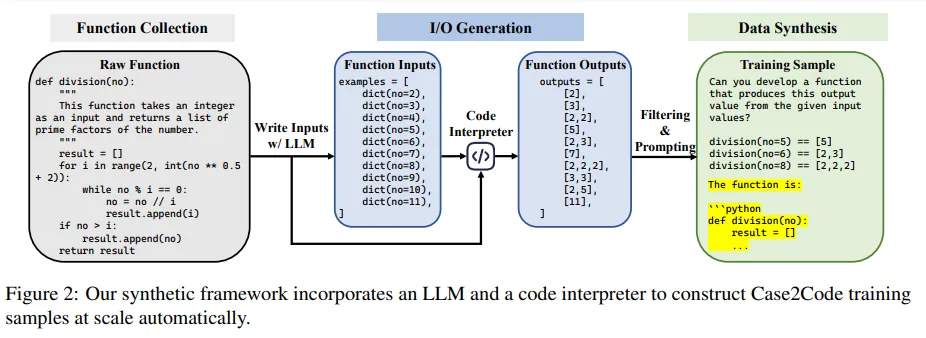
首先从大规模数据集中收集多样化的程序,并通过基于规则的过滤器进行筛选。接着利用LLM编写多样的示例输入,并通过代码解释器计算其对应的输出。最后根据输出筛选出低质量程序,并将获得的三元组(程序、输入、输出)转换为用于代码领域归纳推理的Case2Code数据。
1. 收集程序
为增强数据的多样性与质量,作者从The Stack 中采样有效的Python函数程序。利用现成的抽象语法树(AST)解析工具解析The Stack中的每个文件,以获取Python函数。且必须满足(1)通过语法检查;(2)具有一个或多个输入参数和返回值;(3)不依赖于第三方包或外部I/O操作。过滤后通过代码解释器进行验证,从而轻松获取多样化的Case2Code数据。
2. 生成输入
作者提示LLMs为每个函数编写输入参数,下表是一个简单的示例:
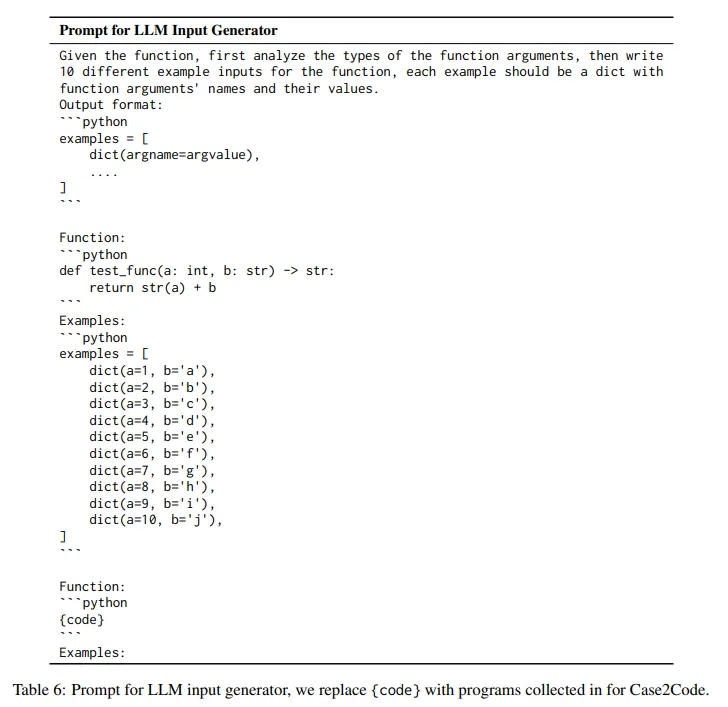
作者表示,这一步并不需要LLMs拥有多强大的能力,一些小LLM也可以轻松完成,以低成本高效地扩展生成过程
3. 获得输出
作者利用代码解释器执行函数并处理输入,从而获取对应的输出。鉴于LLM生成的输入样例可能存在错误,当函数输出不因输入变化而变动(恒定输出或抛出异常)时,该函数被视为无效并被剔除。
同时,为避免生成的Case2Code数据超出LLM的上下文窗口限制,排除了那些产生异常冗长输出值的函数
但是不会过滤掉导致异常或运行时错误的输入,失败的调用尝试也可以为归纳推理提供有价值的信息,以重建函数。
4.后处理
实验设置
合成数据规模
训练设置
评估设置
评估基准使用HumanEval和MBPP评估训练后的LLM编码能力,并引入EvalPlus——这两个基准的扩展版本,包含大量额外测试案例,以确保评估的严格性。
对于非指令调优模型,在HumanEval和MBPP上分别应用了zero-shot提示和 four-shot提示进行测试。而对指令对齐的LLM,则统一采用zero-shot提示在所有基准上进行评估。
结果分析
zero-shot性能评估
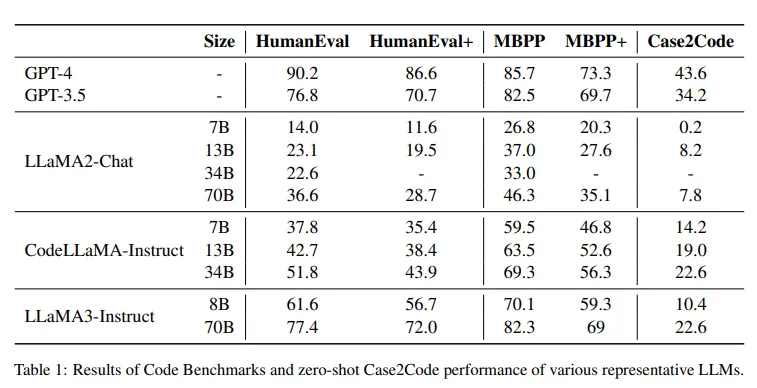
分析显示,这些模型在Case2Code任务中的表现与其程序合成能力紧密相关,在其他基准上获得高分的模型在Case2Code中同样表现出色,且规模较大的模型普遍优于小规模模型。这表明Case2Code是一个有效的基准,能够反映LLM的代码推理能力。
Case2Code的泛化能力
直接微调
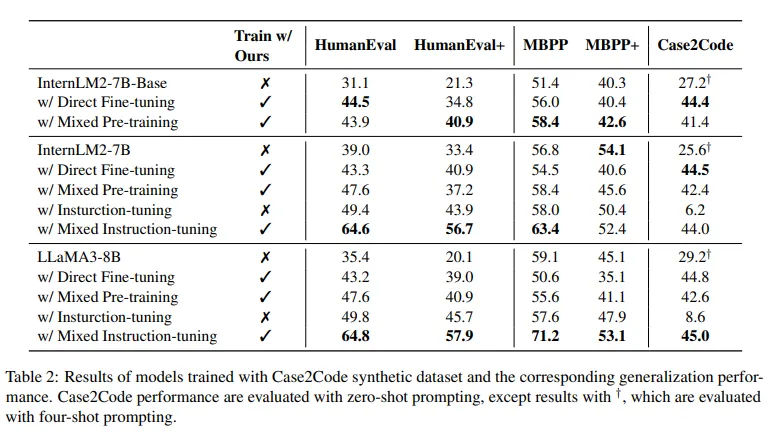
通过Case2Code样本的训练,不仅能强化LLM的归纳推理能力,还能增强其代码理解和生成的整体水平。
在预训练阶段混合
相较于仅在Case2Code数据集上微调,此策略能更广泛地迁移通过Case2Code任务习得的代码状态归纳推理能力,实现更好的泛化效果。
在指令微调阶段混合
在采用instruction-following数据集训练时,融入Case2Code数据显著增强了LLM在基于指令编程任务上的性能。
消融实验
提示的多样性
由于Case2Code训练数据源自(程序、输入、输出)三元组的转换,提示模板在构建过程中扮演关键角色。作者对比了单一模板与多模板风格提示下的合成数据效果。如下图所示:
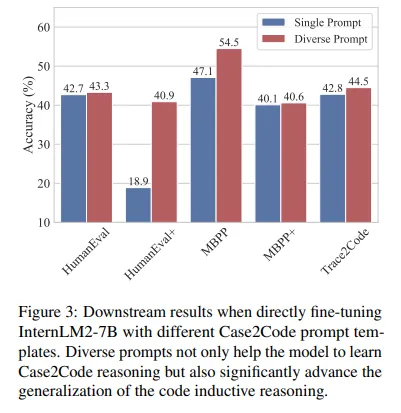
尽管域内Case2Code性能受提示多样性影响较小,但LLM在域外程序合成任务上的准确性却显著提升,这揭示了多样性在LLM学习中的潜在关键作用。
用于生成输入的LLM的影响
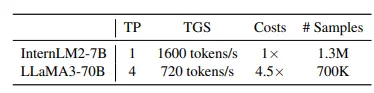
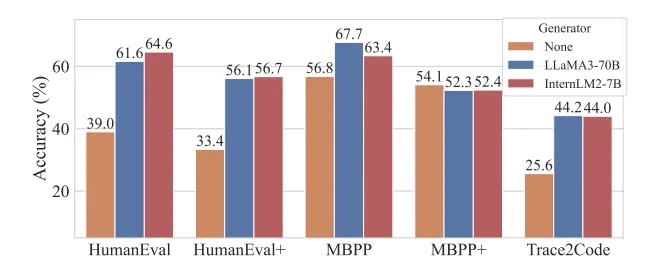
然而低成本版本InternLM2-7B也达到了和LLaMA3-70B相当的效果,不失为一个性价比更高的选择!
模型规模
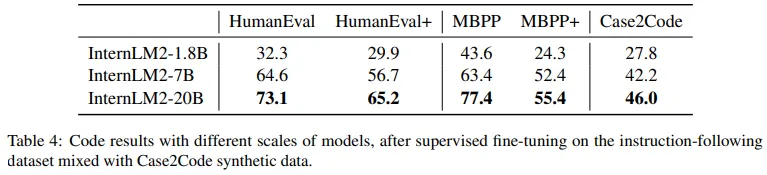
为了探究利用小模型合成的Case2Code数据是否依然能有效提升大模型的性能,并深入分析模型规模对学习过程的影响。作者采用InternLM2-7B生成的Case2Code数据,混合SFT数据集对不同大小的InternLM2系列模型进行了训练。实验结果如下表:
结论
作者构建了一个新的基准——Case2Code,用于评估LLMs在代码领域的归纳推理能力,并提出了一个数据合成框架,仅使用小型LLM和代码解释器就能自动高效地从预训练代码文本中收集高质量的Case2Code训练数据。通过在不同设置下训练各种LLM,本文证明了Case2Code不仅能提升LLM的归纳推理能力,还能提高其整体编码能力。我们可以期待,当人类生成的数据用尽时,合成的Case2Code能够持续为改进LLM生成高质量的数据~
