
 西工大音频语音与语言处理研究组
本文,第一部分深入解读whisper论文的引言、数据集、方法、结论和总结;第二部分简单介绍,基于whisper做微调和推理的框架,以方便研究者和工程师研读和复现论文。
论文的数据收集来源于爬取了网络上具有音频和文本对的数据,然后进行清洗和加工。
从网络爬取语音、文本对的数据(标注质量不高的弱标签数据);
通过启发式算法(机器生成数据格式较固定,例如全大写、全小写等)过滤机器生成的数据;
校验音频和文本的语种标签(语种分类模型使用VoxLingua107数据集训练得到);
所有音频统一对齐并分割成30秒;
使用初始模型对训练数据子集的错误率排序,并排查、过滤错误率较高子集,以保证标注质量;
基于标注文本进行模糊去重。
清洗后得到的68万小时高质量的有监督数据,具体数据分布如下
英文语音识别数据43.8万,占比65%
多语种语音识别数据11.7万,占比17%
目标语种为英文的翻译数据12.5万,占比18%
模型
为了证明大规模高质量有监督数据的有效性,论文直接使用标准的transfomer结构(包含提取音频隐状态的encoder和进行文本标签自回归学习的decoder两个主体结构)进行训练。计算方式包含几个主要的流程:首先,以25ms窗长、10ms步幅的参数提取fbank特征;然后,fbank特征过两个卷积层(为了降低特征复杂度第二层卷积使用步幅为2进行2倍降采样)并加入位置编码;接着,再过标准的transformer-encoder进行self-attention计算得到音频的encoder-hidden_state;最后,关键步骤是decoder的自回归学习方式:根据当前标签预测下一个标签过程同时条件于encoder-hidden_state,具体实现方式是encoder-hidden_state(音频隐状态)和decoder需要预测的token(文本标注)之间计算两个序列的cross-attention,最终得到logits并和label输入到交叉熵损失函数计算loss。
多任务格式设计
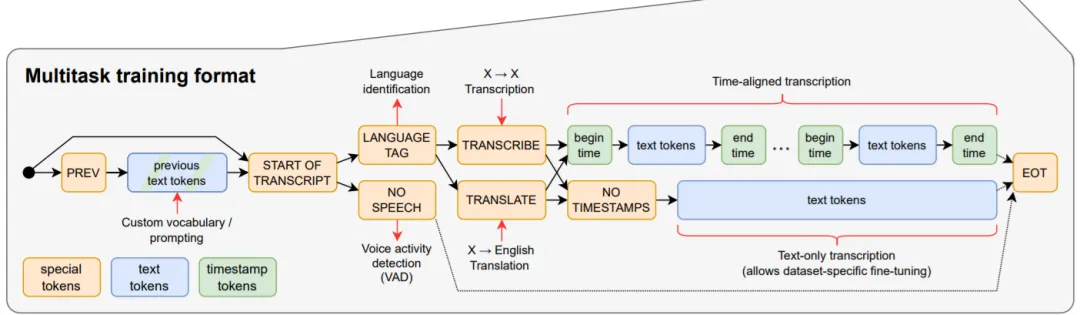
第一种任务类型是语音活动检测:对应图中最后一条横向箭头所指的数据格式,数据格式包含代表任务起始的SOT、没有语音的NO-SPEECH和任务结束的EOT; 第二种任务类型是语音识别:包含代表任务起始的SOT、语种LANGUAGE-TAG、任务实例为识别的TRANSCRIBE、实际标签的text-tokens(蓝色部分)和任务结束的EOT; 第三种任务类型是语音翻译:包含代表起始的SOT、语种LANGUAGE-TAG、任务实例为翻译TRANSLATE、实际标签的text-tokens(蓝色部分)和任务结束的EOT。 第四种任务类型是语种检测:相对于前三种任务语种预测有些特殊,因为训练阶段是语种检测是作为语音识别和翻译的子任务进行训练,但推理时候是可以独立去预测语种分类标签的。
备注:prompt作为一种通用技术,可以灵活地添加和支持更多的音频任务,例如Qwen-audio就参考whisper-pompt格式并扩展支持更多的音频任务。
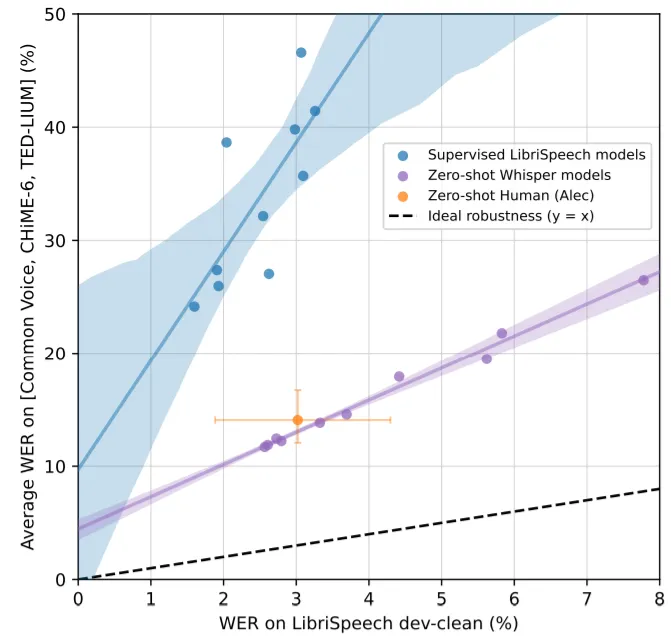
单语种识别Whisper的英文识别鲁棒性非常好,具体效果如下图,紫色部分代表whisper、蓝色代表其它模型、纵坐标是几个英文测试集,可以看到:相比其它模型,whisper在不同英文测试集上效果都相对更好更稳定。
总 结
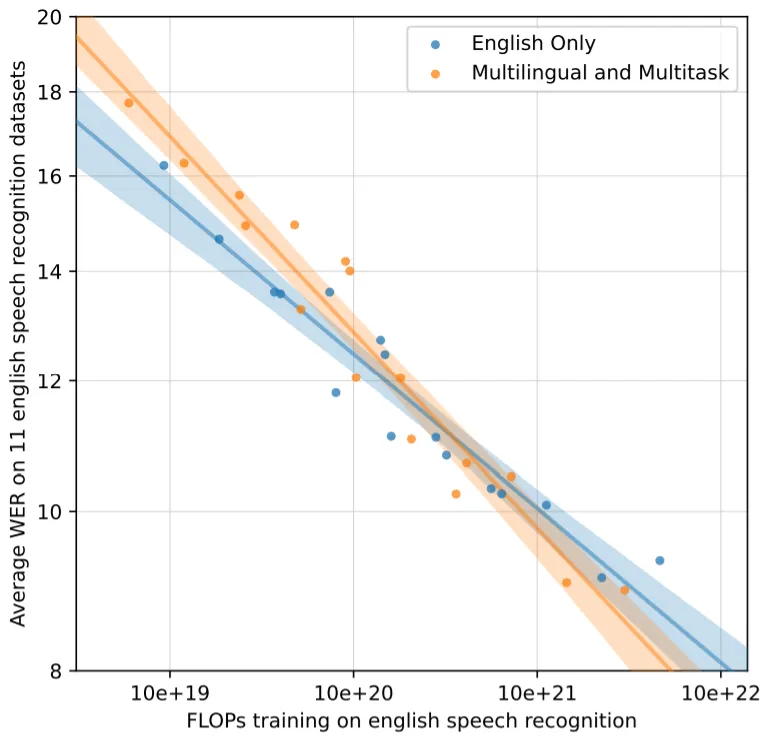
大规模高质量有监督数据带来很好的泛化性能论文证实了在68万小时高质量数据加持下,即使直接使用标准transformer这种没有经过专门优化的模型,也不需要复杂的特定任务微调流程,whisper就可以在多个任务测试集上取得很好泛化能力并且它的英文识别效果可以媲美优秀的商用方案。
未来展望
提高解码策略探索解码技巧来改善语音大模型幻觉问题
增加低资源语种的数据低资源语种数据的扩充预估可以大幅改善多语种效果
研究模型的鲁棒性引入CTC损失函数或者研究和LLM的结合
