
 西工大音频语音与语言处理研究组
语音转换 (Voice Conversion) 旨在保留语音中语言内容信息的同时,将源说话人音色转变为目标说话人的音色。越来越多的应用场景,如直播、视频会议等实时通信(RTC)应用中要求语音转换能够实时进行,而目前常见的语音转换模型以整段音频为输入进行转换,难以满足实时低延迟需求。在前作DualVC与DualVC 2中,我们实现了鲁棒流式语音转换,但延迟方面仍有很大的提升空间。
近期,西工大音频语音与语言处理研究组(ASLP@NPU)和网易伏羲合作论文“DualVC 3: Leveraging Language Model Generated Pseudo Context for End-to-end Low Latency Streaming Voice Conversion”被语音研究顶级会议INTERSPEECH 2024接收。该论文提出了利用语言模型(LM)生成伪上下文的端到端低延迟流式语音转换模型—DualVC 3,去除了对ASR的依赖,显著降低延迟同时保证了转换效果。现对该论文进行简要的解读和分享。
如图1所示,DualVC 3 为一种端到端流式语音转换模型,以 Mel 谱作为输入和输出。它由一个内容编码器、一个解码器和一个语言模型 (LM) 组成。其中内容编码器与解码器均为 Conformer 结构,使用 DCT [4] 策略训练。
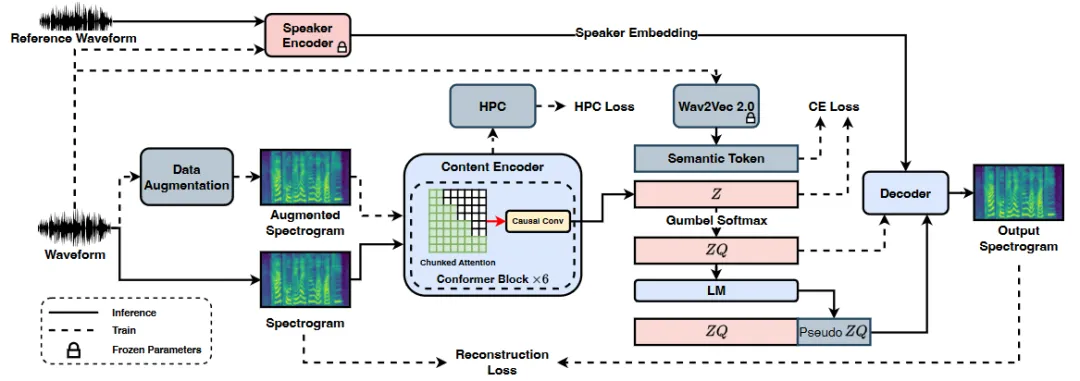
图1 DualVC 模型结构
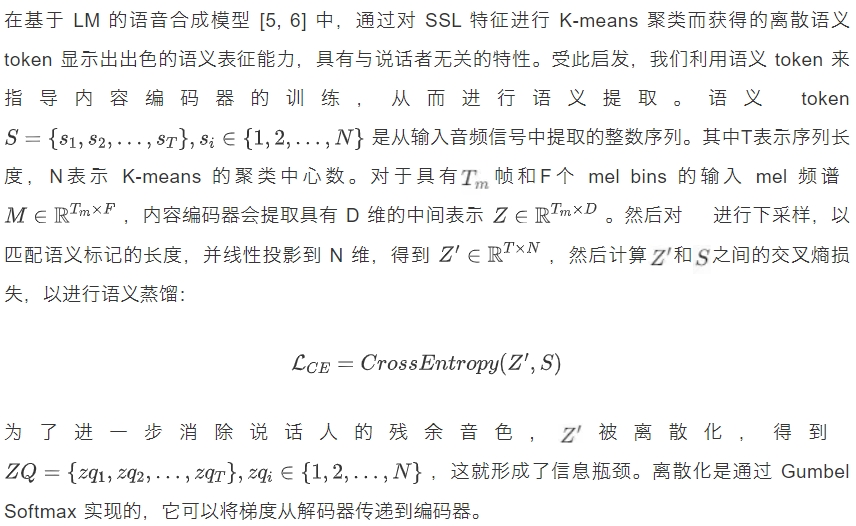
语义蒸馏
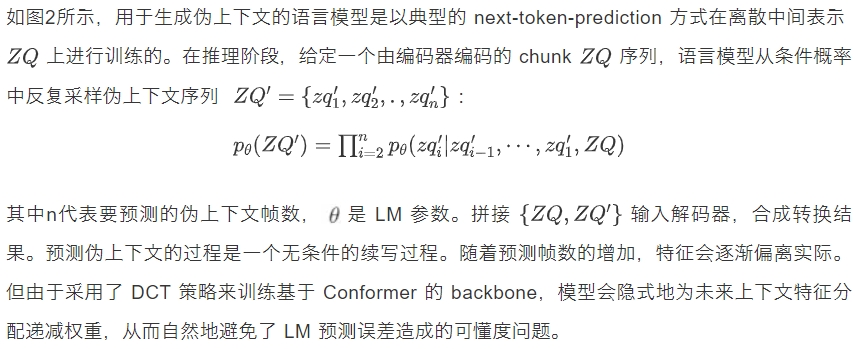
基于LM的伪上下文生成
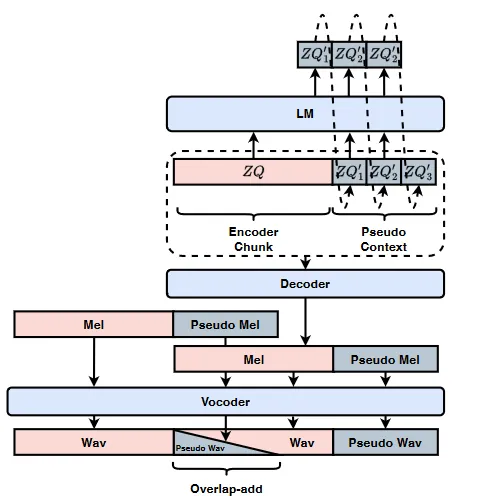
图2 LM, 解码器与 Vocoder 推理流程
实验设置
实验数据:AISHELL 3[7],包含来自218个说话人的88,035条数据。
对比系统
VQMIVC [8]:代表典型的模型内解耦的语音转换模型
DualVC 2 [2]:前作方案
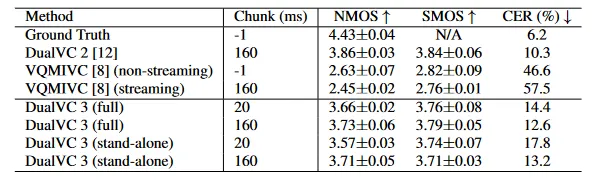
主观测试
客观测试
字错误率:使用语音识别模型分别对于各个模型生成的语音进行识别并计算词错误率。与主观测试结论相同,在流式与非流式场景下,DualVC 3 全面超越了baseline模型,并达到与 DualVC 2 可比的水平。 编码器输出可视化:如图 3 所示,编码器输出通过 t-SNE 投影到二维,每种颜色代表一个说话人。在离散语义 token 的引导下,编码器成功提取了与说话者无关的语义信息。 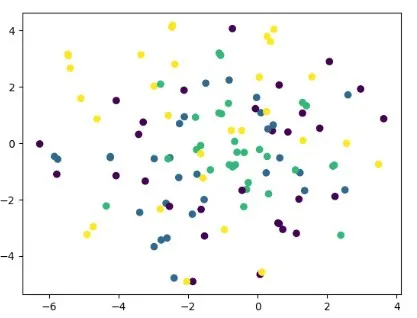
图3 编码器输出的 t-SNE 可视化,每种颜色代表一个说话人 计算效率:我们考虑了三个主要指标:实时性(RTF)、延迟和参数量,结果如表2所示。在使用 LM 时,RTF 为0.797,延迟为55.94 ms;不使用 LM 时,RTF 为0.181,延迟为43.58 ms。
表2 计算与实时性指标 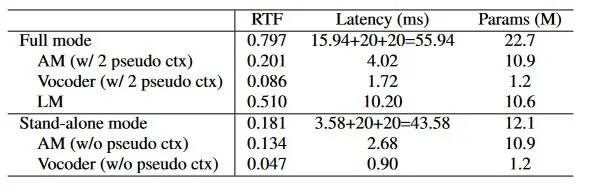
[1] B. Sisman, J. Yamagishi, S. King, and H. Li, “An overview of voice conversion and its challenges: From statistical modeling to deep learning,” IEEE ACM Trans. Audio Speech Lang. Process., vol. 29, pp. 132–157, 2021.
[2] Z. Ning, Y. Jiang, P. Zhu, S. Wang, J. Yao, L. Xie, and M. Bi, “Dualvc 2: Dynamic masked convolution for unified streaming and non-streaming voice conversion,” in Proc. ICASSP. IEEE, 2024, pp. 1–5.
[3] Z. Ning, Y. Jiang, P. Zhu, J. Yao, S. Wang, Lei Xie, and Mengxiao Bi, “Dualvc: Dual-mode voice conversion using intra-model knowledge distillation and hybrid predictive coding,” in Proc. INTERSPEECH. 2023, pp. 2063–2067, ISCA.
[4] Z. Yao, D. Wu, X. Wang, B. Zhang, F. Yu, C. Yang, Z. Peng, X. Chen, L. Xie, and X. Lei, “Wenet: Production oriented streaming and nonstreaming end-to-end speech recognition toolkit,” in Proc. INTERSPEECH. 2021, pp. 4054–4058, ISCA.
[5] E. Kharitonov, D. Vincent, Z. Borsos, R. Marinier, S. Girgin, O. Pietquin, M. Sharifi, M. Tagliasacchi, and N. Zeghidour, “Speak, read and prompt: High-fidelity text-to-speech with minimal supervision,” CoRR, vol. abs/2302.03540, 2023.
[6] Z. Borsos, R. Marinier, D. Vincent, E. Kharitonov, O. Pietquin, M. Sharifi, D. Roblek, O. Teboul, D. Grangier, M. Tagliasacchi, and N. Zeghidour, “Audiolm: A language modeling approach to audio generation,” IEEE ACM Trans. Audio Speech Lang. Process., vol. 31, pp. 2523–2533, 2023.
[7] Y. Shi, H. Bu, X. Xu, S. Zhang, and M. Li, “AISHELL-3: A multi-speaker mandarin TTS corpus,” in Proc. INTERSPEECH. 2021, pp. 2756–2760, ISCA.
[8] D. Wang, L. Deng, Y. T. Yeung, X. Chen, X. Liu, and H. Meng, “VQMIVC: vector quantization and mutual information-based unsupervised speech representation disentanglement for one-shot voice conversion,” in Proc. INTERSPEECH. ISCA, 2021, pp.1344–1348
