SpeechGPT2 是由复旦大学计算机学院开发的一个端到端的语音对话语言模型,类似于 GPT-4o。能够感知并表达情感,并根据上下文和人类指令以多种风格提供合适的语音响应。如说唱、戏剧、机器人、搞笑和低语等。
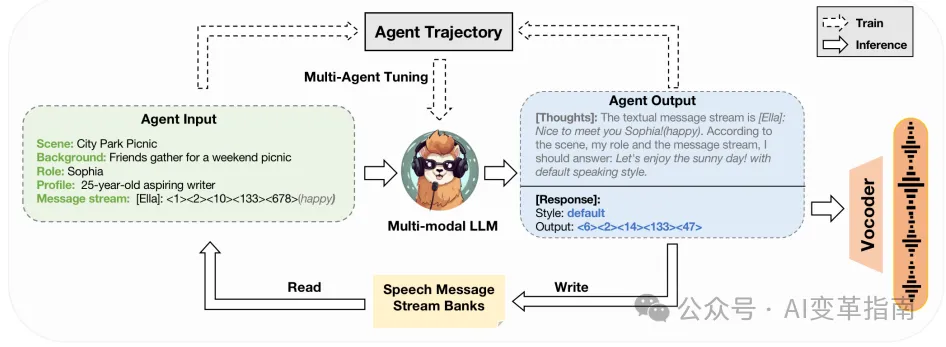
SpeechGPT2的核心技术,在于它巧妙地将连续的语音信号进行离散化处理,使之能够与本模态统一,实现了语音与文本之间的自由穿梭。在SpeechAgents中,每个代理在推理和训练时的工作流程是这样的:当轮到某个代理时,它会接收到一些输入信息,包括场景、背景、角色、个人资料和来自语音消息流银行的消息流。然后,这个代理会生成它的内心想法、语音响应和相应的风格。生成的响应会被写入语音消息流。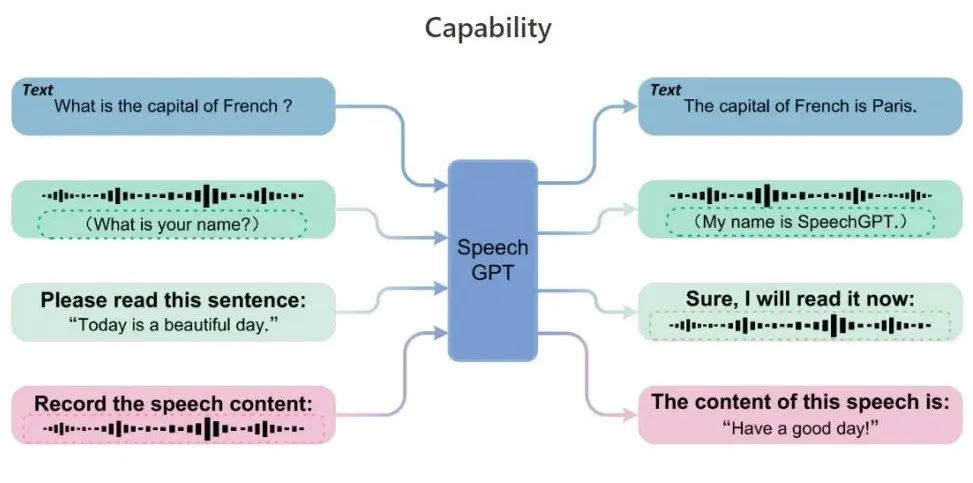
为了训练SpeechGPT,研究团队采用了一个三阶段的训练策略: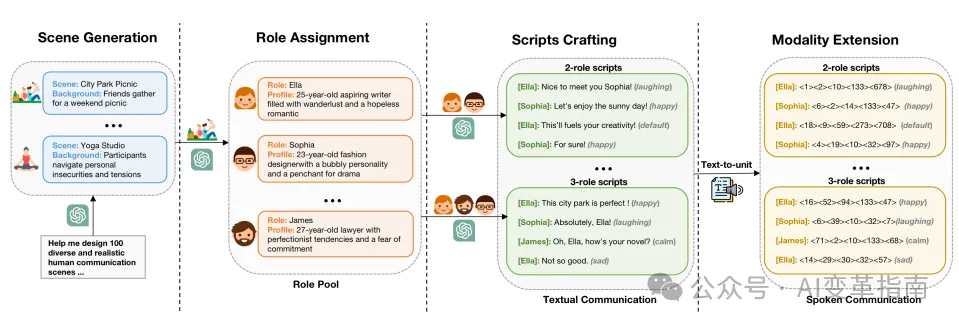
为了解决冗长的语音序列问题,SpeechGPT2 采用超低比特率语音编解码器(750bps),模拟语义和声学信息,并通过多输入多输出语言模型(MIMO-LM)进行初始化。实验结果显示,SpeechGPT在文本任务、跨模态任务和口语对话任务上都展现出了强大的能力。它能够准确理解和执行各种指令,无论是将语音转录为文本,还是将文本转换为语音,或是进行口语对话。尽管SpeechGPT展现了卓越的能力,但受限于计算和数据资源,目前,SpeechGPT2还是一个基于轮次的对话系统,在语音理解的噪声鲁棒性和语音生成的音质稳定性方面仍有不足,正在开发全双工实时版本,并已取得一些有希望的进展。
 语音小管家