
 语音小管家
DeepShip数据集是一个大规模的真实世界水下录音数据集,专门用于水下声学研究,包括船只分类和噪声检测。
DeepShip数据集规格
以下是对DeepShip数据集规格的详细总结:
数据集规模和多样性
包含47小时和4分钟的真实世界水下录音。
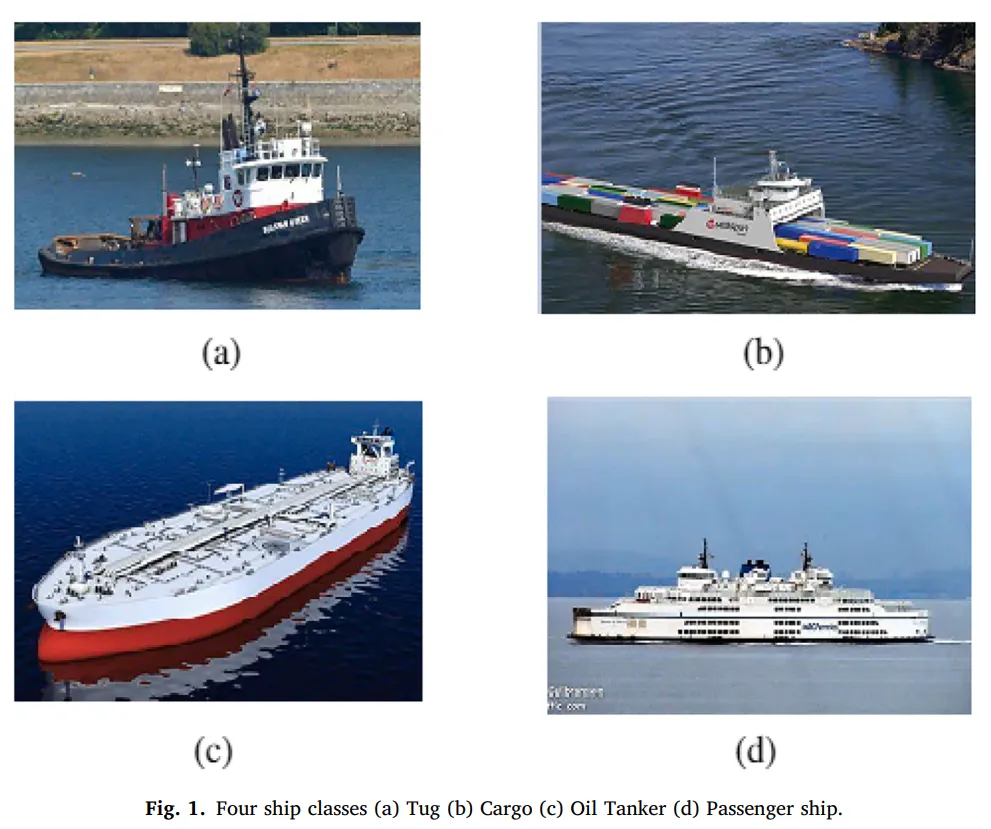
录音涵盖了265艘不同的船只,分为四个类别:油轮(Oil Tanker)、拖船(Tug)、客轮(Passenger Ship)和货轮(Cargo Ship)。
录音条件
录音在一年中的不同时间进行,包括不同的海况和噪声水平。
录音地点位于太平洋西北海岸最繁忙的航道之一,靠近加拿大最繁忙的港口——温哥华。
数据收集
使用Ocean Sonics icListen AF水听器进行数据收集,该设备具有高灵敏度和宽频带特性。
录音以32 kHz的采样率保存,并以wav文件格式提供,以确保与机器学习和深度学习社区使用的平台/库兼容。
数据标注
利用自动识别系统(AIS)数据来获取船只的位置和时间戳,确保数据集的准确性。
只包括在水听器2公里半径内单独船只发出的信号。
数据集结构
数据集分为四个类别的文件夹,每个类别包含两种类型的文件:.wav音频数据文件和包含录音信息的元数据文件(如cargo-metafile, tug-metafile等)。
元数据文件提供了诸如船只ID、录音ID、船只名称、录音日期和时间、录音时长以及船只与传感器之间的距离等信息。
数据集可用性
数据集可以在GitHub的特定仓库下载,但由于文件大小和存储空间限制,只有部分数据集被上传到该仓库。
提供了详细的下载信息,以便用户可以下载完整的数据集。
数据集特点
提供了大规模的、高质量的、经过良好标注的水下录音数据,为水下声学分类任务提供了丰富的资源。
由于录音涵盖了不同的环境条件和船只类型,数据集具有很高的多样性和代表性。
数据集应用
可以用于训练和评估不同的机器学习和深度学习算法,以提高水下声学信号分类的准确性。
适用于军事目的以及商业用途,如海上交通管理、渔业和海洋环境保护。
数据集贡献
DeepShip数据集的提供,不仅有助于评估现有算法的性能,也将促进未来水下声学分类技术的发展。
预处理步骤
DeepShip数据集在用于训练和评估船只分类模型之前,经过了以下预处理步骤:
数据分割
将录音分割成多个时间段,每个时间段对应一个独立的数据样本。这是为了确保模型可以处理和学习不同时间段内的声学特征。
采样率调整
原始录音可能以不同的采样率进行,预处理中可能包括将所有录音重采样到统一的采样率,例如32 kHz,以便于处理和分析。
帧分割
将每个时间段的信号分割成短帧,并使用滑动窗口方法来提取帧。这些帧通常用于时频特征的提取。
特征提取
从分割得到的帧中提取时频特征,如梅尔频率倒谱系数(MFCC)、梅尔频谱图、小波包、伽马tone频率倒谱系数(GFCC)、恒定Q变换(CQT)和倒谱等。
数据格式化
将提取的特征转换为适合输入到机器学习和深度学习模型的格式,例如将时频特征转换为图像形式。
数据增强
尽管文档中没有明确提到,但数据增强是提高模型泛化能力的一个常见步骤,可能包括添加噪声、时间拉伸、频率偏移等技术。
数据标注
使用自动识别系统(AIS)数据来获取船只的位置和时间戳,以确保数据集的准确标注。
数据集划分
将数据集划分为训练集和测试集,以评估模型性能。通常一部分数据用于训练,另一部分用于测试。
数据平衡
确保训练和测试集中各类别样本的数量均衡,避免模型对某一类别的偏见。
归一化/标准化
可能对特征数据进行归一化或标准化处理,以消除不同特征量纲带来的影响,加速模型训练过程。
去除无关噪声
在某些情况下,可能需要去除录音中的非目标噪声,如环境噪声或其他非船只噪声。
数据集结构化
将数据组织成结构化的格式,如文件夹按船只类别分类,以及包含元数据的文件,以便于数据管理和访问。
这些预处理步骤为后续的特征学习和模型训练提供了干净、一致且格式正确的数据输入。
声纳性能指标
DeepShip表格提供了一个名为icListen Smart Hydrophone的智能水听器的主要规格和特性。以下是对表格中各项参数的翻译和解读:
Bandwidth (带宽):1 Hz to 12 kHz。这意味着水听器可以捕捉从1赫兹到12千赫兹的声波,覆盖了人耳听力范围之外的更广频率。
Dynamic Range (动态范围):120 dB。表示水听器能够处理的声音强度范围,120分贝的动态范围意味着它可以分辨非常微弱到非常响亮的声音。
Sensitivity (灵敏度):−170 dBV re. μPa。这指的是水听器对声波的敏感度,−170 dBV re. μPa是一个相对较高的灵敏度,意味着它可以检测到非常微小的声压变化。
Sampling frequency (采样频率):32 kHz。水听器每秒可以采样32000次,这为捕捉高频声音提供了足够的采样点。
Power Input (电源输入):12–24 Vdc, 0.8 W。水听器的电源输入范围是12到24伏特直流电,消耗功率为0.8瓦特。
Output Interface (输出接口):Ethernet。数据通过以太网接口传输,这是一种常见的网络传输方式,可以方便地与其他设备连接。
Internal Storage (内部存储):32 GB。水听器内置32GB的存储空间,用于保存录制的音频数据。
Case Material and Depth (外壳材料和深度):Engineered Plastic – 200 m, Titanium - 3500 m。水听器的外壳材料根据使用深度不同而有所区别,在200米深度以内使用工程塑料,在3500米深度以内使用钛金属,以适应不同的水下压力。
这个水听器是一个紧凑型的全合一仪器,设计用于实时处理采集到的数据,并能直接输出数字信号。它被设计用于在水下环境中长时间记录音频数据,适用于海洋生物观察、船舶交通监控以及其他水下声学研究。
数据收集处理流程
DeepShip数据集中的船只分类是基于水下声学信号的录音来进行的。关键因素包括:
声学特征
船只发出的声音信号包含了可以用于分类的特征,如发动机噪音、螺旋桨噪声等。
录音条件
数据集在不同的海况和季节条件下收集,确保了录音的多样性和代表性。
船只类型
数据集涵盖了不同类型的船只,包括油轮、拖船、客轮和货轮,每种类型的船只都有其独特的声学特征。
时间-频率特征
从录音中提取的特征包括梅尔频率倒谱系数(MFCC)、梅尔频谱图、小波包、伽马tone频率倒谱系数(GFCC)、恒定Q变换(CQT)和倒谱等,这些特征有助于揭示船只声音信号的不同方面。
自动识别系统(AIS)数据
使用AIS数据来获取船只的位置和时间戳,确保了录音数据的准确标注。
信号处理技术
应用各种信号处理技术来增强信号并提取有用的特征,如滤波、去噪等。
机器学习和深度学习算法
使用不同的机器学习和深度学习算法来训练模型,以识别和分类船只类型。这些算法包括支持向量机(SVM)、随机森林(RF)、K最近邻(KNN)、朴素贝叶斯等传统方法,以及卷积神经网络(CNN)、残差网络(ResNet)、Inception网络等深度学习方法。
特征可视化
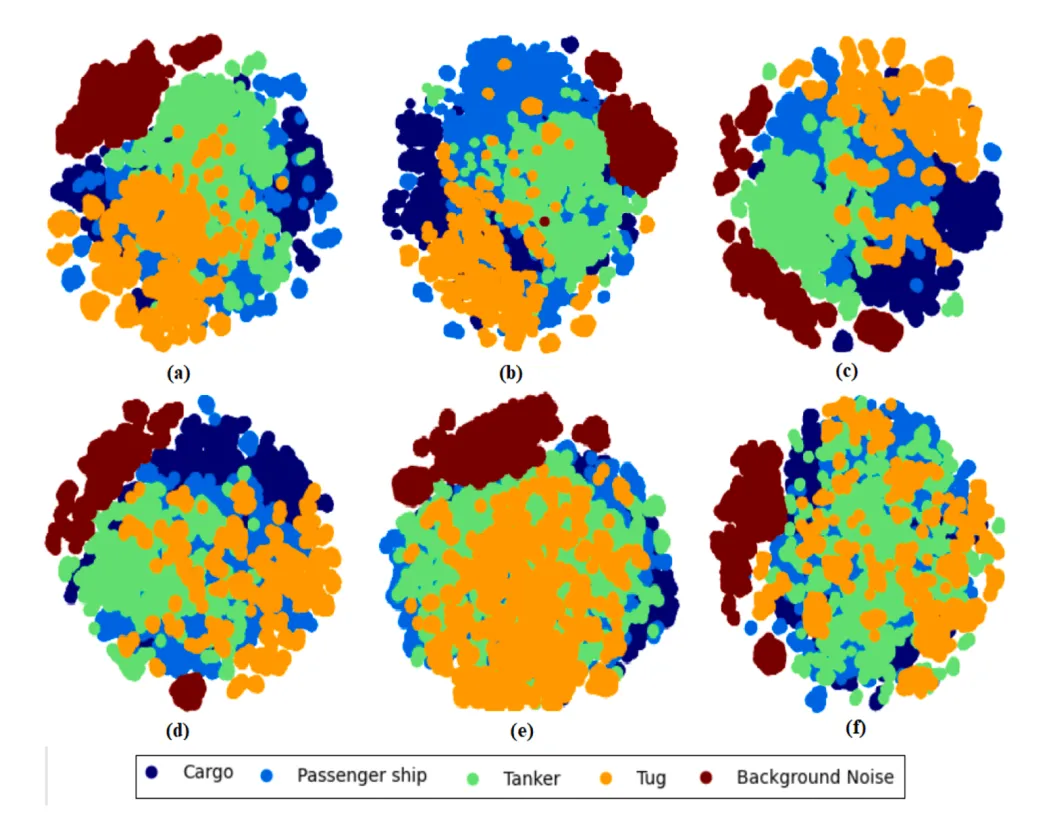
使用t-SNE等数据可视化技术来分析和展示特征在高维空间中的分布,帮助理解不同类别船只声音信号的区分度。
性能评估
通过准确率、精确率、召回率和F1分数等指标来评估分类模型的性能。
统计测试
使用配对样本统计t-检验来分析分类结果的显著性,确保分类方法的有效性。
