
 语音小管家
来源丨学术头条
今天,在 CNCC2024 大会上,智谱也推出了他们在多模态领域的最新成果——端到端语音模型 GLM-4-Voice,让人和机器的交流能够以自然聊天的状态进行。
据介绍,GLM-4-Voice 能够直接理解和生成中英文语音,进行实时语音对话,在情绪感知、情感共鸣、情绪表达、多语言、多方言等方面实现突破,且延时更低,可随时打断。
整体而言,GLM-4-Voice 具备以下优势和特点:
情感表达和情感共鸣:模拟不同的情感和语调,如高兴、悲伤、生气、害怕等情绪,用合适的情绪语气进行回复。传统 TTS 通常在情感表达上比较僵硬,声音缺少起伏和细腻的变化。
调节语速:在同一轮对话中,可以要求 TA 快点说 or 慢点说。
随时打断,灵活输入指令:根据实时的用户指令,调整语音输出的内容、风格和情感,支持更灵活的对话互动。例如,你可以随时打断 TA,让 TA 输出新的内容,更加符合日常对话情境。
多语言、多方言支持:目前 GLM-4-Voice 尤其擅长北京话、重庆话和粤语。
结合视频通话,能看也能说:即将上线视频通话功能,打造真正能看又能说的语音助理。
代码仓库:
与传统的 ASR + LLM + TTS 的级联方案相比,端到端模型以音频 token 的形式直接建模语音,在一个模型里面同时完成语音的理解和生成,避免了级联方案“语音转文字再转语音” 的中间过程中带来的信息损失,也解锁了更高的能力上限。
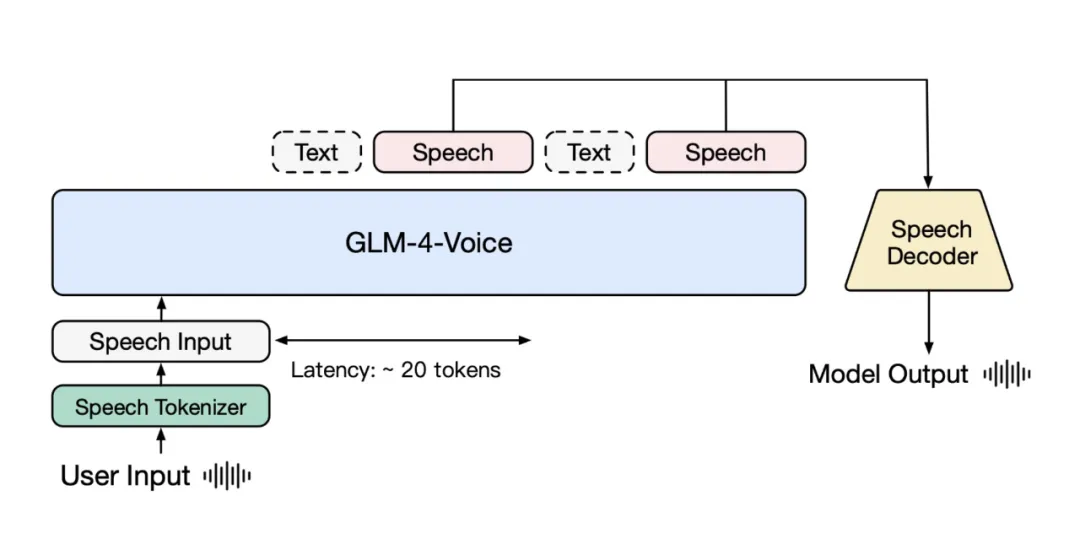
图|GLM-4-Voice 模型架构图
GLM-4-Voice 由三个部分组成:
GLM-4-Voice-Tokenizer: 通过在 Whisper 的 Encoder 部分增加 Vector Quantization 训练,通过在 ASR 数据上有监督训练的方式得到,将连续的语音输入转化为离散的 token,每秒音频转化为 12.5 个离散 token。
GLM-4-Voice-9B: 在 GLM-4-9B 的基础上进行语音模态的预训练和对齐,从而能够理解和生成离散化的语音。
GLM-4-Voice-Decoder: 基于 CosyVoice 的 Flow Matching 模型结构训练的支持流式推理的语音解码器,将离散化的语音 token 转化为连续的语音输出。最少只需要 10 个音频 token 即可开始生成,降低端到端对话延迟。
Speech2Text:从文本数据中,随机选取文本句子转换为音频 token
Text2Speech:从音频数据中,随机选取音频句子加入文本 transcription
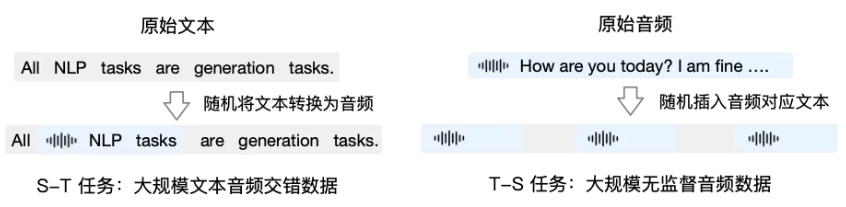
图|GLM-4-Voice 预训练数据构造
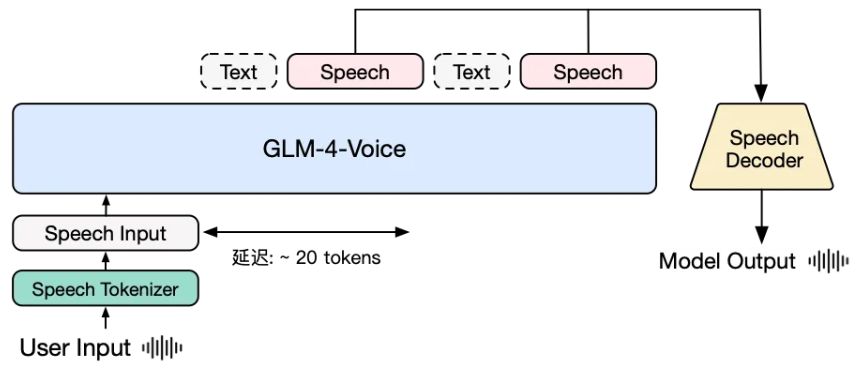
图|GLM-4-Voice 模型架构图
