语音小管家
论文标题:ProSide: Knowledge Projector and Sideway for Pre-trained Language Models
论文作者:何朝帆,卢葛威,申丽萍
论文链接:https://link.springer.com/chapter/10.1007/978-981-97-9434-8_5
论文简介:
任务定义与挑战
具体来说,当前研究可以分为以下几类:
将知识图谱融入到模型训练目标,类似于ERNIE、KEPLER这类模型,在预训练或微调过程中,将知识图谱三元组对齐到文本,并设计预训练任务,以提高模型性能。这类方法缺点是训练消耗大,效率低。
将知识图谱以prompt方式放在模型输入中,类似于RAG,效率较高,但是难以获取全局或结构性的知识图谱信息。
以外部模块形式注入模型,代表性的K-Adapter使用知识预训练的模块,注入到语言模型中。
ProSide模型包括两个主要模块:知识映射(Knowledge Projector)和知识旁路(Knowledge Sideway)。
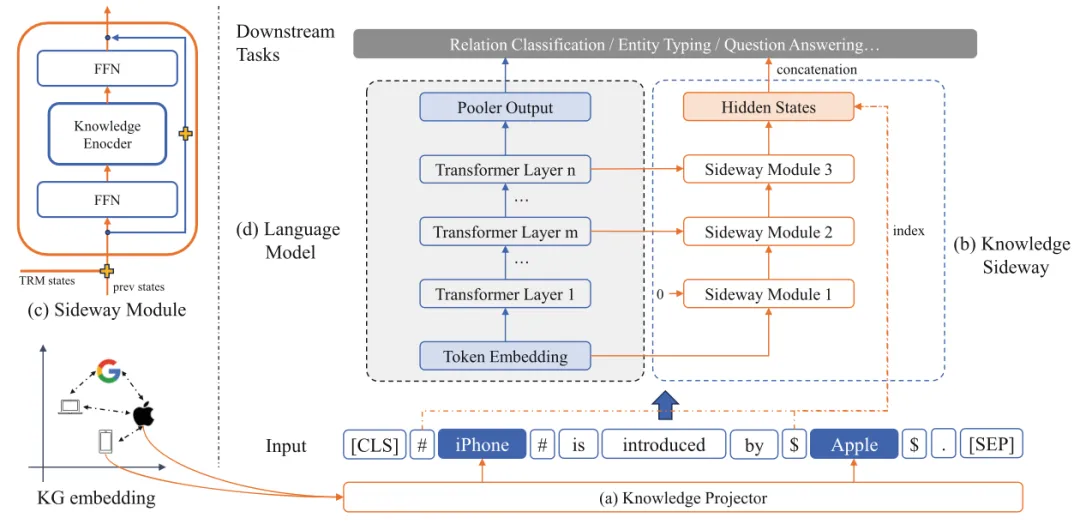
知识映射负责将知识图谱中的实体嵌入从知识空间转换到语义空间,而知识旁路则在预训练过程中保留完整的知识图谱信息。ProSide模型能够适应不同的语言模型,从而无需重新训练,即可提高在下游任务上的性能。
预训练过程
ProSide模型的预训练过程涉及使用Wikidata20M和T-REx作为知识库,超过30M个三元组语料,以及BERT作为基础模型(但BERT本身参数冻结)。预训练的目标是编码一般知识图谱信息,以便于在下游任务中更准确地识别实体。
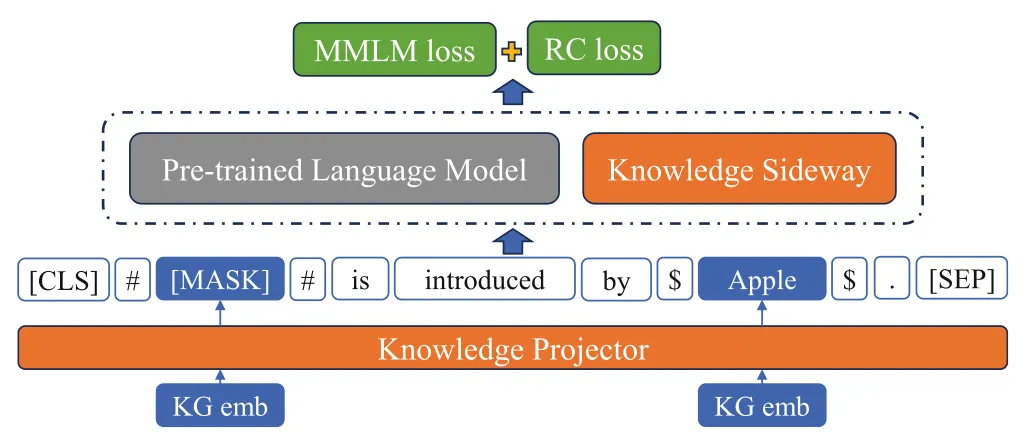
MMLM损失,将文本中的实体掩盖并预测; RC损失,预测文本中描述的实体关系。
二者结合用于优化ProSide模块。
作用机制
ProSide模型的作用机制在于它如何有效地利用输入序列中的实体信息,同时在模型由浅到深层保留实体间的信息。为了分析模型的表示空间与作用机制,我们计算1000个实例文本中实体的相对关系(通过知识逆映射后)与其在知识图谱中真实的关系的相似度,发现ProSide模型能够在语言模型架构作用后,有效地保留原始知识图谱嵌入空间中的实体-关系信息。
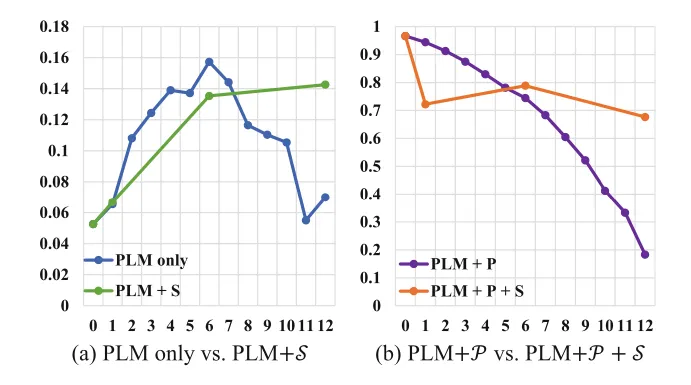
通过对比语言模型本身和多个消融模型的结果(上图横轴为模型层数由浅到深,纵轴为关系相似度,绿线为PLM本身,黄线为使用ProSide的模型,紫线为PLM+映射模块),PLM+知识映射(紫线)的模型在实体关系一致性上逐层降低,而ProSide模型在模型输出层上维持了这一关系,解释了其有效性。
实验与结果
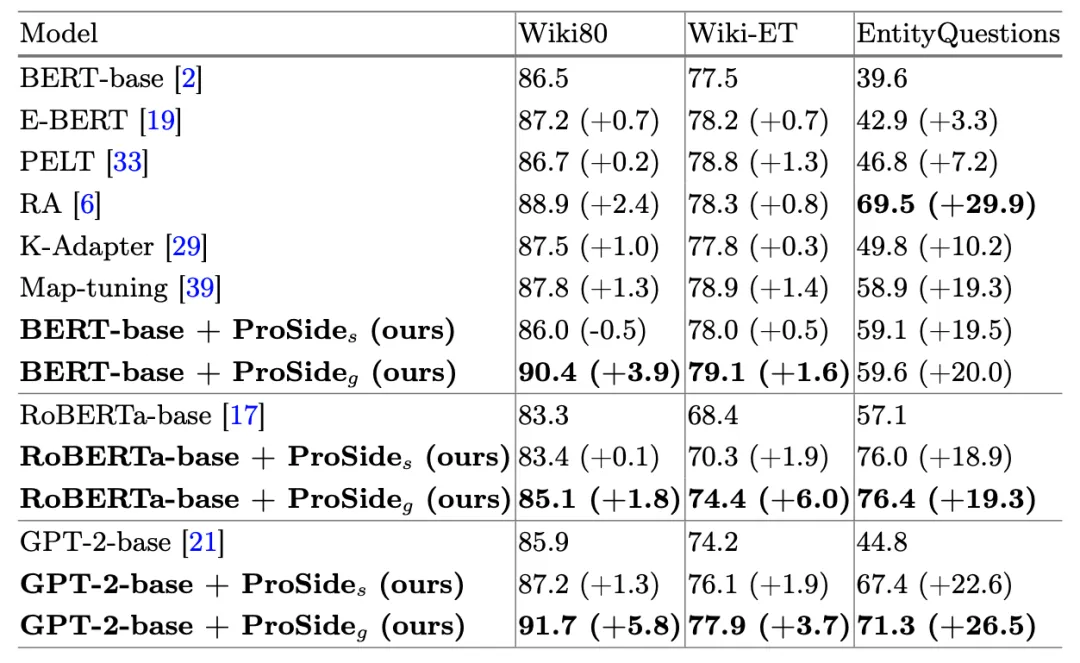
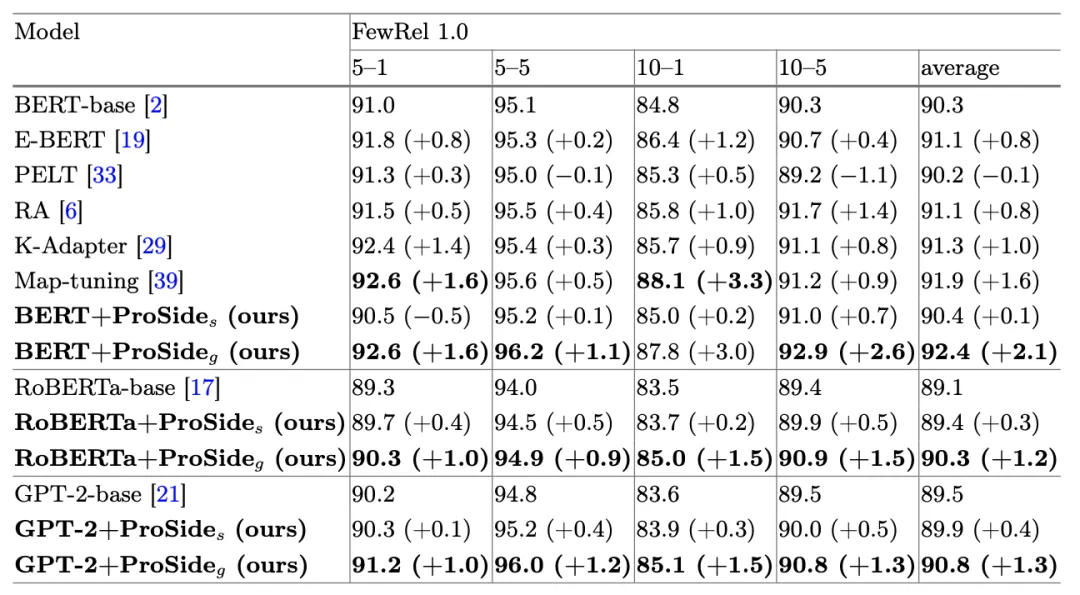
我们在多个基准、不同模型、多个设定上测试了我们的模块,包括多个知识驱动的下游任务、使用不同训练方式的ProSide、增强在不同模型上以及fewshot/zeroshot设定。对比baseline和多个以前的模型,我们在多个测试集上达到最好的效果。