论文标题:Unsupervised Speech Enhancement Using Optimal Transport and Speech Presence Probability
论文作者:江文斌,俞凯,文飞
论文单位:杭州电子科技大学,上海交通大学
作者邮箱:wbjiang@hdu.edu.cn; kai.yu@sjtu.edu.cn; wenfei@sjtu.edu.cn
论文链接:https://ieeexplore.ieee.org/document/10704610
Demo链接:https://jiang-wenbin.github.io/UnSE-SPP/
论文亮点
UnSE+是一种用于语音增强领域的无监督学习方法,这种方法无需配对的带噪-干净语音训练数据,且能够达到媲美或优于有监督学习方法的效果。
UnSE+作为UnSE的改进版本,同样基于最优传输准则以训练模型,并进一步将语音存在概率(SSP)作为优化对象之一,提高了训练过程中的稳定性。
UnSE+使用短时傅里叶变换(STFT)域损失函数作为无监督训练损失函数的附加组成部分,并利用多尺度短时傅里叶变换(MS-STFT)损失函数作为验证损失函数,进一步提高了模型的性能。
语音增强(SE)旨在抑制观察到的带噪语音中的干扰噪声,以提高语音信号的感知质量和可懂度,广泛应用于降低语音识别系统的错误率,滤除听力辅助设备的电流声,以及电子通信领域等。而在实际应用场景中,大量的配对带噪-干净语音训练集往往难以获取,限制了有监督学习方法的可行度。受此激发,杭州电子科技大学、上海交通大学的研究者们提出了一种无监督学习方法UnSE+。该方法无需配对的带噪-干净语音训练集,而是基于最优传输理论,将语音增强构建为无监督学习问题,采用对抗训练的方法训练模型。尤其地,通过向优化对象中引入传统SE方法中常出现的语音存在概率,降低了该架构下训练过程中的不稳定性。使用该方法在非配对语音数据上训练出的模型,与有监督学习方法所训练的相应模型对比时,能够在VCTK+DEMAN和CHiME4数据集上表现出相当或更优的性能。此外,通过可视化带噪、干净和去噪语音数据的分布,研究者证明了该方法下使用非配对训练数据集训练出的模型,能够成功将输入带噪语音的分布转化成干净语音的分布,为无监督学习在语音增强领域的应用提供了新的思路。
在现实世界中,语音信号往往遭受加性噪声的破坏而难以识别出有效信息,语音增强(SE)技术的作用便在于提高语音信息的传输质量,确保人机交互、人与人交流的准确高效进行。装载语音识别(ASR)、语音情感识别(SER)等其他下游语音技术的各种智能语音系统,都需要集成语音增强技术作为预处理程序,以滤除系统输入带噪语音信号中的环境噪声、背景人声、电流声等噪声,同时最大限度地保留原始语音信息,降低有效信息的遗失。近年,基于DNN的SE模型在性能上显著超越了传统方法,成为了该技术领域的研究主流方向。我们所提出的UnSE+是一种训练SE模型的无监督学习方法,它利用非配对训练数据集以训练模型。
一般来说,基于 DNN 的语音增强模型是在有监督条件下进行训练的,其中包括使用配对的带噪语音和干净语音,带噪语音作为输入,而真实干净语音作为预期输出。而为了提高其在真实世界数据上的泛化能力,研究人员通常会使用数百或数千小时的合成带噪-干净语音训练数据来训练模型。然而,合成的噪声语音可能只能准确代表现实世界中的某些环境,当训练数据与真实世界测试数据之间存在领域不匹配时,会导致 SE 模型的性能大幅下降。此外,在特定的实际应用场景中,获取配对的噪声语音和绝对真实的干净语音通常具有挑战性或几乎不切实际。因此,如何在没有大量配对的带噪-干净语音训练集的情况下,通过半监督或无监督的方法,训练出适用于特定真实场景的SE模型,是该技术领域的一个关键难题。为了减少训练数据与真实世界测试数据之间领域的不匹配,一些研究采用了基于传统统计信号处理的方法。参考文献[1]中,研究者提出了一种师生框架,即使用预先训练好的模型作为教师来估计理想比率掩码(IRMs),并训练学生模型来估计改进的语音存在概率,并通过实验证明,该方法可以在不调整声学模型的情况下有效提高语音识别性能,尤其是在真实世界的测试集上。然而,该方法的教师模型需要配对的带噪-干净数据来训练。为了解决对配对训练数据集的依赖问题,我们在之前的工作中提出了UnSE[2],一种不需要配对训练数据集的无监督语音增强方法。该方法基于最优传输理论,约束条件为去噪语音的分布应与干净语音的分布保持一致,将去噪学习问题构建为无监督学习问题,并通过对抗训练优化无监督损失函数和对抗损失函数来实现算法。然而,该方法高度依赖两损失间的平衡,训练过程非常微妙且不稳定。为了提高UnSE训练过程的稳定性,我们提出了UnSE的改进版本——UnSE+。通过采用传统语音增强方法估算的语音存在概率作为优化目标,使训练过程更加稳定。并通过训练结合STFT域损失函数、验证使用MS-STFT损失函数从而提高模型性能。研究方法
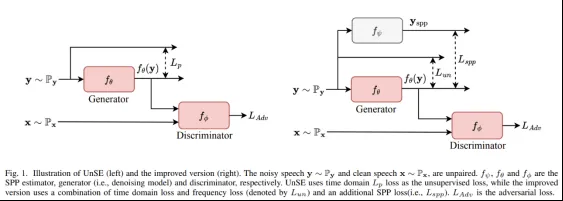
图1 总体框架:UnSE(左);UnSE+(右)
我们提出的UnSE+方法是一种无监督训练方法,其总体框架如图1右所示,其关键部分为最优传输准则、语音存在概率优化和STFT域的损失函数。带噪语音y和干净语音x分别从带噪语音分布Py和干净语音分布Px中随机抽样。需要注意的是,x和y是互相独立的,即它们是非配对的训练数据。fθ表示去噪模型(即生成器),fφ表示判别器。fψ表示语音存在概率预估器,其输出表示为yssp。该方法采用生成对抗网络(GAN)结构。对于生成器(Generator),我们利用带有跳转连接的U-Net架构来构建去噪模型,由于训练GAN可能是一个非常耗时的过程,如图2(a)所示,我们采用一种更高效的网络结构,其源自于卷积递归神经网络(CRN)与双路递归神经网络(DPRNN),我们称其为卷积双路递归神经网络(CDPRN)。对于判别器(Discriminator),则采用如图2(b)所示网络结构。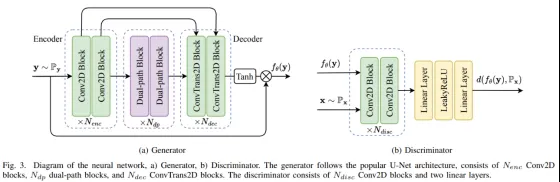
图2 (a)生成器:卷积双路径递归网络(CDPRN);(b)判别器
一、最优传输准则
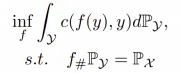
最优传输问题如图3所示,让 Y 和 X 表示两个完整的度量空间,PY 和 PX 分别表示 Y 和 X 上的概率分布,c表示代价函数。最优传输的目的在于找到从 PY 到 PX 的最有效运输方式f,使得代价函数的总代价最小。
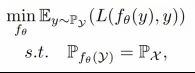
由此,无监督学习下的语音增强问题可以构建有约束的优化问题(如图4所示),约束条件为去噪语音的分布应与干净语音的分布保持一致,该约束避免了模型退化为一个恒等函数。为了便于实现,我们将问题进一步放宽为无约束的优化问题(如图5所示)。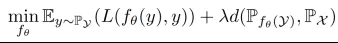
在我们之前的工作UnSE中,生成器损失函数如图6所示。其中,无监督损失函数Lp的目的在于保留输入语音数据中的有效语音信息,对抗损失函数LAdv的目的则在于避免模型退化为一个恒等函数。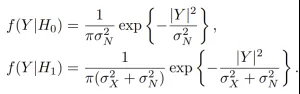
然而,在训练过程中UnSE存在明显的不稳定问题,体现在对无监督损失函数与对抗损失函数之间平衡的高度依赖。在UnSE+中,为了提高模型训练的稳定性,我们引入了语音存在概率作为优化对象。
二、语音存在概率
在如OM-LSA[3]等传统SE方法中,语音存在概率(SSP)往往充当着重要角色。语音存在概率是指在给定的观测数据中,语音信号存在的概率。这一概念在传统的语音增强方法中扮演着重要角色,并且被集成到所提出的无监督学习方法中,以提高模型训练的稳定性和性能。在短时傅里叶变换(Short-Time Fourier Transform, STFT)域中,语音存在概率p定义为:在给定的噪声观测Y的条件下,语音存在概率。通过贝叶斯方法,可以计算出语音存在概率p: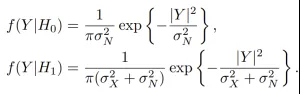
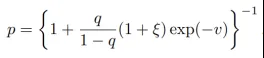
STFT域损失(STFT domain loss)和多分辨率STFT损失(multi-resolution STFT loss, MS-STFT loss)是作为无监督训练损失(unsupervised training loss)和验证损失(validation loss)的关键组成部分,用于提高模型性能。STFT域损失是在无监督学习中引入的,作为一个额外的损失项,它有助于最小化模型输出与未配对干净语音之间的分布差异。具体来说,STFT域损失关注于模型输出的频谱与干净语音频谱之间的一致性,通过优化这个损失项,模型可以更好地学习如何从噪声语音中恢复出干净的语音信号。MS-STFT损失则作为验证损失使用,它通过在不同分辨率下测量语音失真来增强训练过程的稳定性,并提高算法的性能。我们之前的研究发现,采用多尺度STFT (MS-STFT)损失可以获得更优的性能[4]。MS-STFT损失利用了不同FFT尺寸下的STFT表示,通过结合不同尺度的频域信息,提供了一种更为全面的评估模型性能的方式。这种方法尤其适用于处理真实世界数据,因为它可以有效地捕捉到不同尺度下的语音特征,从而提高语音增强的质量。通过结合STFT域损失和MS-STFT损失,我们提出的无监督语音增强方法能够在没有成对噪声和干净语音数据的情况下,有效地训练出能够从噪声语音中恢复出干净语音的模型。这种方法在VCTK + DEMAND基准测试中显示出与监督学习方法相当的性能,并且在CHiME4基准测试中的语音识别结果也显示出其优越性。这些结果证明了STFT域损失和MS-STFT损失在提高无监督语音增强模型性能方面的有效性。
本文提出的语音增强方法在不同的数据集上均表现出良好的性能。在基准数据集(VCTK + DEMAND)上,在多个评价指标上与监督学习方法表现相当,甚至在某些情况下优于现有的无监督方法。在不同的信噪比(SNR)条件下,所提出的方法在低信噪比下表现尤为出色。表1 不同方法在VCTK + DEMAND数据集上的语音增强结果对比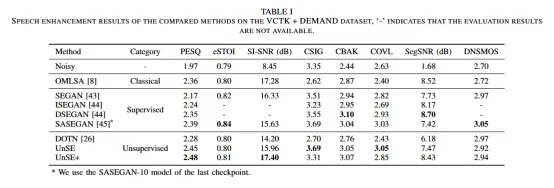
表1的结果显示,无监督学习方法、基于GAN的监督学习方法以及传统方法的表现大致相当。SEGAN在eSTOI和CSIG指标上超过了OMLSA,但在PESQ和SI-SNR上略逊一筹。改进版的SEGAN(ISEGAN、DSEGAN、SASEGAN)在PESQ上优于OMLSA,但SI-SNR表现一般。DOTN在CSIG上超过OMLSA,但在其他两个指标上表现不佳。提出的无监督方法在多数指标上优于DOTN,并取得了最高的PESQ评分。因此,该研究中的无监督学习语音增强方法优于DOTN,且可以媲美常用的监督学习方法。另外,UnSE+在PESQ和SI-SNR上的表现优于UnSE。不过,与当前最佳的监督学习语音增强技术(如CMGAN、NHS-SE、D2Former等)相比,该无监督方法还有提升空间。在CHiME4数据集上进行了语音增强和ASR实验。在语音增强实验中,我们在CHiME4数据集上使用CDPRN神经网络架构作为去噪模型进行了实验,保证了比较的公平性。模型间的差异仅来自于不同的训练方法和训练数据。表2展示了去噪后语音在验证集和测试集上的DNSMOS结果。对于“真实”数据,由于没有对应的干净语音作为基准,我们使用近距离谈话的录音(即通道0)作为伪干净语音来训练模型。在测试阶段,由于缺乏干净语音基准,我们只能使用DNSMOS这样的无参考评价指标。
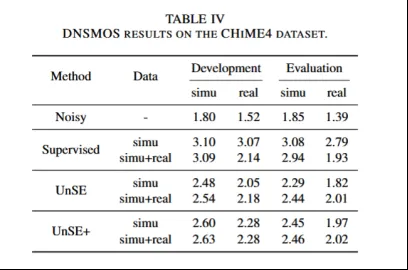
从表2的结果可以看出:当仅使用模拟数据时,监督方法能得到最高的DNSMOS分数;添加额外的“真实”数据后,监督方法的性能显著下降;在使用额外“真实”数据的情况下,提出的无监督方法优于监督方法。在语音识别实验中,我们使用之前训练的语音增强(SE)模型作为前端降噪模型,并采用Whisper系列的三种模型(即small、medium、large)作为语音识别(ASR)模型。表3 使用Whisper在CHiME4数据集上的WERs(%)结果
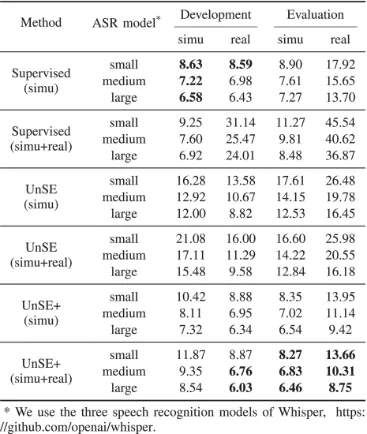
表3展示了CHiME4数据集上的ASR实验结果。“supervised(simu)”表示使用配对的模拟数据通过监督学习训练的SE模型,“UnSE(simu+real)”是指使用包含模拟数据和额外“真实”数据的无监督SE方法训练的模型。结果表明:使用配对模拟数据通过监督学习训练的前端降噪模型,ASR模型在开发集“simu”子集上实现了最低的词错误率(WER);然而,加入额外的“真实”数据后,监督SE方法导致ASR性能显著下降,特别是在“真实”数据上的表现;相反,提出的无监督学习方法有效提升了ASR性能,尤其是在处理“真实”数据时。因此,可以得出结论:1) 提出的SE方法能够有效地利用“真实”数据,从而缓解了训练数据和测试数据分布差异导致的模型性能下降问题;2) 对于语音识别而言,特别是在处理真实世界的数据时,提出的无监督语音增强方法优于监督方法。
本文提出了一种无监督学习的语音增强方法,该方法不需要配对的带噪和干净语音训练数据。该方法基于最优传输理论,使用基于带噪语音的保真度损失和分布散度损失来训练SE模型,以最小化模型输出与非配对的干净语音之间的差异。为了提高训练过程的稳定性和去噪模型的性能,使用语音存在概率和STFT域损失作为无监督训练损失的附加约束,使用MS-STFT损失作为验证损失。在广泛使用的基准数据集(VCTK + DEMAND)上的实验结果表明,与有监督学习方法相比,提出的无监督学习方法取得了具有竞争力的性能。此外,在CHiME4基准上的语音识别结果一致显示了所提出的无监督方法相对于有监督方法的优越性。
参考文献
[1]. Y.-H. Tu, J. Du, and C.-H. Lee, “Dnn training based on classic gain function for single-channel speech enhancement and recognition,” in Proc. IEEE ICASSP. Brighton, United Kingdom: IEEE, May 2019, pp. 910–914.
[2]. W. Jiang, F. Wen, Y. Zhang et al., “Unse: Unsupervised speech enhancement using optimal transport,” in Proc. ISCA Interspeech. ISCA, Aug. 2023, pp. 4029–4033.
[3]. I. Cohen and B. Berdugo, “Speech enhancement for non-stationary noise environments,” Signal processing, vol. 81, no. 11, pp. 2403–2418, 2001.
[4]. W. Jiang, Z. Liu, K. Yu et al., “Speech enhancement with neural homomorphic synthesis,” in Proc. IEEE ICASSP. IEEE, 2022, pp. 376–380.

 语音小管家
