语音增强(Speech Enhancement)任务的目标是改善在复杂声学环境中捕获的自然语音信号,滤除噪音,提取出纯净的目标语音,有效提升语音的可听性和可理解性,同时也为下游语音任务提供经过高效降噪处理的、音质清晰的音频结果。
Deep Noise Suppression Challenge是由微软组织的一项国际性技术竞赛,旨在推动语音增强领域的研究与发展,一直备受学术界和工业界的关注。该挑战赛聚焦于利用深度学习技术来抑制背景噪声,提升语音信号的质量和可懂度,特别是在实时通信、语音识别等应用场景中。比赛的核心任务是开发高效的深度学习模型,从带噪语音中提取清晰的语音信号,同时确保语音的自然度和保真度。通过这一挑战赛,研究者们探索了多种创新方法,如基于Transformer、卷积神经网络(CNN)和递归神经网络(RNN)的模型架构,同时也推动了开源工具和数据集的发展,为语音处理领域提供了重要的技术参考和解决方案。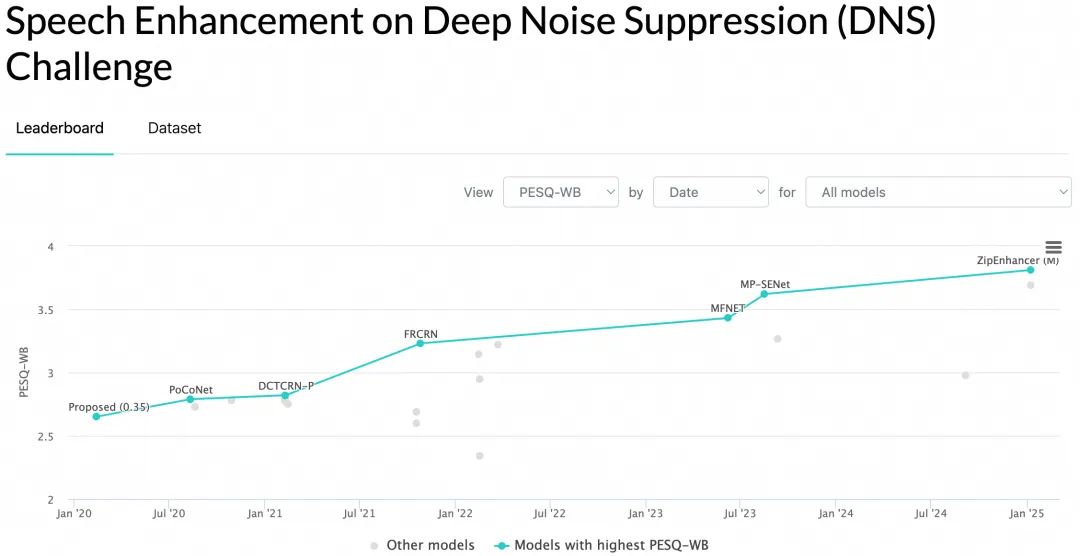
当前的语音降噪方法通常分为两类:时域语音增强和时频域语音增强。时域方法利用神经网络提取语音特征,时频域方法利用短时傅里叶变换(short-time Fourier transform,STFT)提取STFT特征,并都使用各种神经网络进行隐层特征建模。为了在低信噪比(signal-to-noise ratio,SNR)情况下增强音频质量,一些时频域方法引入相位信息并在语音增强任务中取得了良好的结果。与传统的语音序列任务构造具有三个轴的隐层特征(B,T,C)不同,语音增强多使用双路建模(Dual-Path Modeling)结构保留了额外的频率维度,构建了具有四个轴的隐藏特征(B,T,F,C),并在时间T和频率F维度上使用Transformer式的双路建模。尽管语音增强模型的参数数量只有数百万(M),远小于语音识别ASR等常规语音任务的模型,但由于双路建模,它们的计算成本仍然很高。模型的参数数量并不能完全反映其建模能力。近期,阿里巴巴通义实验室论文“ZipEnhancer: Dual-Path Down-Up Sampling-based Zipformer for Monaural Speech Enhancement”被ICASSP 2025接收。该论文是通义实验室在语音增强方向的最新成果,是对“如何高效进行双路建模语音增强”这一问题的研究探索,在DNS数据集上取得SOTA性能的同时,也可以设计性能效率平衡的模型。
论文题目:ZipEnhancer: Dual-Path Down-Up Sampling-based Zipformer for Monaural Speech Enhancement预处理音频:https://zipenhancer.github.io/ZipEnhancer/
样例:https://modelscope.cn/models/iic/speech_zipenhancer_ans_multiloss_16k_base
开发者可以通过ModelScope框架的API调用进行批量处理。
from modelscope.pipelines import pipeline
from modelscope.utils.constant import Tasks


ans = pipeline(
    Tasks.acoustic_noise_suppression,
    model='damo/speech_zipenhancer_ans_multiloss_16k_base')
result = ans(
'https://modelscope.oss-cn-beijing.aliyuncs.com/test/audios/speech_with_noise1.wav',
    output_path='output.wav')
print("done")
核心模型
在本论文中,我们提出了新的语音增强模型ZipEnhancer,一种时频域的语音增强模型。其将时域下采样引入语音增强模型,并将其扩展到频域下采样,以降低计算成本,包含了在双路不同模块层中设计不同比例的时域和频域特征的下采样模块。该模型包括一个编码器(Encoder)、双路ZipformerBlocks(Dual-Path ZipformerBlocks)和解码器(Decoder)。编码器最初对幅度(Magnitude)和相位(Phase)进行建模以获得隐藏层特征。随后,双路ZipformerBlocks使用下采样堆栈依次对时域和频域进行建模,然后是幅度解码器恢复幅度频谱和相位解码器显式地恢复相位频谱。
与MP-SENet[1,2]中的TF-Conformers或TF-GRUTransformers相比,我们使用Zipformer修改了双路模块为FT-ZipformerBlocks。此外,我们提出了DownSampleStacks,其中包括配对的下采样和上采样结构,在时间和频率域中进行对称的缩放,以降低计算成本,并在不同的分辨率级别上建模时域和频域信息。此外,我们引入了ScaleAdam优化器和Eden调度器以进一步提高性能。
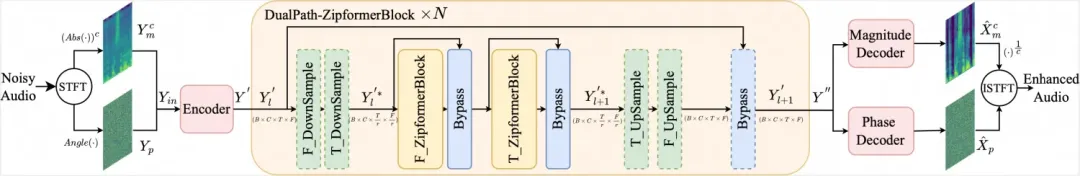
图示1:ZipEnhancer的整体架构
ZipEnhancer的整体架构图示1显示了我们模型的总体架构。我们使用具有编解码器结构的 ZipEnhancer 模型,从嘈杂语音信号 (Noisy Audio)中估计出干净信号。首先从嘈杂信号中提取时频域的幅度谱和包络相位谱,然后对幅度谱进行幂律压缩,并将其与相位谱沿着新的通道维度连接,得到编码器的输入特征。编码器进行处理后得到隐藏层的时频特征Y'
。堆叠的双路 ZipformerBlocks 交替对频域和时域进行顺序建模,捕获全局和局部的声学信息。下采样块在降低模型计算成本的同时有助于聚合和恢复原始长度信息。通过DualPath-ZipformerBlocks后获得解码所需的新的隐藏层特征Y''。并行的幅度谱解码器和相位谱解码器估计干净幅度谱和相位谱。然后使用逆短时傅里叶变换(ISTFT)重构出估计的增强波形(Enhanced Audio)。
双路压缩编码器(DualPathZipformerBlocks)
下采样模块
交替建模的时频双路结构可以设计包括同时在时间和频率维度进行下采样的模块。如图示1所示的浅绿色模块,在DownSampleStack中,我们使用配对的DownSample和UpSample模块来实现在时间或频率长度上的对称缩放。T/F_DownSample/UpSample分别标记在时间/频率维度进行下/上采样的模块。通过这种下采样过程,该层的原始特征压缩到(B,C,T/r,F/r),然后输入到双路 Zipformerblock 中,以更低的帧率对时域和频率域进行建模。此外,一个旁路模块(Bypass),类似于残差连接,可以短接未经下采样的信息,以增强模型的建模能力。另外,图示1中的虚线下采样结构是可选的,并且当无需下采样时将会被删除。
ZipformerBlock压缩编码器模块
在双路结构中,F_ZipformerBlock和T_ZipformerBlock共享相同的模型架构。对于该层特征,我们先将其输入到F_ZipformerBlock中以建模频率域相关性。然后,交换时域和频域维度,并将其输入到T_ZipformerBlock中以建模时间域相关性。我们将原来应用于语音识别任务的ZipformerBlock[3]引入并适配到语音增强任务当中。ZipformerBlock相比ConformerBlock包含了各种改进。ZipformerBlock将LayerNorm替换为BiasNorm,并对MHSA、FFN的具体结构和数量进行了微调(具体可见论文)。
编码器与解码器
我们使用与MP-SENet相似的编码器和解码器。编码器主要融合建模原始的幅度和相位信息,并对特征维度进行了一个初步下采样。解码器包括幅度解码器和相位解码器。幅度解码器直接映射预测的压缩干净幅度谱。相位解码器预测增强后的相位谱。
优化器、调度器、损失函数设置
我们使用ScaleAdam,这是Adam的一个参数尺度不变版本,可以实现更快的收敛速度和改进的性能。另外我们使用Eden作为我们的学习率(Learning Rate,LR)调度器。用于训练ZipEnhancer的损失函数是各种损失的线性组合,包括基于PESQ的GAN鉴别器,STFT一致性,幅度,复数、相位和时间损失。最终的损失定义如下:
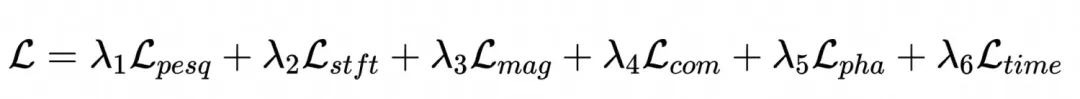
实验结果
我们在常用的语音增强公开数据集 DNS Challenge 2020 (DNS2020) 和 VoiceBank+DEMAND 上验证了ZipEnhancer的有效性。实验指标WB-PESQ, NB-PESQ, STOI, SI-SDR, SSNR, CSIG, CBAK, COVL进行评估,所有的指标均为越高性能越好。
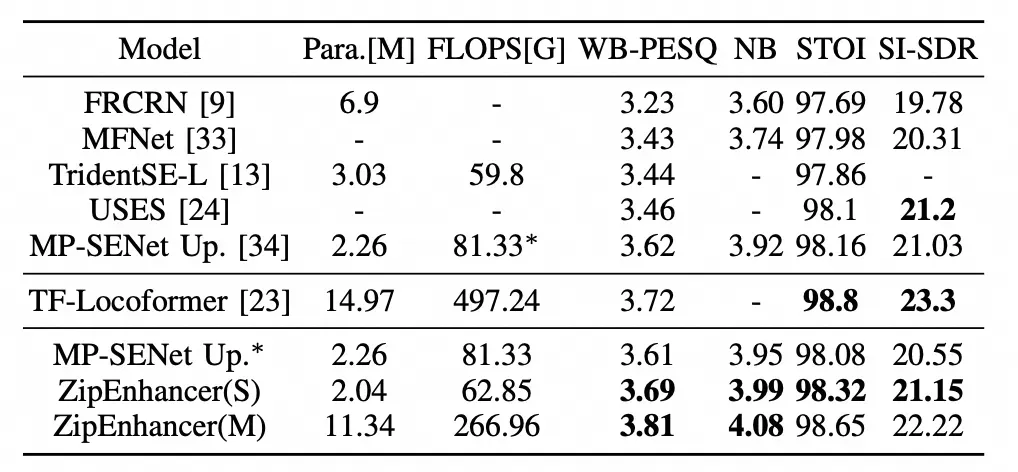
表1 与DNS2020测试集上的其他方法进行比较
表1展示了在DNS2020测试集上进行评估的结果。ZipEnhancer(S)在几个指标上优于最近的最先进模型。模型在保持比最近的模型更低的参数量2.04M和更低或相当的62.85G FLOPS的情况下,达到了3.69的PESQ,相比MPSENet更新版提升1.9%。该结果体现了ZipEnhancer的优越性,以及采用的Down-Up采样结构在降低计算成本方面的有效性。此外,ZipEnhancer(M)仅使用一半的FLOPS就达到了与TF-Locoformer相似的性能。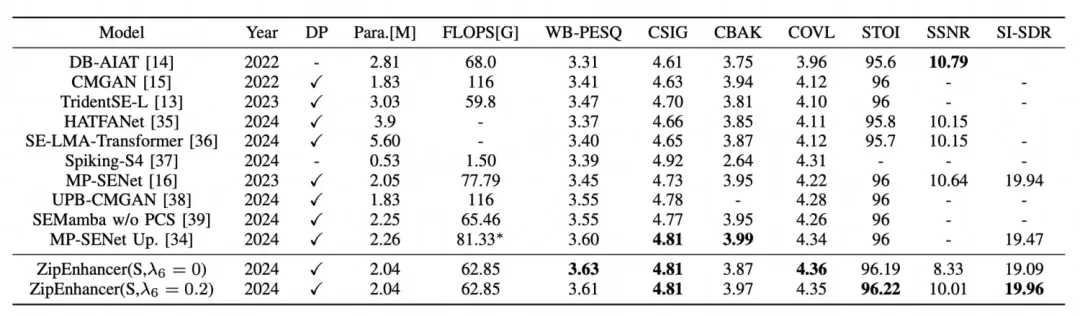
表2 与VoiceBank+DEMAND测试集上的其他方法进行比较
表2展示了在VoiceBank+DEMAND测试集上进行评估的结果。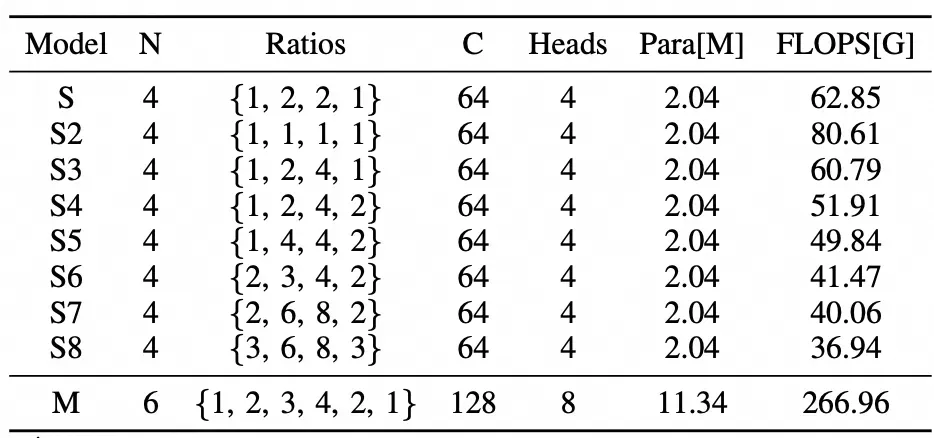
表3 ZipEnhancer不同规模模型的超参数。
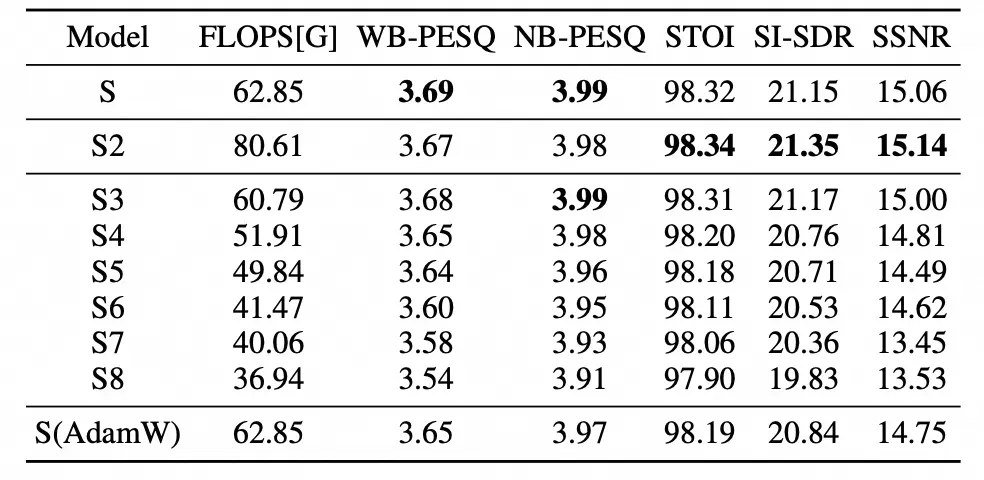
表4 在DNS2020测试集上的消融实验和ZipEnhancer不同规模模型的结果。
在表4中比较了在DNS2020 测试集上不同模型配置和消融实验的结果。表3描述了不同模型配置大小的具体参数信息。S2将所有下采样比率设置为1。S保持高性能,并获得类似于S2的指标,表明高效的下采样模块并不会造成太多信息丢失。
S3-S8使用更激进的下采样比率,得到更低的FLOPS和逐渐降低的性能,但仍保持PESQ在特定阈值以上(3.54,优于之前的USES[4]等模型),表明了在计算成本和性能之间实现折衷的能力。此外,对ScaleAdam进行消融实验,将其替换为AdamW会造成性能略微下降,表明了ScaleAdam的有效性。
与其他仅对隐藏层特征进行三轴建模的序列任务相比,双路时域和时频域语音增强模型虽然有效且参数量小,但由于其隐藏层特征具有四个轴,因此需要较高的计算成本。为了解决这个问题,我们提出了ZipEnhancer,它融合了时域和频域下采样以降低计算开销。
相关文献参考:
[1] Ye-Xin Lu, Yang Ai, and Zhen-Hua Ling, “MP-SENet: A Speech Enhancement Model with Parallel Denoising of Magnitude and Phase Spectra,” in Proc. Interspeech, 2023, pp. 3834–3838.[2] Ye-Xin Lu, Yang Ai, and Zhen-Hua Ling, “Explicit Estimation of Magnitude and Phase Spectra in Parallel for High-Quality Speech Enhancement,” arXiv preprint arXiv:2308.08926, 2024.[3] Zengwei Yao, Liyong Guo, Xiaoyu Yang, Wei Kang, Fangjun Kuang, Yifan Yang, Zengrui Jin, Long Lin, and Daniel Povey, “Zipformer: A faster and better encoder for automatic speech recognition,” in Proc. ICLR. 2024, OpenReview.net.[4] Wangyou Zhang, Kohei Saijo, Zhong-Qiu Wang, Shinji Watanabe, and Yanmin Qian, “Toward Universal Speech Enhancement For Diverse Input Conditions,” in Proc. ASRU, 2023, pp. 1–6.
 语音小管家