
 语音小管家
近期语言模型(LM)在自然语言处理和计算机视觉领域蓬勃发展,可以生成高质量的文本或图像。相比之下,当前的语音生成模型仍然在语音质量和任务多样性之间挣扎。本文提出了Vec-Tok Speech,一个适用于众多下游任务的的可扩展框架,生成富于表现力的高保真语音。
具体来说,本文提出了一种新的基于语音向量(SpeechVectors)和语义单元(SemanticToken)的语音编解码器(Vec-Tok Codec)。语音向量包含有助于高保真语音重建的声学细节,而语义单元关注语音的语言内容,便于语言建模。基于Vec-Tok Codec,Vec-Tok Speech利用语言模型来作为语音生成的核心生成语义单元;并引入字节对编码(BPE)来减少令牌长度和比特率,从而降低曝光偏差(Exposure Bias)获得更长的上下文覆盖,从而提高语言建模的性能。
Vec-Tok Speech可以用于同语种和跨语种的零资源(Zero-shot)语音转换(VC)、零资源风格迁移的文本语音生成(TTS)、语音翻译(S2ST)、语音去噪、去说话人以及匿名化等任务。实验表明,基于5万小时语音训练的Vec-Tok Speech比目前单任务模型具有更好的表现。
论文题目:Vec-Tok Speech : Speechvectorization and tokenization for neural speech generation
作者列表:朱新发,吕元骏,雷怡,李涛,贺雯迪,周鸿斌,卢恒,谢磊
合作单位:喜马拉雅
论文链接:https://ieeexplore.ieee.org/document/10906431
近年来,语言模型发展迅猛,基于语言模型的语音合成[1,2]也取得了巨大成功,在说话人音色克隆等任务上取得明显突破。然而传统的语音编解码器[3,4]采用多层量化(RVQ)的结构,这种设计导致中间表征码不仅率较高,而且包含语言、副语言、非语言信息;增大了下游语言模型的建模难度[5]。
因此,本文主张简化中间表征,即降低码率并简化信息成分。本文提出Vec-Tok Codec,基于语音向量和语义单元的双循环,解耦非语言信息的同时实现高质量语音重构。基于Vec-Tok Codec,Vec-Tok Speech利用语言模型来建模语义单元,并引入字节对编码降低语义单元序列长度、CLVP的排序模型提出输出质量;从而提高语言建模的性能。Vec-Tok Speech可以用于语音转换、合成、翻译、降噪、说话人匿名化等诸多语音生成任务;基于5万小时语音的实验结果表明Vec-Tok Speech比当时单任务模型具有更好的表现。
如图所示,Vec-Tok Speech包含两个部分,一个基于语义表征的编解码器和一个建模语义单元的语言模型。编码器将语音提取为预训练模型的语义向量和词元,语言模型建模字节对编码(BPE)之后的词元序列,解码器将词元序列解码为语义向量和语音波形。
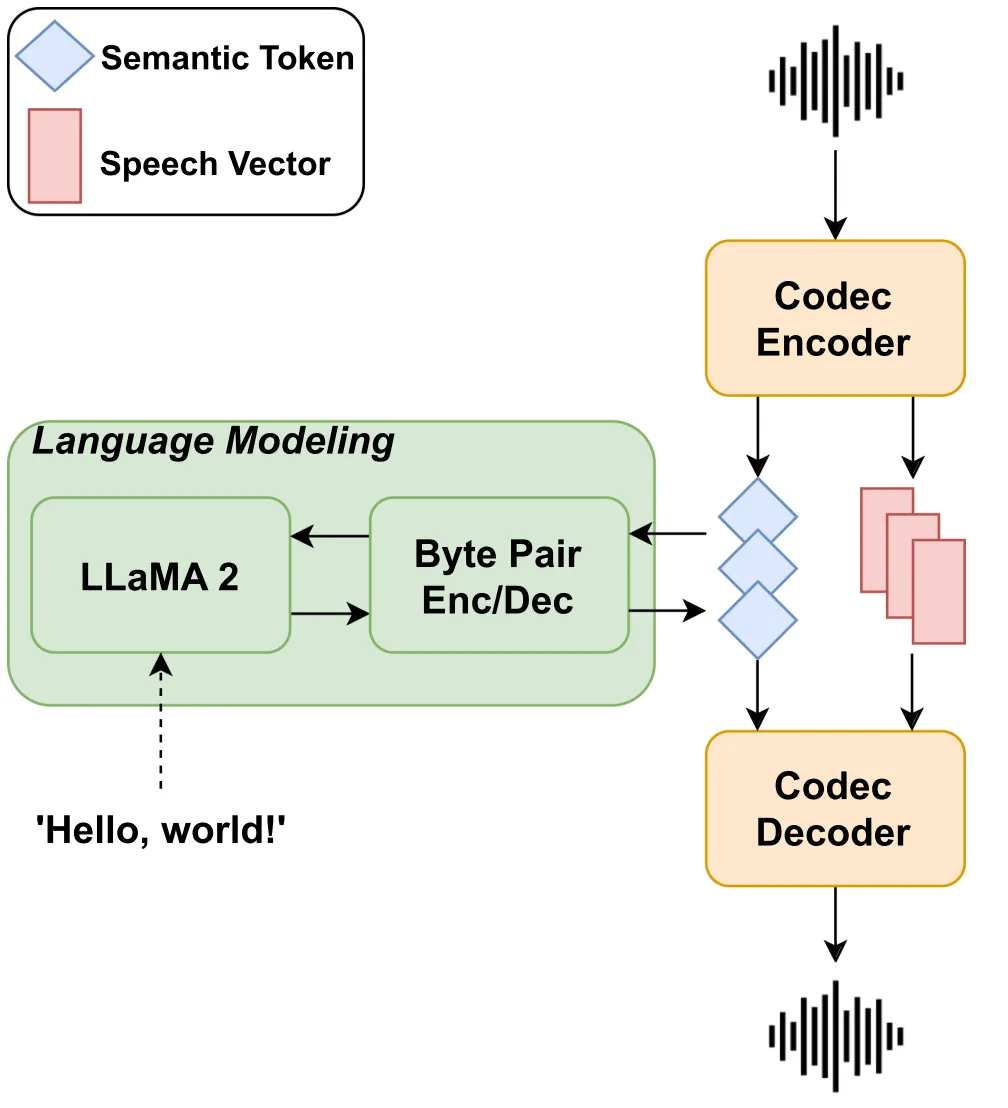
图1 Vec-Tok Speech 整体框架设计
Vec-Tok Codec
如图所示,Vec-Tok Codec有四个步骤,按照编解码顺序分别是:
使用预训练模型,将语音转换为语义向量,该向量含有语音的音色和语义信息
通过将语义向量减去均值,并通过训练后得到的K-means聚类中心,将语义向量转换为词元。减少词元的音色信息,使其尽可能只包含语义信息。
输入词元和参考音频对应的语义向量,通过逆K-means模型向词元中加入音色信息。
使用声码器将语义向量还原为语音波形。
通过Vec-Tok Codec音色和语义解耦的特性,可以做到音色迁移和说话人匿名化。
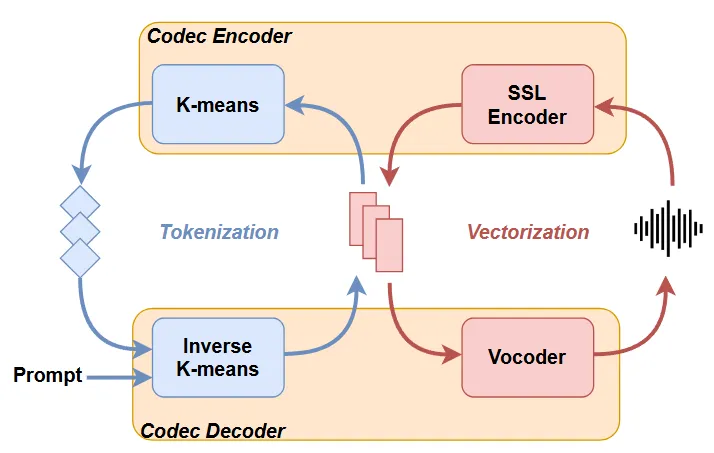
图2 Vec-Tok Codec框架,包含矢量循环和词元循环
Vec-Tok Speech
利用上面的编解码器,就可以利用语言模型对词元序列进行建模。通过对不含音色信息的词元进行语言模型建模,模型可以对参考音频的韵律进行迁移,随后利用Vec-Tok Codec为生成的词元添加音色。通过这个过程,Vec-Tok Speech可以进行韵律与音色解耦的语音合成。
在词元序列的建模过程中,本文发现每秒音频都会产生50个词元,这对训练和推理的速度都产生了影响,本文借鉴了文本模型中的经验,对音频词元进行了字节对编码(Byte Pair Encoding, BPE),本文发现在设定字典大小为8192的情况下,本文可以将词元的频率降低到每秒约16个,这大大降低了模型的训练和推理成本。
基于上述设计,Vec-Tok Speech可应用于语音转换、合成、翻译、降噪、匿名化等诸多语音生成任务。
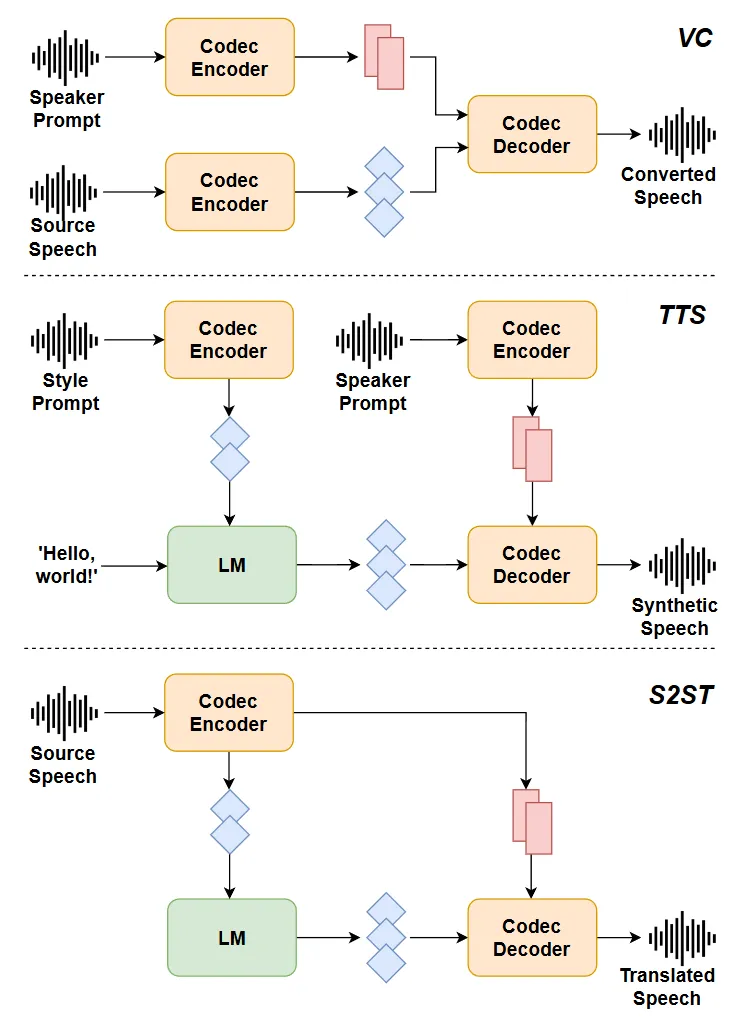
图3 Vec-Tok Speech可应用的下游任务示例
实验数据
本文使用了近五万小时的中英混合数据,包含WenetSpeech、GigaSpeech、LibriTTS、GigaST、GigaS2S等开源数据和两万小时的中文有声书数据。
说话人信息
本文对比了句子表征均值的说话人表征的T-SNE可视化和聚类后词元对应的表征均值的说话人表征的T-SNE可视化信息,发现表征的均值会按照说话人进行聚类,而聚类后词元对应的表征均值不会按照说话人进行聚类。这说明将句子表征减去说话人并聚类的策略能够有效去除说话人信息。
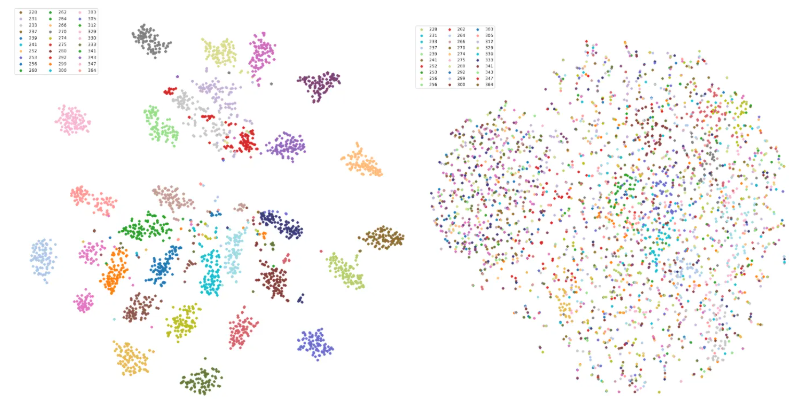
图4 语音向量(上)和语义单元(下)中说话人信息聚类分布
语义信息
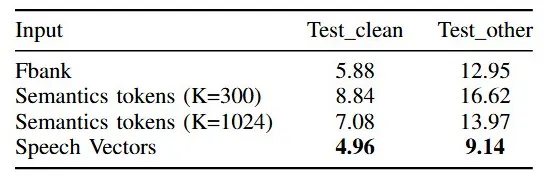
本文使用Fbank、K为300和1024时的词元、语义向量作为U2++ Conformer的输入,在LibriSpeech 数据集上进行了语音识别的训练,并在test_clean and test_other上进行了测试。表1结果显示,语义向量的结果最好,词元的性能有所下降,但在可接受范围之内,说明词元保留了必要的语义信息。
表1 语音向量和语义单元在语音识别任务上的结果(LibriSpeech)
重建质量
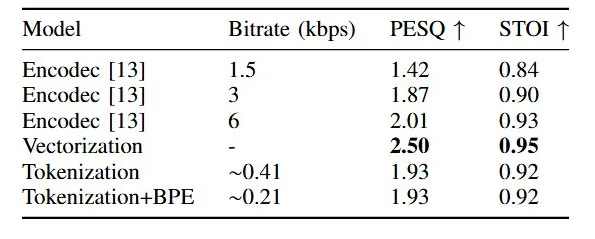
本文对Vec-Tok Codec的重建质量做了分析,表2结果发现Vec-Tok Codec能在码率降低的情况下,能以较好的质量还原语音。
表2 Vec-Tok Codec 和 Encodec在语音重构任务上的表现
音色转换
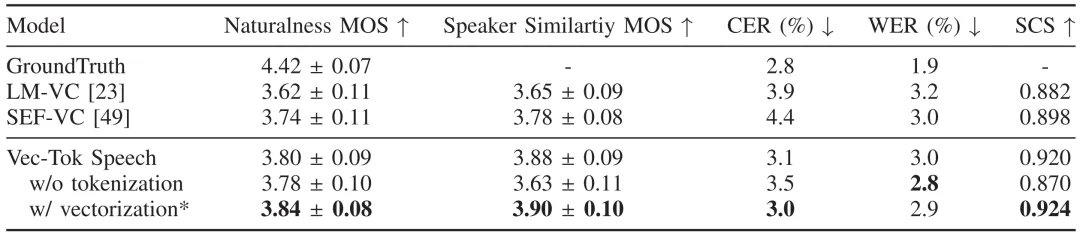
本文和当时主流的VC模型进行对比,表3和表4结果显示Vec-Tok Speech在同语种和跨语种语音转换上取得了较高的说话人相似度和转换稳定性。基于本文对语音转换做进一步的研究请参见Vec-Tok VC+。
表3 Vec-Tok Speech和LM-VC、SFE-VC在同语种语音转换任务上的表现
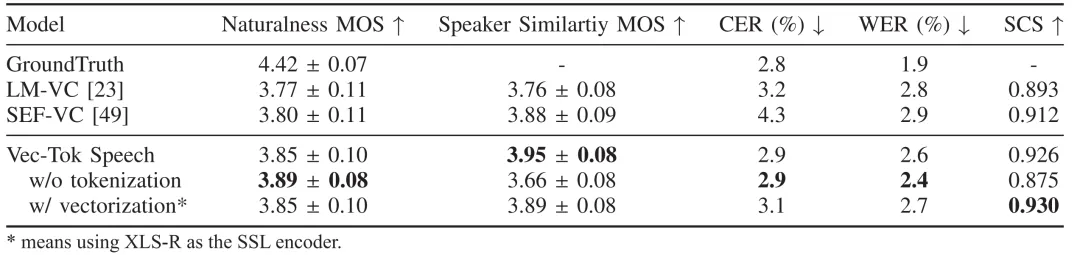
表4 Vec-Tok Speech和LM-VC、SFE-VC在跨语种语音转换任务上的表现
语音合成
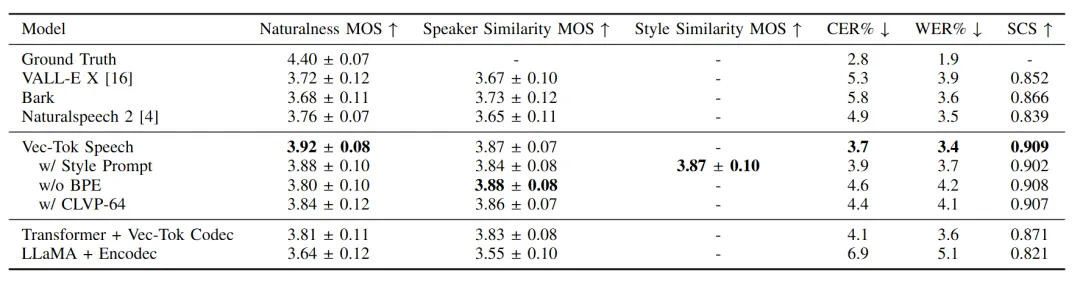
本文和当时主流的TTS模型做了对比,结果如表5显示Vec-Tok Speech在自然度、说话人相似度、字/词错误率上取得优势,并支持迁移不同的风格和音色。
表5 Vec-Tok Speech 和对比模型在语音合成任务上的表现
语音降噪
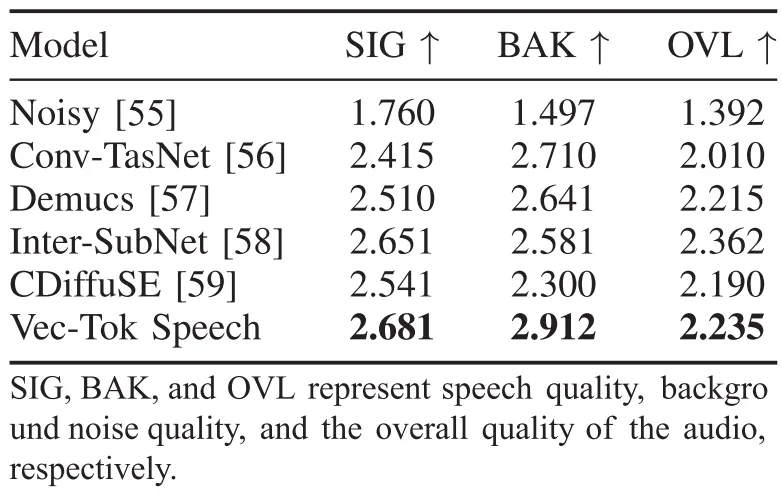
本文在DNS challenge 2021的测试集上与主流模型进行比较;结果显示,Vec-Tok Speech能较好地完成语音降噪任务。在这篇文章的基础上本文对语音降噪做了进一步的研究,参见SELM。
表6 Vec-Tok Speech 在语音降噪任务上的表现
语音翻译
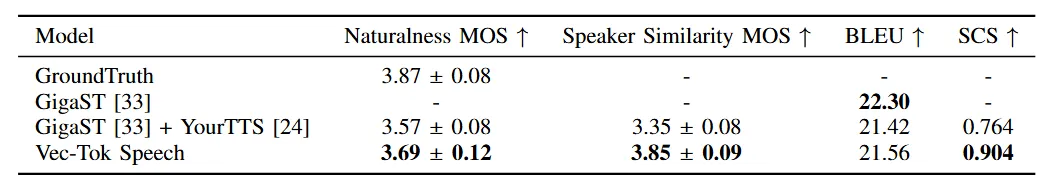
本文使用了GigaS2S作为数据集,进行了语音翻译的训练,并在GigaST的测试集上进行了测试,实验结果显示,Vec-Tok Speech能够做到保留音色并进行较为自然的翻译。
表7 Vec-Tok Speech 在语音翻译任务上的表现
语音匿名
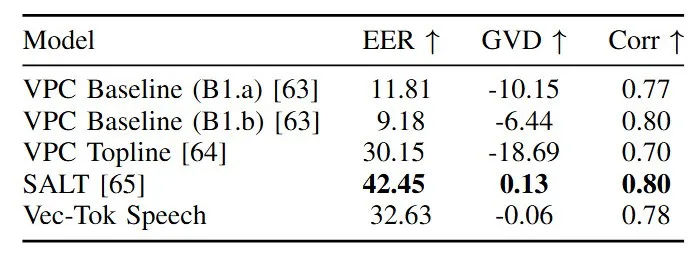
本文在VPC 2022的测试集上测试了Vec-Tok Codec的语音匿名效果,Vec-Tok Codec在多个参数上得到了高于VPC Topline的成绩
表8 Vec-Tok Speech 在语音匿名化任务上的表现
[1] C. Wang et al., “Neural codec language models are zero-shot text to speech synthesizers,” 2023, arXiv:2301.02111.
[2] E. Kharitonov et al., “Speak, read and prompt: High-fidelity text-to-speech with minimal supervision,” Trans. Assoc. Comput. Linguistics, vol. 11, pp. 1703–1718, 2023.
[3] A. Défossez, J. Copet, G. Synnaeve, and Y. Adi, “High fidelity neural audio compression,” Trans. Mach. Learn. Res., vol. 2023, 2023.
[4] Y.-C. Wu, I. D. Gebru, D. Markovi´c, and A. Richard, “AudioDec: An open-source streaming high-fidelity neural audio codec,” in Proc. 2023 IEEE Int. Conf. Acoust., Speech Signal Process., 2023, pp. 1–5.
[5] X. Wang et al., “Speechx: Neural codec language model as a versatile speech transformer,” IEEE ACM Trans. Audio Speech Lang. Process., vol. 32, pp. 3355–3364, 2024
