
 语音小管家
在通用人工智能(AGI)备受瞩目的今天,音频大模型的研究也正快速推进。但相比图文多模态的成熟体系,音频领域仍面临巨大的挑战。不同类型的音频任务——如语音识别、音频事件检测、音乐理解等——往往“各自为政”,难以统一建模。为解决上述问题,西工大音频语音与语言处理研究组(ASLP@NPU)与字节跳动研究团队联合提出通用音频语言模型 U-SAM(Unified Speech, Audio, and Music model)。对应论文“U-SAM: An Audio Language Model for Unified Speech, Audio, and Music Understanding”已被语音领域顶级会议 INTERSPEECH 2025 接收。该工作提出将语音、环境音、音乐三类音频数据纳入统一建模框架,结合大语言模型与多模态感知机制,实现多任务、多模态、多类型音频的统一理解。接下来将对该论文进行简要解读和分享。
论文题目:U-SAM: An Audio Language Model for Unified Speech, Audio, and Music Understanding
作者列表:王子谦,夏咸军,朱新发,谢磊
合作单位:字节跳动
论文原文:https://arxiv.org/abs/2505.13880
背景动机
近年来,大语言模型(LLM)在图文多模态领域取得显著进展,推动了类ChatGPT、GPT-4o等多模态智能体的发展。而在音频领域,尽管已有CLAP[1]、Whisper[2]和Salmonn[3]等代表性模型,现有方法仍面临三大挑战:
难以统一建模多种音频类型:当前通用音频语言模型常使用单一音频编码器,难以同时理解语音、环境音和音乐等多样化音频数据。
缺乏任务感知的特征融合机制:已有的多编码器模型通常将不同音频特征直接拼接,未考虑不同任务对特征的侧重差异,导致泛化能力有限。
音频-文本对齐能力不足:传统的交叉熵损失无法识别冗余音频帧,易造成语义对齐不精准,尤其在处理长音频序列时表现较差。
为解决上述问题,本文提出U-SAM,一种融合多编码器感知 + 大语言模型推理的统一音频语言模型。U-SAM 的关键设计包括:
双塔结构:结合语音编码器(Whisper)、通用音频编码器(CED)、音乐编码器(MERT)三者的能力,全面提取多维度音频信息;
任务感知投影模块(TAPM):引入 Mixture-of-Experts(MoE)机制,根据文本提示动态融合音频特征,支持跨任务灵活适配;
语义感知对比损失(SACLM):利用对比学习框架选出关键音频帧,有效剔除冗余信息,从而增强音频与文本之间的语义对齐。这些模块协同作用,使得 U-SAM 能在多种音频任务上实现统一建模与跨模态生成,具备良好的泛化能力与可扩展性。
提出方法
为实现对语音、环境音、音乐等多类音频的统一建模,本文提出了统一音频语言模型U-SAM(Unified Speech, Audio, and Music model)。该模型融合多模态编码器、任务感知融合机制、轻量语言模型微调方式及语义感知对齐策略,力图解决现有音频语言模型在“任务割裂”“信息冗余”“对齐困难”等方面的核心挑战。
多编码器感知结构
U-SAM采用了三路并行的专用音频编码器结构,分别处理语音、一般音频事件、音乐三种数据类型,具体包括:Whisper 编码器[2]:用于语音类任务,能有效提取语音结构、发音细节等信息;CED 编码器[4]:擅长非语音音频建模,如环境音、声学事件等;MERT 编码器[5]:用于音乐场景,提取旋律、节奏、和声等高层语义信息。
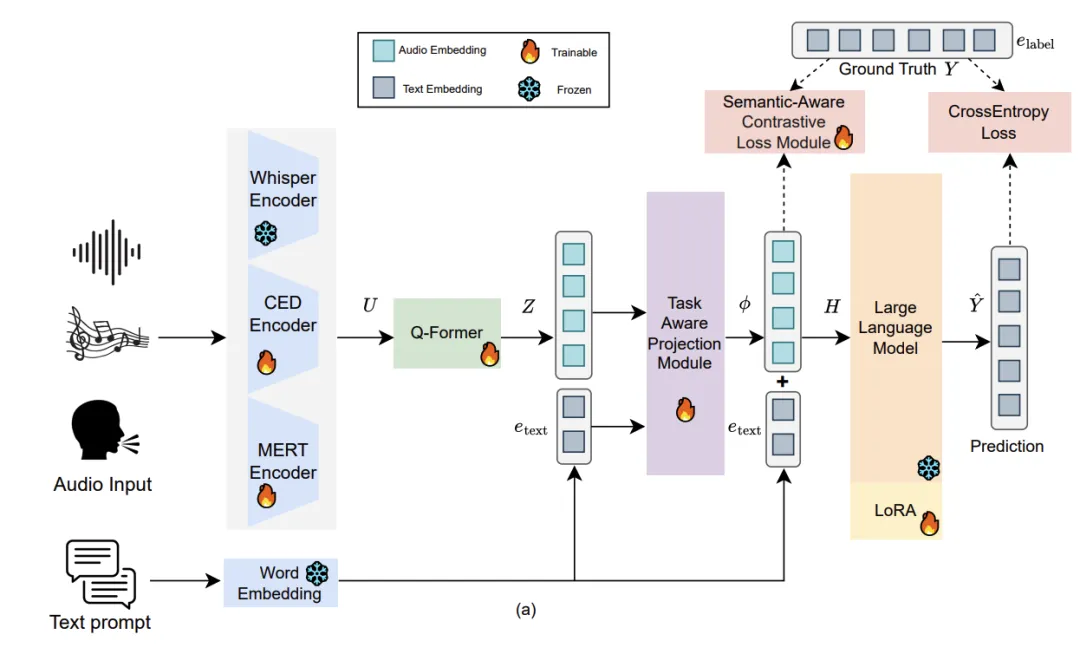
图1 U-SAM模型结构图
三路编码器的输出在通道维度拼接,保留各自优势特征,形成统一的音频嵌入表示。
窗口级 Q-Former
为保留时间敏感性强的音频结构,U-SAM 引入窗口级 Q-Former [6]模块,借助一组可训练的查询向量,对不同时间段的音频帧进行注意力编码与抽象压缩。该模块具备自适应对齐能力,可有效提取长音频中的关键信息,形成固定长度的中间表示,为下游任务提供语义浓缩的特征输入。
任务感知投影模块 TAPM
面对多任务场景中不同音频特征的关注重点差异,U-SAM设计了TAPM(Task-Aware Projection Module),以文本提示为导向,引入 Mixture-of-Experts 架构动态调整音频表示:首先,使用文本提示(Prompt)计算一组 soft routing 权重;然后,将音频嵌入传入多个专用投影子网络(专家网络);最终,按照权重将多个投影结果加权融合,生成适用于当前任务的音频表示。这种设计使得 U-SAM 在面对语音识别、音频字幕总结、语音翻译等任务时,能自动适配特征焦点,从而获得更强的迁移与泛化能力。
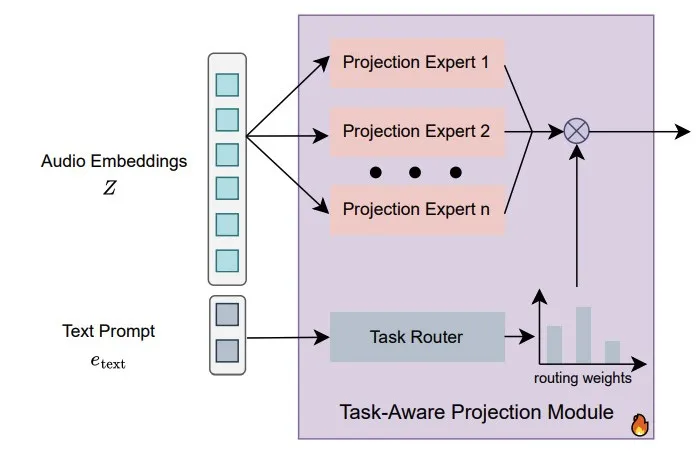
图2 TAPM模块结构图
LoRA微调语言模型
音频特征经过 TAPM 处理后,会与对应文本提示进行拼接,并输入到预训练大语言模型 LLaMA 中。为避免全参数微调带来的计算压力与过拟合问题,U-SAM采用 LoRA(Low-Rank Adaptation) 技术[7],仅更新注意力模块中的低秩矩阵,大幅降低训练成本,仅需训练约0.39%的参数即可获得优异性能。
语义感知对比学习模块 SACLM
音频序列往往冗长、重复性强,直接与语言对齐容易引入噪声。为此,U-SAM设计了SACLM(Semantic-Aware Contrastive Loss Module),具备如下功能:帧显著性评分:引入一个可训练网络,对每一帧音频赋予显著性得分;重要帧选择与聚合:仅保留显著性高的音频帧进行加权聚合;三元组对比学习:构造(音频、文本、负文本)三元组,通过 Triplet Loss 强化语义一致性的同时避免“过拟合对齐”。
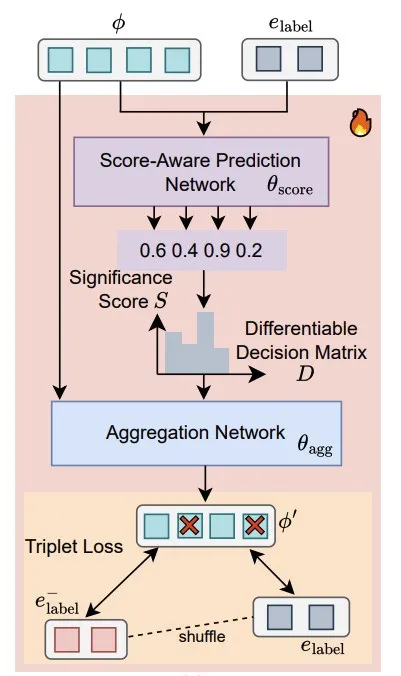
图3 SACLM模块示意图
实 验
多任务评测
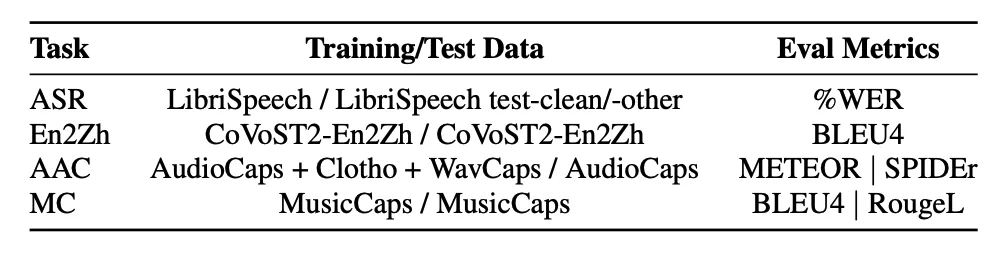
为了全面验证 U-SAM 在多种音频理解任务中的表现,我们设计了覆盖语音、环境音、音乐三大类型的实验体系,涵盖 4 项典型任务,7 个公开数据集,比较 10 余个代表性模型,并进行了多组消融实验。
表1 U-SAM 采用的数据集与评价指标
与现有模型对比分析
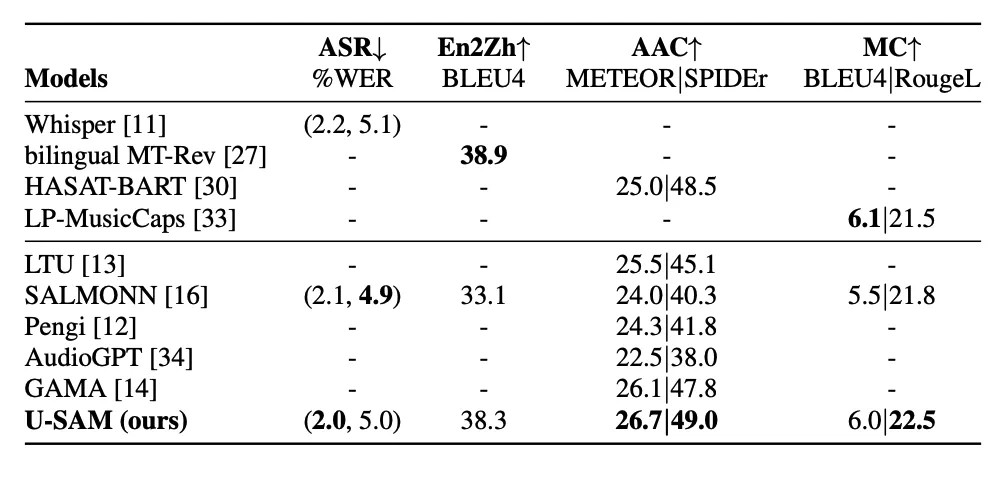
U-SAM 与以下几类模型进行了系统对比:
专家模型:Whisper(语音识别)[2]、MT-Rev(语音翻译)[8]、HASAT-BART(音频字幕)[9]和 LP-MusicCaps(音乐字幕)[10];
通用音频语言模型:LTU[11]、SALMONN[3]、Pengi[12]、AudioGPT[13]和 GAMA[14]。
如表2所示,在所有任务上,U-SAM 均表现出色,尤其在 AAC 和 MC 两个多模态生成任务上取得了 SOTA 结果。这也表明了,U-SAM不仅在语音类任务上保持领先,在更具挑战性的多模态音频生成任务中也展现出强大的语义建模与文本生成能力。
表2:U-SAM与现有方法在测试集上的对比结果
消融实验
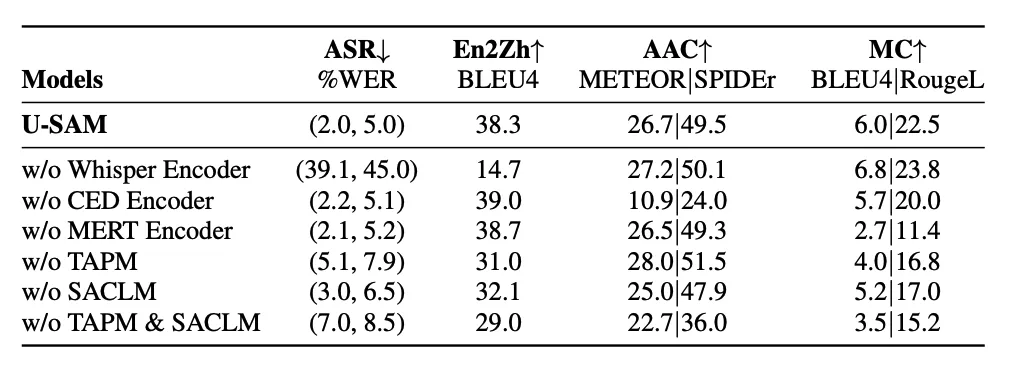
为了进一步验证模型中各模块的有效性,我们进行了详细的消融实验,包括逐步移除编码器(Whisper、CED、MERT)、任务感知模块(TAPM)与语义对齐模块(SACLM)等设置,结果如表3所示。
表3:U-SAM消融实验结果
由实验结果可见:
移除任意一个编码器都会导致相应子任务性能大幅下降,说明多编码器架构在统一建模中至关重要;
TAPM 能显著提升任务适应能力,防止模型在大数据上过拟合特定任务;
SACLM 强化了音频与文本的语义对齐能力,对生成质量影响显著。
U-SAM 在多个任务、多种模态下均取得领先性能,并通过消融实验验证了每一模块在整体性能中的贡献。该模型展示出优越的跨任务迁移能力和对未知任务的“涌现能力”,为构建通用音频智能体奠定了坚实基础。
参考文献
[1] B. Elizalde, S. Deshmukh, M. Al Ismail, and H. Wang, “Clap learning audio concepts from natural language supervision,” in ICASSP 2023-2023 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2023, pp. 1–5.
[2] A. Radford, J. W. Kim, T. Xu, G. Brockman, C. McLeavey, and I. Sutskever, “Robust speech recognition via largescale weak supervision,” 2022. [Online]. Available: https://arxiv.org/abs/2212.04356
[3] C. Tang, W. Yu, G. Sun, X. Chen, T. Tan, W. Li, L. Lu, Z. Ma, and C. Zhang, “Salmonn: Towards generic hearing abilities for large language models,” arXiv preprint arXiv:2310.13289, 2023.
[4] H. Dinkel, Y. Wang, Z. Yan, J. Zhang, and Y. Wang, “Ced: Consistent ensemble distillation for audio tagging,” in ICASSP 2024- 2024 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2024, pp. 291–295.
[5] L. Yizhi, R. Yuan, G. Zhang, Y. Ma, X. Chen, H. Yin, C. Xiao, C. Lin, A. Ragni, E. Benetos et al., “Mert: Acoustic music understanding model with large-scale self-supervised training,” in The Twelfth International Conference on Learning Representations, 2023.
[6] J. Li, D. Li, S. Savarese, and S. Hoi, “Blip-2: Bootstrapping language-image pre-training with frozen image encoders and large language models,” in International conference on machine learning. PMLR, 2023, pp. 19 730–19 742.
[7] E. J. Hu, Y. Shen, P. Wallis, Z. Allen-Zhu, Y. Li, S. Wang, L. Wang, and W. Chen, “Lora: Low-rank adaptation of large language models,” arXiv preprint arXiv:2106.09685, 2021.
[8] C. Wang, A. Wu, and J. Pino, “Covost 2 and massively multilingual speech-to-text translation,” arXiv preprint arXiv:2007.10310, 2020.
[9] X. Mei, C. Meng, H. Liu, Q. Kong, T. Ko, C. Zhao, M. D. Plumbley, Y. Zou, and W. Wang, “Wavcaps: A chatgpt-assisted weaklylabelled audio captioning dataset for audio-language multimodal research,” IEEE/ACM Transactions on Audio, Speech, and Language Processing, 2024.
[10] S. Doh, K. Choi, J. Lee, and J. Nam, “Lp-musiccaps: Llm-based pseudo music captioning,” arXiv preprint arXiv:2307.16372, 2023.
[11] Y. Gong, H. Luo, A. H. Liu, L. Karlinsky, and J. Glass, “Listen, think, and understand,” arXiv preprint arXiv:2305.10790, 2023.
[12] S. Deshmukh, B. Elizalde, R. Singh, and H. Wang, “Pengi: An audio language model for audio tasks,” Advances in Neural Information Processing Systems, vol. 36, pp. 18 090–18 108, 2023.
[13] R. Huang, M. Li, D. Yang, J. Shi, X. Chang, Z. Ye, Y. Wu, Z. Hong, J. Huang, J. Liu et al., “Audiogpt: Understanding and generating speech, music, sound, and talking head,” in Proceedings of the AAAI Conference on Artificial Intelligence, vol. 38, no. 21, 2024, pp. 23 802–23 804.
[14] S. Ghosh, S. Kumar, A. Seth, C. K. R. Evuru, U. Tyagi, S. Sakshi, O. Nieto, R. Duraiswami, and D. Manocha, “Gama: A large audio-language model with advanced audio understanding and complex reasoning abilities,” arXiv preprint arXiv:2406.11768, 2024.
