
 语音小管家
论文题目:Multi-Input Multi-Output Target-Speaker Voice Activity Detection For Unified, Flexible, and Robust Audio-Visual Speaker Diarization
作者列表:Ming Cheng(程铭), Ming Li(李明)
阅读原文:https://arxiv.org/abs/2401.08052
“谁在什么时候说话”是多说话人语音理解中的核心问题。然而,在多人重叠、远场拾音,甚至视频遮挡的复杂场景下,传统说话人识别方法常常面临准确率下降、模态缺失等挑战。
针对这一难题,武汉大学与昆山杜克大学团队提出了MIMO-TSVAD(Multi-Input Multi-Output Target-Speaker Voice Activity Detection,多输入多输出的目标说话人语音活动检测)框架。该方法支持音频、视频以及音视频融合输入,并灵活处理声纹信息或唇动轨迹作为说话人身份线索,即使在部分模态缺失的情况下,也能实现稳定、精准的说话人日志任务。
MIMO-TSVAD 实现了统一建模、灵活输入、鲁棒推理三大优势,在多个公开音视频数据库上取得领先性能,并已成功发表于语音领域旗舰期刊 IEEE Transactions on Audio, Speech and Language Processing。
在传统特定人语音活动检测(TS-VAD)方法基础上,本文提出了一种具备多输入与多输出能力的说话人日志新框架——MIMO-TSVAD(Multi-Input Multi-Output Target-Speaker Voice Activity Detection)。如图1所示,MIMO-TSVAD 的核心在于其“多模态编码器 + 多任务解码器”的结构设计。编码器对音频与视频信号分别提取时序特征并融合模态信息,解码器则根据不同输入场景自动选择“音频分支、视频分支或音视频混合分支”进行说话人语音活动判断,实现了高度灵活和稳健的任务适应能力。其不仅兼容不同模态的信号组合,还能在测试阶段根据可用信息“动态切换”策略,从而在遮挡、丢帧、缺声纹等实际问题中依旧保持稳定性能。
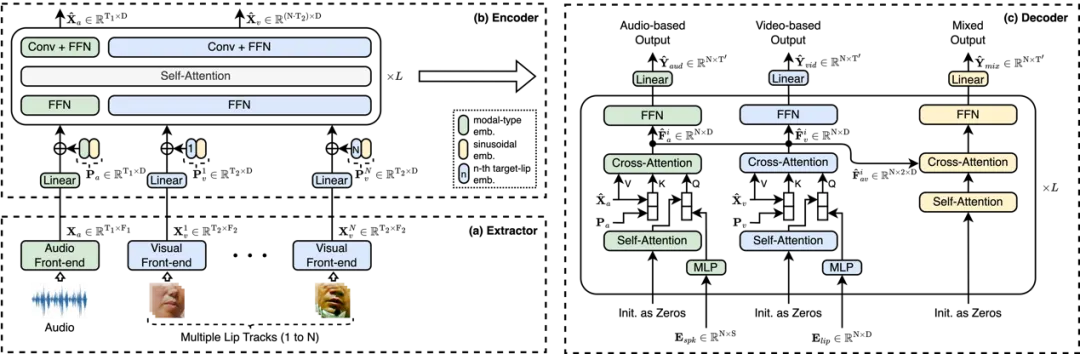
图1. 所提出的 MIMO-TSVAD 框架结构图,包含音视频特征提取器、跨模态编码器与多任务解码器三部分。
如图2所示,MIMO-TSVAD 引入了多阶段推理策略,以适应现实场景中音频或视频模态缺失的问题。这一机制根据输入信息的可用性,灵活选择不同的推理路径,确保系统始终能发挥最大性能。具体包括以下四个阶段:
阶段1:音频输入+ 声纹表示。相当于传统TS-VAD 模型,使用声纹注册结果作为参考,完成音频主导的特定人语音活动检测;
阶段2:视频输入+ 唇动表示。不依赖声纹,只通过视觉的唇动序列作为参考信息区分不同说话人,完成特定人语音活动检测,适用于音频缺失或噪声严重场景;
阶段3:音视频输入+ 唇动表示。引入音频作为辅助信息,提高说话人起止边界的时间精度;
阶段4:音视频输入+ 混合表示(声纹+唇动)。时使用声纹和唇动信息,在模态不完全可用的现实情况下,仍可借助“部分可用模态”完成说话人活动预测。引入说话人对齐(Speaker Alignment, SA)模块后,即使部分说话人的唇动轨迹缺失,系统也能自动匹配其声纹信息,有效缓解“离屏(Off-screen)说话人无法识别”的问题。
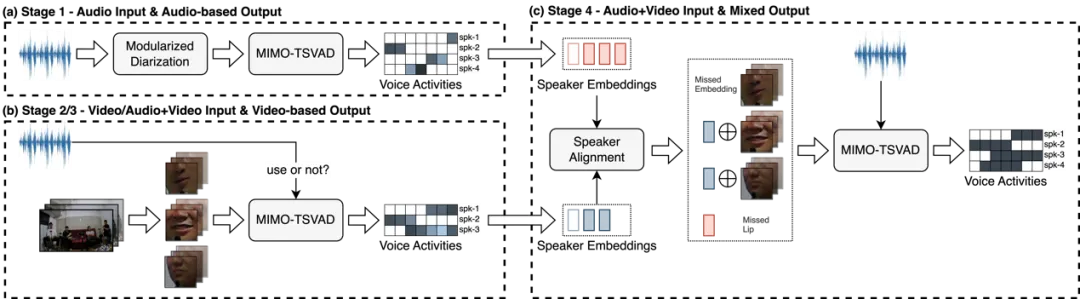
图2. MIMO-TSVAD 多阶段推理流程示意图。模型可根据输入模态类型动态切换至音频分支、视频分支或混合分支,并借助说话人对齐模块补全缺失信息。
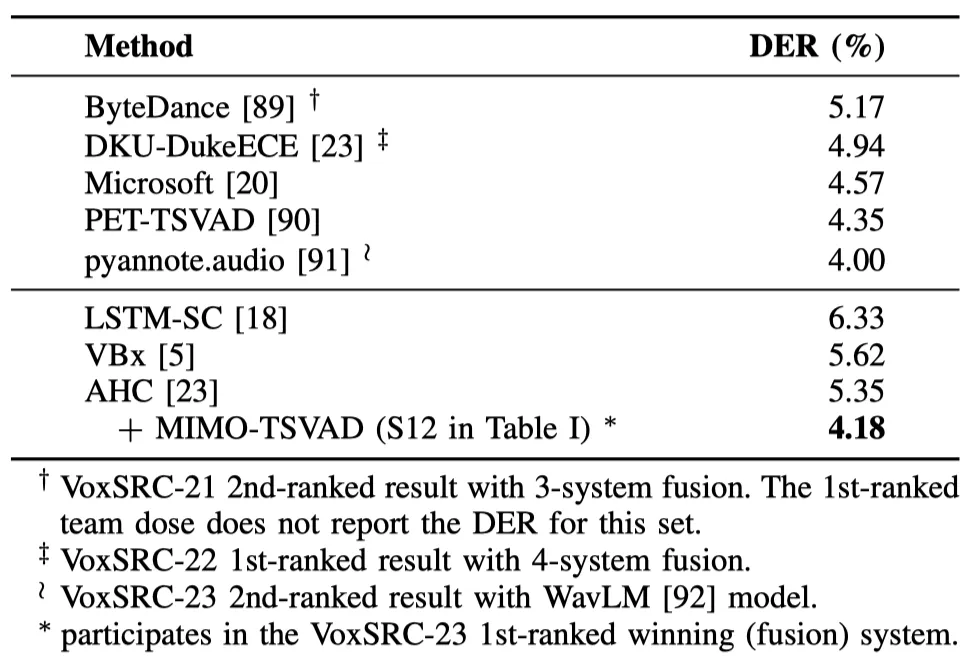
为验证MIMO-TSVAD 在不同模态输入下的通用性与性能表现,研究团队分别在纯音频任务和音视频任务上进行了系统评估。在纯音频场景中,MIMO-TSVAD 在两个主流评测数据集上均实现了领先的说话人日志错误率(Diarization Error Rate, DER):
如表1所示,在VoxConverse数据集上,评测采用非Oracle VAD + 250msCollar的设置,MIMO-TSVAD达到 4.18% 的DER,优于Microsoft、PET-TSVAD等代表系统;
表1.MIMO-TSVAD 与其他模型在 VoxConverse 测试集上的对比结果
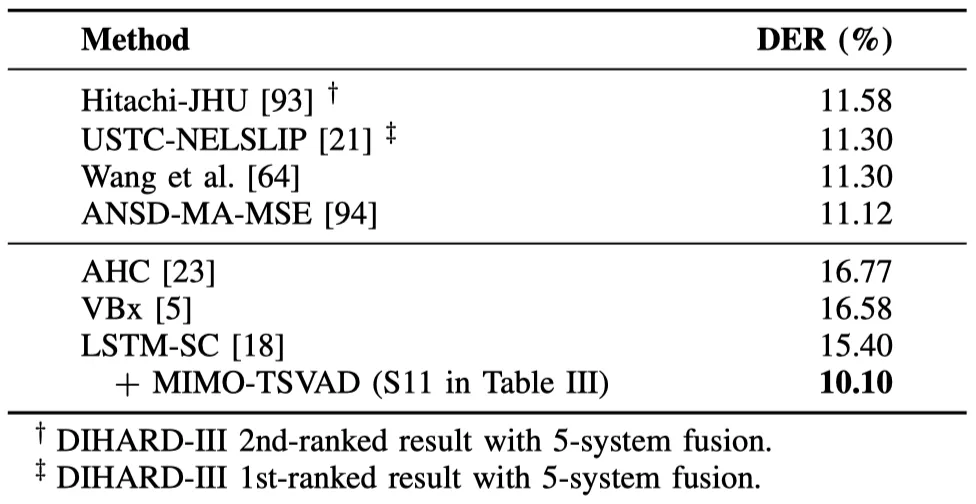
如表2所示,在DIHARD-III数据集上,根据比赛Track 1使用Oracle VAD且不带Collar 的评测条件下,系统实现了 10.10% 的 DER,明显优于过往挑战赛前列融合系统(如 Hitachi-JHU、USTC-NELSLIP)。
表2.MIMO-TSVAD 与其他模型在 DIHARD-III测试集上的对比结果
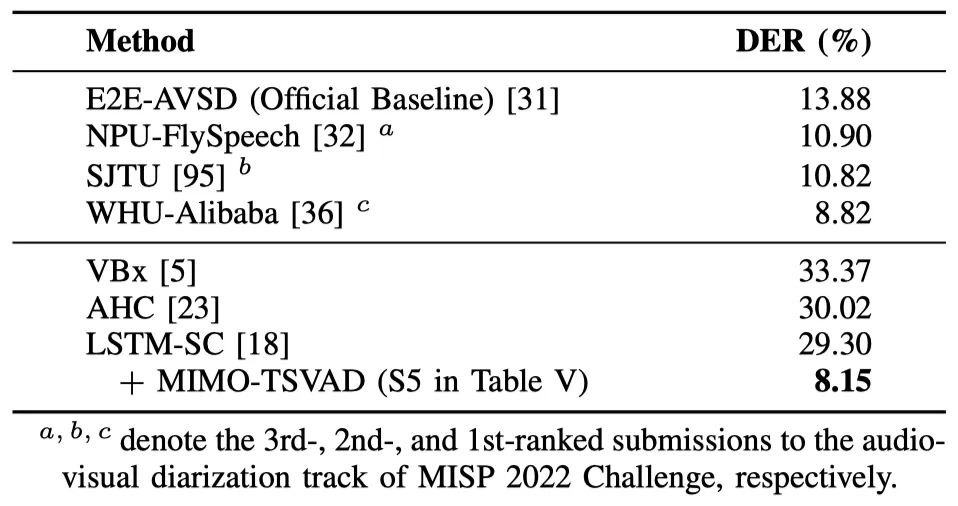
如表3所示,在音视频联合场景中,MIMO-TSVAD 在中文家庭多模态数据集 MISP 2022 上展现出极强的模态适应能力与鲁棒性。其中,在采用推理阶段4(音视频输入+ 混合输出)和说话人对齐(SpeakerAlignment)的策略下,系统在MISP 2022 测试集上达到 8.15% 的 DER(使用 Oracle VAD,带250ms Collar),相比官方 baseline(13.88%)大幅提升。该系统在相同评测条件下的表现,也显著优于MISP 2022 挑战赛中排名第一的参赛方案(DER 为 8.82%),进一步验证了其方法的领先性与实用性。
表3.MIMO-TSVAD 与其他模型在MISP 2022测试集上的对比结果
为了进一步分析MIMO-TSVAD 在视觉信息缺失场景下的鲁棒性,研究团队在测试集上构造了三种不同类型的唇动缺失条件,用于模拟现实中可能出现的视觉模态不可用情况:
部分缺失(Partially Off-screen):每位说话人的唇动序列被随机选中一段时间移除,视频中的说话人总数保持不变;
完全缺失(Completely Off-screen):随机选定部分说话人,并将其所有的唇动序列完全移除,视频中的说话人数量因此减少;
混合缺失(Hybrid):上述两种情况同时发生。
图3展示了在不同唇动缺失场景与缺失程度下,MIMO-TSVAD 系统的性能变化情况。由于推理阶段 2-3 依赖于说话人的唇动信息作为目标人注册,其 DER 在所有缺失场景中随唇部区域缺失率的上升呈近似线性增长。值得注意的是,未使用说话人对齐模块(Speaker Alignment, SA)时,推理阶段 4 在不同唇动缺失场景中表现出明显差异。在图 3(a)的部分缺失场景中,系统通过融合输出分支预测,因此可表现出较强鲁棒性。只要每位说话人仍有少量可用的唇动片段用于提取对应的声纹嵌入,系统即能维持良好表现。但当缺失率达到100% 时,系统将直接失效。在图 3(b)的完全缺失场景中,由于缺失唇动信息后对应的说话人在视频中将完全不可见,其声纹无法通过前一阶段的视频输出获取,导致DER 随缺失率迅速上升。图 3(c)对应混合缺失场景,其DER 曲线兼具前两者特征。未使用说话人对齐的推理阶段4 可能成功识别部 分缺失说话人的语音活动,但对于完全缺失的说话人无能为力。最后,引入说话人对 齐模块显著提升了推理阶段 4 的鲁棒性。借助补全的唇动缺失说话人的声纹, MIMO-TSVAD 的融合输出分支在多种场景下均可保持稳定性能。
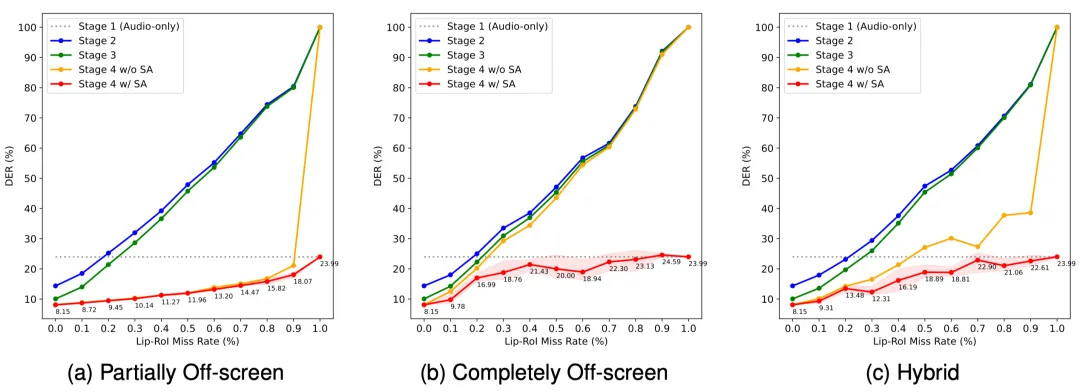
图3.MIMO-TSVAD 模型在以不同唇部缺失率仿真的 MISP2022 评估集上的日志错误率(DER)表现。所汇报的每个数值为三组独立仿真结果的平均值,红色阴影带表示最大值与最小值之间的区间。
本文提出了一种新颖的MIMO-TSVAD 框架,以应对复杂音视频数据可用性下的说话人日志问题。该模型通过联合设计的多阶段训练与推理策略,在统一框架内兼容不同场景。实验结果表明,MIMO-TSVAD 在纯音频、纯视频和音视频说话人日志任务中均表现出色。此外,MIMO-TSVAD 在唇动缺失问题上展现出强鲁棒性:在不同缺失程度的模拟场景中,其音视频系统的 DER 始终不劣于纯音频系统。
