
 语音小管家
语音理解与生成的飞速发展离不开大规模高质量语音数据集的推动。其中,语音识别(ASR)和语音合成(TTS)被公认为最首要的任务。但对于拥有约 8490 万母语使用者的粤语而言,受限于标注资源匮乏,研究进展缓慢,ASR 与 TTS 的表现始终不尽如人意。现有公开的粤语语料库在规模、风格和标注维度上普遍存在不足。例如 Common Voice 和 MDCC 等项目过度依赖人工标注,仅能提供小规模数据;评测集大多局限于短句,缺乏对复杂语言现象的覆盖。同时,这些语料往往只提供语音-文本对齐信息,缺乏说话人属性或声学质量等元数据,极大限制了其在自监督学习、风格建模和多任务训练中的应用,导致主流 ASR 与 TTS 系统在粤语任务上表现欠佳,并在真实场景中泛化能力不足。
为解决上述问题,西北工业大学音频语音与语言处理研究组(ASLP@NPU)联合中国电信人工智能研究院、希尔贝壳、香港科技大学和Wenet开源社区,提出了 WenetSpeech-Pipe ——一个面向语音理解与生成、支持多维度标注的大规模语音语料构建一体化流程。该流程包含六个模块:音频采集、说话人属性标注、语音质量标注、自动语音识别、文本后处理与识别结果投票,能够生成丰富且高质量的标注。基于该流程,构建并发布了WenetSpeech-Yue——首个大规模粤语多维标注语音语料库,涵盖 21800 小时、10 大领域的粤语语音数据,并包含 ASR 转录、文本置信度、说话人身份、年龄、性别、语音质量评分等多种标注信息。同时,我们还发布了WSYue-eval,这是一个全面的粤语评测基准,包含两个部分:WSYue-ASR-eval(人工标注集,用于评测短句/长句、粤英转换及多样声学条件下的 ASR 性能),以及WSYue-TTS-eval(基础与覆盖子集,用于标准测试与泛化能力测试)。实验结果表明,基于WenetSpeech-Yue训练的模型在粤语 ASR 与 TTS 任务中表现优异,性能超越最先进(SOTA)的系统,并与商业系统相媲美,凸显了该数据集与流程的重要价值。
相关技术报告 “WenetSpeech-Yue: A Large-scale Cantonese Speech Corpus with Multi-dimensional Annotation” 已公开发布。我们已全面开源代码、模型及在线体验页面,诚邀各位开发者与研究者试用,共同推动粤语语音技术的发展!
论文题目:WenetSpeech-Yue: A Large-scale Cantonese Speech Corpus with Multi-dimensional Annotation
作者列表:李龙豪*、郭钊*、陈虹洁、戴宇航、张子萸、薛鸿飞、左天伦、王成有、王水源、徐昕、卜辉、李杰、康健、张彬彬、袁锐斌、周子雅、雪巍、谢磊*Equal Contribution
论文预印版:https://arxiv.org/abs/2509.03959
仓库地址:https://github.com/ASLP-lab/WenetSpeech-Yue
Demo展示:https://aslp-lab.github.io/WenetSpeech-Yue/
实际体验地址:https://huggingface.co/spaces/ASLP-lab/WenetSpeech-Yue
WenetSpeech-Yue数据集地址:https://huggingface.co/datasets/ASLP-lab/WenetSpeech-Yue
WSYue-ASR-eval: https://huggingface.co/datasets/ASLP-lab/WSYue-ASR-eval
WSYue-TTS-eval: https://huggingface.co/datasets/ASLP-lab/WSYue-TTS-eval
ASR模型地址:https://huggingface.co/ASLP-lab/WSYue-ASR
TTS模型地址:https://huggingface.co/ASLP-lab/WSYue-TTS
近年来,语音理解与生成的快速发展主要得益于大规模、多样化且带有丰富标注的数据集。语音识别(ASR)与语音合成(TTS)等核心任务的性能,很大程度上依赖于这些数据资源在不同语言与声学条件下的支撑。事实上,许多先进的 ASR 与 TTS 系统正是凭借大规模、多样化语料的优势,才能实现性能的重大突破 [1] 。同时,可扩展的数据构建流程也推动了多语种、多领域大规模语料库的高效生成,为 ASR 和 TTS 系统的研发提供了坚实基础 [2] 。
然而,作为一种语言特征复杂的汉语方言,粤语(Cantonese)仍然严重缺乏高质量的标注语音资源。一方面,粤语在中国大陆、香港、澳门以及海外华人社区中共有超过 8490 万使用者 [3] 。其音系包含九声六调,兼具书面语与口语两套体系,并且常与英语发生语码转换,这些特点都给建模带来了独特挑战。另一方面,粤语所承载的文化特性,要求语音系统具备更强的鲁棒性、情感表达能力以及风格多样性,而现有资源远不足以支撑这些需求。
目前公开的粤语语料库在规模、风格和标注维度上普遍存在不足 [4] 。多数项目依赖大量人工标注,数据规模有限;评测集通常由短句构成,缺乏对复杂语言现象的覆盖。此外,大多数语料仅提供语音与文本的对齐信息,缺乏说话人属性或声学质量等元数据,这极大限制了其在自监督学习、风格建模和多任务训练中的应用。因此,现有主流 ASR 与 TTS 系统在粤语任务上的表现普遍较差,并且在真实场景中泛化能力不足。
针对以上分析,我们提出了WenetSpeech-Pipe,一个模块化、自动化的数据构建流程,结合多种质量提升策略与元数据扩充方法,用于构建大规模、多样化且带有丰富标注的粤语语料库。在此基础上,我们发布了WenetSpeech-Yue——迄今为止最大、最全面的开源粤语语料库,覆盖超过 21,800 小时语音,涵盖十个领域。为促进对 ASR 与 TTS 系统的系统性评测,我们进一步推出WSYue-eval,包括 WSYue-ASR-eval 与 WSYue-TTS-eval 两个子集,分别针对语音识别与合成任务,涵盖多种语言与声学场景,支持全面可靠的性能评估。实验结果表明,基于 WenetSpeech-Yue 训练的 ASR 与 TTS 模型在多个测试集上表现可与甚至超越现有最先进系统,显著推动了粤语语音理解与生成的发展。
我们提出的 WenetSpeech-Pipe 框架如图 所示,由六个模块组成:(A) 音频采集,(B) 说话人属性标注,(C) 语音质量标注,(D) 自动语音识别,(E) 文本后处理,以及 (F) 识别结果投票。
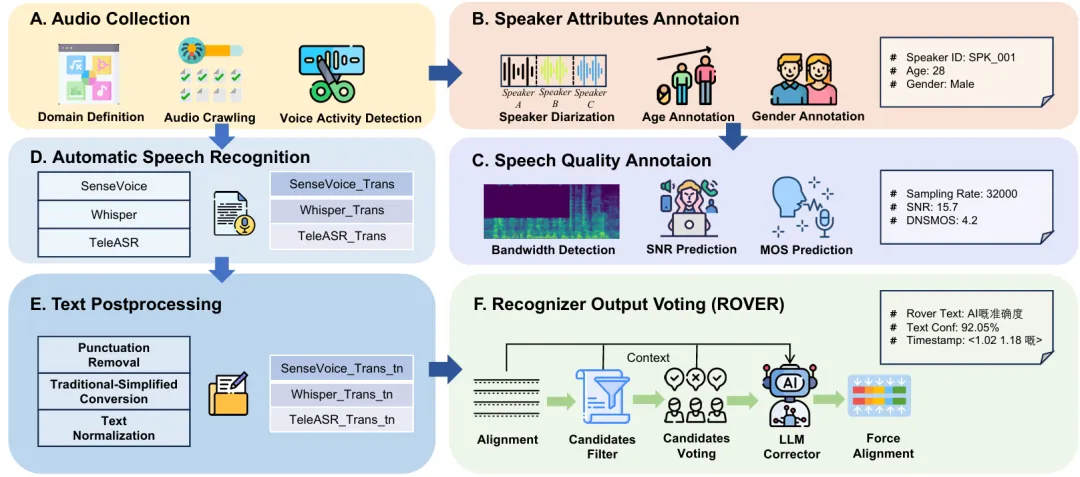
图 1 WenetSpeech-Pipe概览
音频采集:WenetSpeech-Pipe 首先从多个领域(如故事、影视、评论、Vlog、美食、娱乐、新闻和教育)大规模采集真实语音数据。由于原始录音多为几十分钟至数小时的长音频,不适合直接用于模型训练或对齐,因此系统通过语音活动检测(VAD)自动切分为短音频片段,从而生成可用于转写和质量评估的语句级数据,为后续处理奠定基础。
说话人属性标注:WenetSpeech-Pipe 在说话人属性标注阶段,先利用 pyannote 进行说话人分离,再通过 Vox-Profile 预测年龄和性别,生成带有身份、年龄和性别标注的语句级数据,为多说话人建模和风格可控合成提供支持。
语音质量标注:WenetSpeech-Pipe 在语音质量评估阶段结合三种方法:Brouhaha 计算信噪比、DNSMOS 预测主观质量分、带宽检测分析频谱特性,从而为每个片段生成包含 SNR、MOS 与频谱参考的结构化质量标注,支撑高保真语音建模。
自动语音识别:WenetSpeech-Pipe 通过多系统集成缓解单一 ASR 的偏差。每段音频由 SenseVoice、Whisper 和 TeleASR 三个粤语 ASR 系统独立转写,生成并行结果。经识别结果投票阶段的对齐与融合,得到更准确、鲁棒的最终转写。
文本后处理:WenetSpeech-Pipe 通过文本后处理统一多系统转写结果:使用 OpenCC 繁转简,去除符号与标签,规范数字和日期格式,并在中英文间加空格。这样生成的规范化转写确保 ROVER 融合时不会受表层差异干扰。
识别结果投票:WenetSpeech-Pipe 在文本归一化后,利用 ROVER [5] 融合多系统转写。具体来说,先使用通过动态规划对齐并过滤异常候选,再以多数投票生成最终结果并计算置信度,同时结合粤语拼音增强同音和语码转换处理。随后,借助 Qwen3-4B 进行轻量化上下文修正,提升语法与专名准确性。最后,使用声学模型进行字符级强制对齐,获得精确时间戳,支持下游任务。
数据集分布
元数据:所有元数据存储在单一 JSON 文件中,字段包括音频路径、时长、文本置信度、说话人身份、信噪比(SNR)、DNSMOS 分数、年龄、性别以及字符级时间戳。这些字段具有可扩展性,未来可进一步加入新的标签。
领域分布:WenetSpeech-Yue 的语料来源大致涵盖十个领域:故事、娱乐、戏剧、文化、Vlog、评论、教育、播客、新闻及其他,具体分布如图2所示。
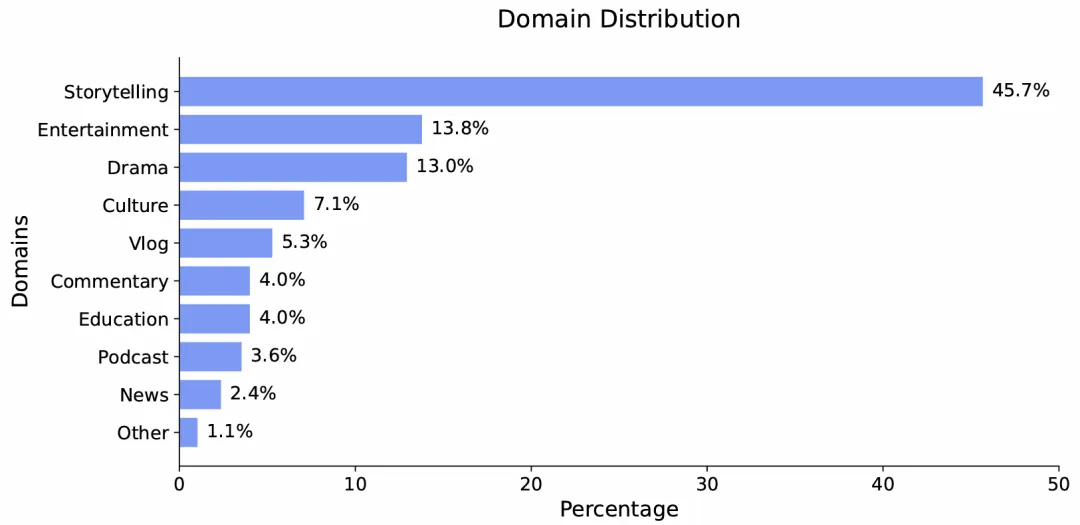
图 2 领域分布
时长分布:整个语料库共包含 21,800 小时音频,既包括长录音也包括短片段,切分后平均时长为 11.40 秒。
置信度:我们仅保留文本置信度高于 0.6 的标注,并根据区间划分为三类:强标注(conf > 0.9,6,771.43 小时)、中等标注(0.8 ~ 0.9,10,615.02 小时)和弱标注(0.6 ~ 0.8,4,488.13 小时)。
语音质量:我们评估了语料的音质:DNSMOS 分数范围为 2.0–4.4,SNR 范围为 -5–80 dB,采样率分布为 8,000–32,000 Hz。为确保生成式任务的可用性,我们过滤后仅保留 DNSMOS > 2.5 且 SNR > 25 dB 的样本,共得到约 12,000 小时高质量语音,可用于 TTS、声码器或语音转换等任务。
说话人属性:语料库在性别与年龄上分布不均,以男性为主,尤其集中在中年群体(50.6%),而女性在各年龄段中比例相对较低。
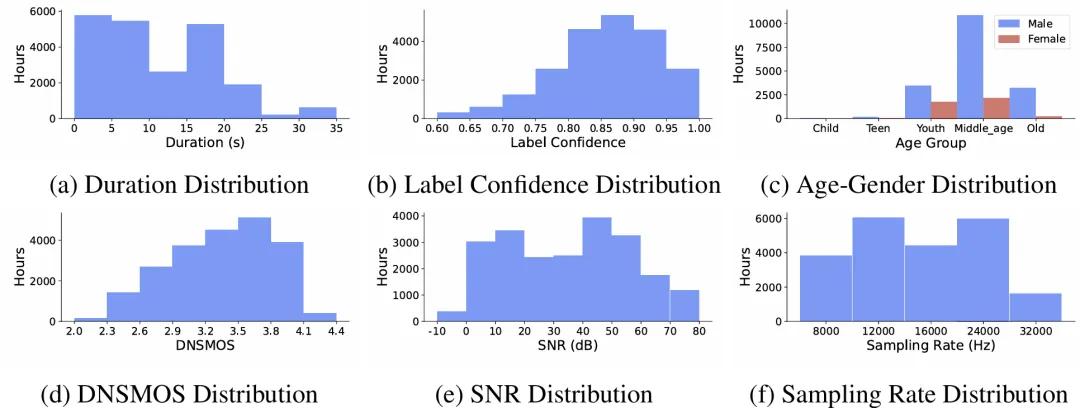
图 3 各属性分布
WSYue-eval
为应对粤语的语言特性,我们提出WSYue-eval,一个同时涵盖 ASR 与 TTS 的综合评测基准,用于全面检验模型在粤语处理上的表现。
ASR 评测集(WSYue-ASR-eval):该测试集经过多轮人工标注,包含转写、情感、年龄、性别等信息,并划分为 短语音(0–10 秒,9.46 小时,2861 位说话人)和 长语音(10–30 秒,1.97 小时,838 位说话人)两个子集,覆盖粤英转换及多领域场景。
TTS 评测集(WSYue-TTS-eval):该基准专为零样本粤语 TTS 设计,包含两个子集:
Base:1000 条来自 CommonVoice 的提示-文本对,用于测试日常场景;
Coverage:由人工与 LLM 生成文本组成,覆盖日常、新闻、娱乐、诗歌等多领域,并包含多音字、变调、语码转换、专名、数字等复杂语言现象。
ASR任务
我们采用混合错误率(MER)作为评测指标,其中中文按字级、英文按词级计算错误,用于比较基于 WenetSpeech-Yue 训练的模型与各类基线模型的表现。表1的实验结果显示:
在所有模型规模(small、medium、w/ LLM)下,我们的模型在大多数评测集上表现最佳;
在小规模模型中,SenseVoice-small-Yue 和 U2pp-Conformer-Yue 均表现优异,其中 SenseVoice-small-Yue 尽管规模较小,却超过了所有基线模型,说明该语料库能显著提升低容量模型的效率;
在不带 LLM 的组别中,U2pp-Conformer-Yue、Whisper-medium-Yue 和 SenseVoice-small-Yue 均优于大规模基线模型;
在带 LLM 的组别中,U2pp-Conformer-LLM-Yue 始终达到当前最先进水平。
表 1 ASR实验结果
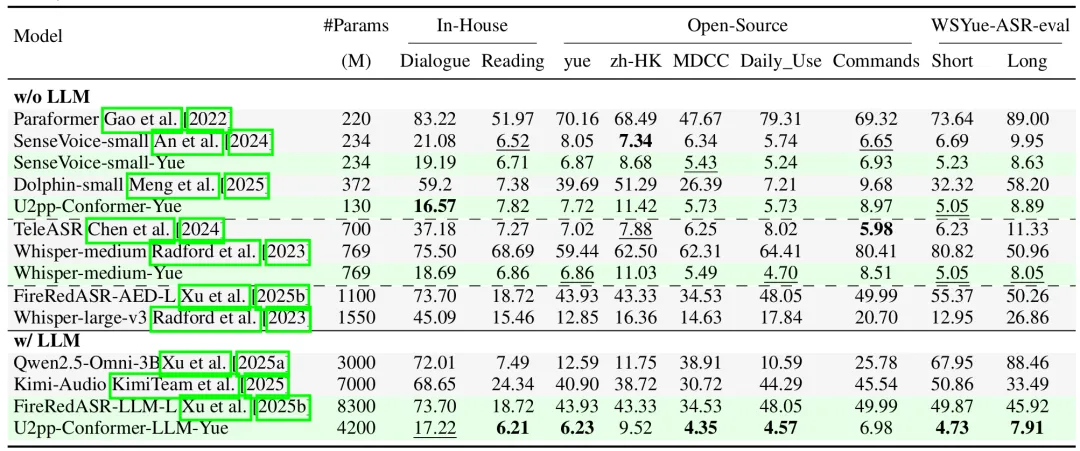
总体来看,WenetSpeech-Yue 不仅显著提升了整体性能,还能充分释放不同规模模型的潜力,验证了其在传统 ASR 和 LLM 增强型 ASR 中的广泛价值。
TTS任务
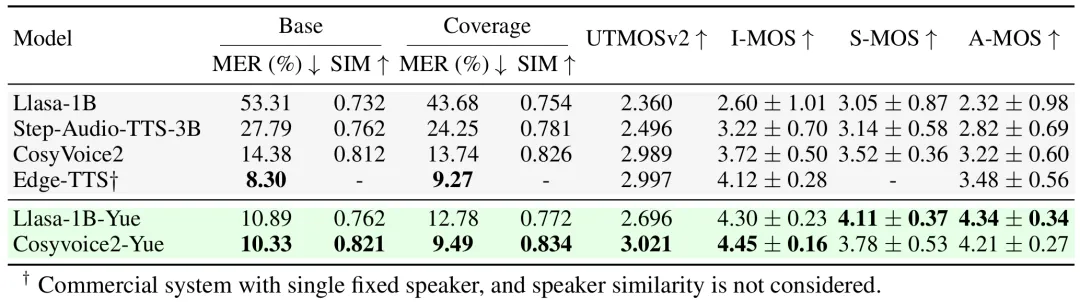
表2的实验结果表明,基于 WenetSpeech-Yue 微调的 Llasa-1B-Yue 和 CosyVoice2-Yue 在客观和主观指标上均显著优于各自的预训练基线:CosyVoice2-Yue 在 MER 和自然度(UTMOSv2)上表现最佳,并取得最高的可懂度(I-MOS),而 Llasa-1B-Yue 则在说话人相似度(S-MOS)和口音自然度(A-MOS)方面领先,体现了更自然的韵律与风格。整体上,两种模型在多维度上均大幅提升了粤语 TTS 的质量,验证了 WenetSpeech-Yue 在推动粤语语音合成方面的有效性。
表 2 TTS实验结果
[1] K. Xu, F. Xie, X. Tang, and Y. Hu. Fireredasr: Open-source industrial-grade mandarin speech recognition models from encoder-decoder to LLM integration. CoRR, abs/2501.14350, 2025b.
[2] B. Zhang, H. Lv, P. Guo, Q. Shao, C. Yang, L. Xie, X. Xu, H. Bu, X. Chen, C. Zeng, D. Wu, and Z. Peng. WENETSPEECH: A 10000+ hours multi-domain mandarin corpus for speech recognition. In ICASSP, pages 6182–6186. IEEE, 2022.
[3] R. Xiang, H. Tan, J. Li, M. Wan, and K.-F. Wong. When Cantonese NLP meets pre-training: Progress and challenges. In Proceedings of the 2nd Conference of the Asia-Pacific Chapter of the Association for Computational Linguistics and the 12th International Joint Conference on Natural Language Processing: Tutorial Abstracts, 2022.
[4] T. Yu, R. Frieske, P. Xu, S. Cahyawijaya, C. T. S. Yiu, H. Lovenia, W. Dai, E. J. Barezi, Q. Chen, X. Ma, B. E. Shi, and P. Fung. Automatic speech recognition datasets in cantonese: A survey and new dataset. In LREC, pages 6487–6494. European Language Resources Association, 2022.
[5] J. Fiscus. A post-processing system to yield reduced word error rates: Recognizer output voting error reduction (rover). In 1997 IEEE Workshop on Automatic Speech Recognition and Understanding Proceedings, 1997.
