语音小管家
幻觉、串语种问题获针对性优化
由于 CTC 是轻量化、非自回归结构,该模块几乎不增加额外推理耗时,却带来了双重优化效果:
1、优化“幻觉”问题
相比于文本 LLM,语音大模型的“幻觉”问题尤为突出。这是因为声学特征与文本特征在向量空间上天然存在差异,导致模型在“听”完音频后,容易“脑补”出大量不存在的内容。
尽管通过训练将声学特征对齐到文本特征空间,由于声学特征 Embedding 与真实的文本 Embedding 仍然存在这一定的差距,这会导致LLM在生成文本时发生幻觉的现象。
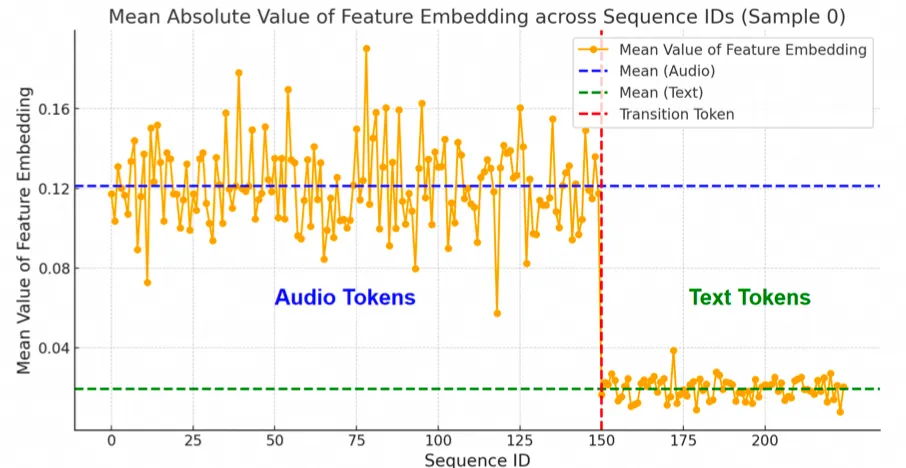
声学特征Embedding与真实的文本Embedding分布差异
通义实验室发现,给语音大模提供必要的上下文,可以减少文本生产时候的幻觉现象。为此,设计了Context 增强模块:该模块通过 CTC 解码器快速生成第一遍解码文本,并将该结果作为上下文信息输入 LLM,辅助其理解音频内容。
由于 CTC 结构轻量且为非自回归模型,几乎不增加额外推理耗时。
此外,观察到幻觉问题在高噪声场景中更易发生,因此在训练数据中加入了大量仿真数据。我们构建了一个包含 28 条易触发幻觉音频的测试集,经优化后,幻觉率从78.5%下降至10.7%。
2、缓解“串语种”问题
“串语种”是语音大模型落地中的另一类典型问题。具体表现为:输入音频内容为英文,模型输出却为中文文本。这是因为文本 LLM 本身具备翻译能力,在声学特征映射不够精确时,模型可能在推理过程中“自动启动”翻译功能,从而影响语音识别的准确性。
在 FunAudio-ASR 的Context 增强模块中,CTC 解码器经过高质量数据训练,本身发生串语种的概率极低。通过将 CTC 的第一遍解码结果作为 Prompt 输入给 LLM,可有效引导模型聚焦于语音识别任务,缓解“翻译”行为的发生。
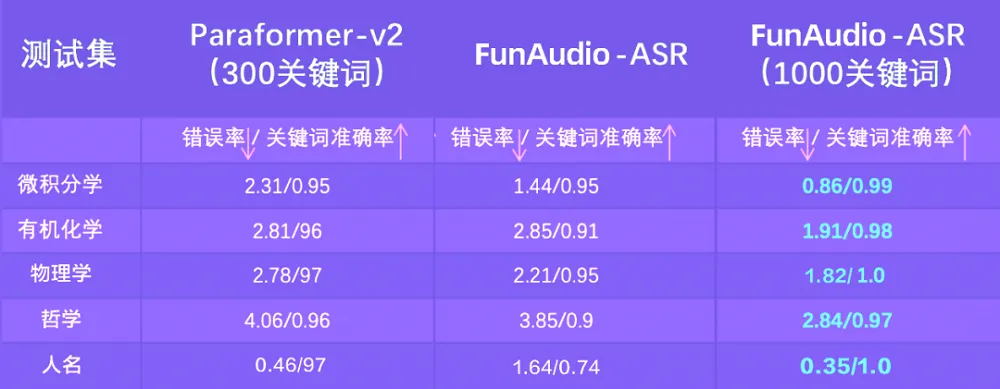
支持术语定制化识别
定制化识别通过提高特定词汇(如人名、术语等)的识别优先级,来提升它们的召回率,同时不影响整体准确度。
传统方法直接将用户词表输入大模型,虽然简单,但词量增多时干扰增强,效果下降。为解决这一问题,通义实验室采用RAG(检索增强生成)机制: