
 语音小管家
在 AI 文字识别类应用的落地过程中,有一个被低估却非常关键的环节:文档解析。
无论是科研、金融、法律,还是教育、医药、制造业,日常处理的海量文档里,总有一大类以 PDF、扫描件、图片的形式存在。
要想把它们转化为 AI 可用的知识,需要先经历一个复杂的过程:OCR 识别 → 布局分析 → 元素提取 → 结构化表示。
但现实中,这个流程经常不尽人意:
OCR 可能识别错字; 表格、公式、化学结构往往被“读坏”; 页眉页脚、广告水印混杂在正文里; 结构信息(如段落层级、位置坐标)被破坏 ...
等等问题最终导致后续 AI 难以理解。
所以在很多场景下,工程师不得不组合多个工具,写一堆清洗代码,才能勉强得到一份还算能用的结构化数据。
最近,阿里巴巴开源了一款全新的端到端文档解析模型——Logics-Parsing,试图一举解决这些问题。
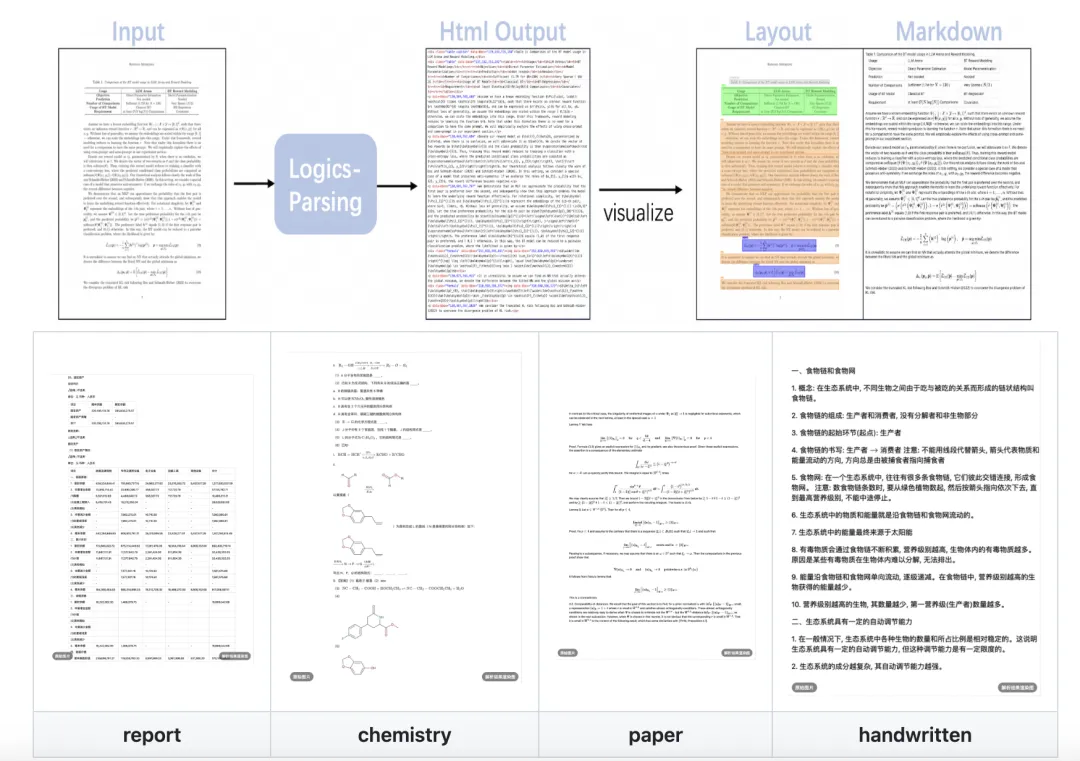
它基于 VLM(视觉语言模型),能直接从文档图片“一步到位”生成结构化的 HTML 数据,保持文档的逻辑结构。
核心亮点
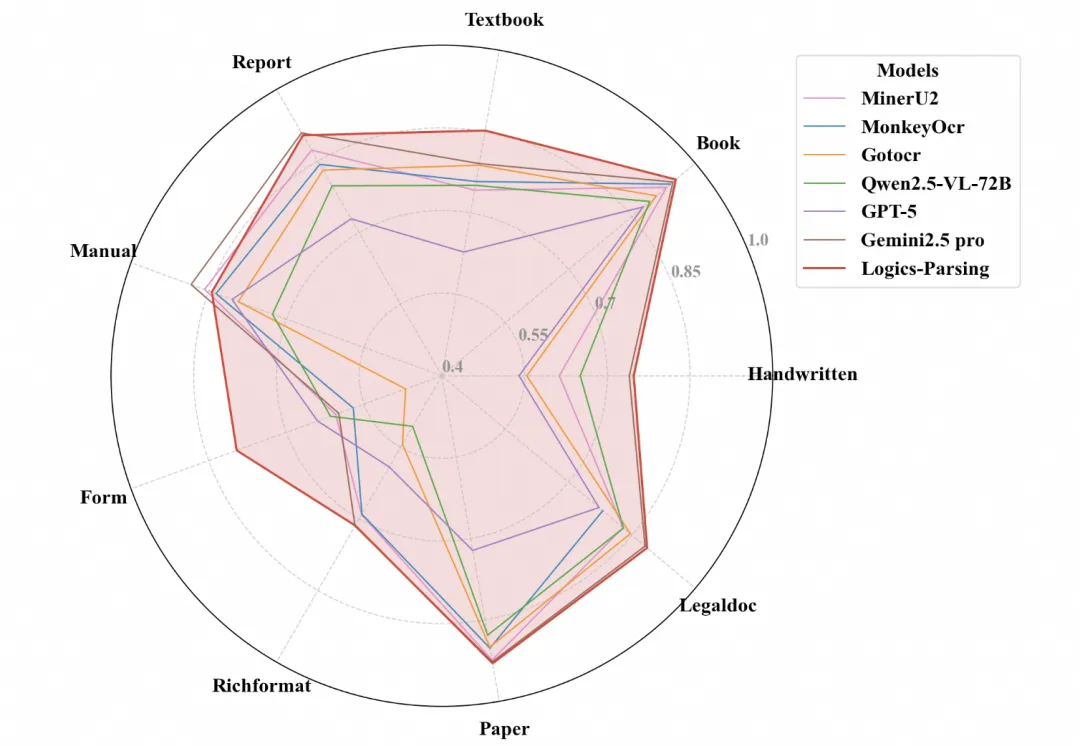
用三个关键词来概括:统一、智能、精细。
1、统一模型:一步到位
传统的文档解析,一般是“流水线式”的:OCR → 布局检测 → 表格识别 → 公式解析 → 后处理。每个环节用不同的模型,再拼接结果,往往带来精度损失和兼容性问题。
Logics-Parsing 则选择了端到端统一模型的路线:
• 输入:一张文档图片; • 输出:带有逻辑结构的 HTML 代码。
这样一来,不需要额外拼接工具,整个过程直接由模型完成,大幅降低了复杂度。
2、智能解析:复杂文档也能搞定
Logics-Parsing 基于 VLM,通过监督微调 + 强化学习训练,具备较强的跨模态理解能力。
它不仅能处理常见的段落、标题、图片,还特别擅长以下复杂元素:
• 公式:数学公式能被正确识别和标注; • 化学结构:化学方程式、分子式能被解析; • 手写内容:常见于扫描试卷、批注文档; • 表格:能识别表格边界、行列结构,并保持数据对齐。
3、精细化输出:HTML + 坐标 + 分类
Logics-Parsing 的输出结果不仅是 HTML,还包含了丰富的标注信息:
• 类别标签:段落、表格、公式、图片、注释等都会被分类; • 位置坐标:元素在页面上的位置被保留下来; • OCR 文本:每个元素对应的文字内容; • 噪声过滤:自动去掉页眉、页脚、水印等干扰内容。
快速入手
1、搭建运行环境
conda create -n logis-parsing python=3.10
conda activate logis-parsing

pip install torch==2.5.1 torchvision==0.20.1 torchaudio==2.5.1 --index-url https://download.pytorch.org/whl/cu124
2、下载权重模型
# Download our model from Modelscope.
pip install modelscope
python download_model.py -t modelscope

# Download our model from huggingface.
pip install huggingface_hub
python download_model.py -t huggingface
3、推理
python3 inference.py --image_path PATH_TO_INPUT_IMG --output_path PATH_TO_OUTPUT --model_path PATH_TO_MODEL 应用人群
写在最后
阿里这次开源的Logics-Parsing,是一个里程碑式的工具。
它让我们看到,文档解析不再是多工具拼接的“折衷方案”,而是可以通过一个端到端的统一模型,直接完成从“文档图片 → 结构化 HTML”的全过程。
无论你是科研人员、工程师,还是企业用户,这个项目都能在文档数据处理上为你节省大量成本。
未来,如果社区继续推动它的发展,还有些可能的升级方向,比如:
• 多语言文档解析(中英文混排、阿拉伯语、日韩文); • 更强的版面理解(跨页表格、跨页段落合并); • 与可视化工具结合,输出可交互文档; • 与 LLM 深度集成,支持问答、摘要、知识抽取。
GitHub 项目地址:https://github.com/alibaba/Logics-Parsing
