
 语音小管家
AI视频生成这一年来太卷了。从OpenAI的Sora、Kuaishou的可灵、到字节的即梦,我们几乎每隔一段时间就能看到一款“要革影视行业命”的视频模型问世。而这一次,轮到「美团」出手。
美团团队刚刚在 GitHub 上开源了一款名为LongCat-Video的通用视频生成模型,参数量达 13.6B。
能文生视频、图生视频,还能视频续写,更重要的是:它能在几分钟内生成 720p、30fps 的长视频,画面连贯、人物稳定、物理逻辑也说得过去。
项目地址:https://github.com/meituan-longcat/LongCat-Video
⏩核心优势
长视频原生支持:预训练于Video-Continuation,避免颜色/质量漂移,分钟级生成。
高效架构:粗细生成+Block Sparse Attention,单GPU推理快,FlashAttention-2/3优化。 多任务统一:Text/Image/Video输入一致框架,激活参数13.6B,dense设计简洁。
⏩技术原理
LongCat-Video只有13.6B,但集成了文生视频、图生视频和视频续生三大任务于一体。
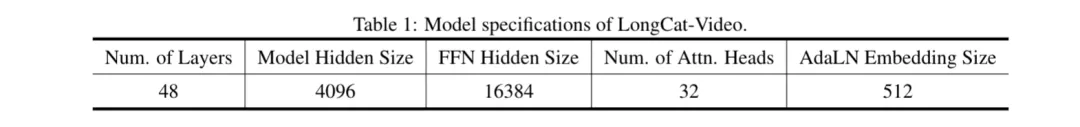
具体来说,整个模型以Diffusion Transformer (DiT)为框架设计,其中每个Transformer块都由3D自注意力层、交叉注意力层,以及采用SwiGLU激活函数的前馈网络组成。
并使用AdaLN-Zero调制机制,将每个Transformer块均集成为专用的调制多层感知机,再在自注意力和交叉注意力模块中,采用RMSNorm归一化以提升训练稳定性,另外还对视觉token的位置编码使用3D RoPE。
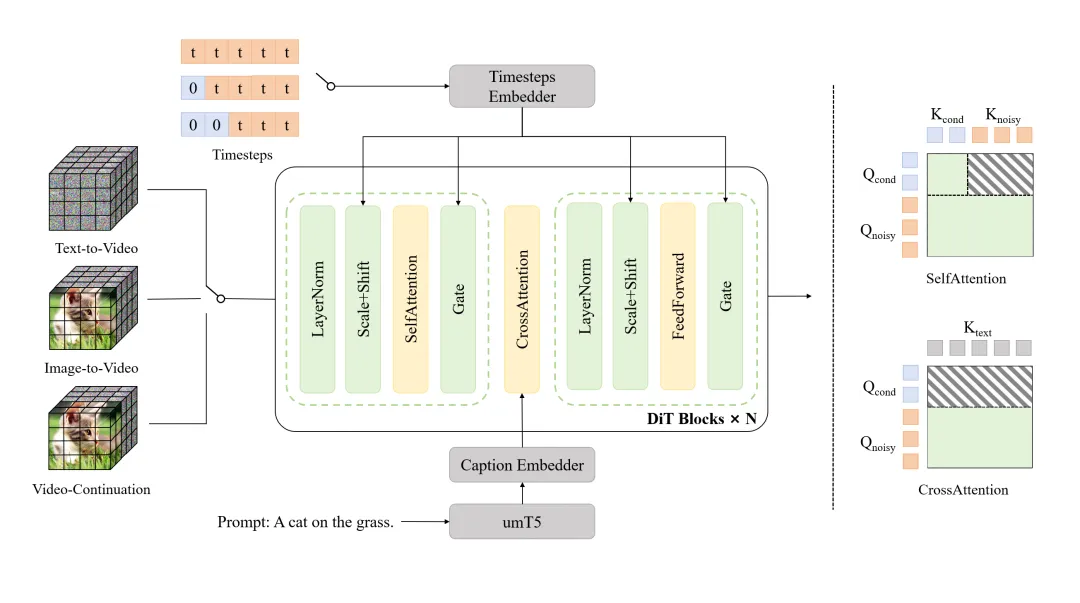
然后将所有任务都定义为视频续生任务,通过条件帧数量进行区分:
文本到视频:0帧条件。
图像到视频:1帧条件。
视频续生:多帧条件。
统一混合输入后,将无噪声的条件帧和待去噪的噪声帧沿着时间轴拼接,结合时序步配置,以实现单模型原生支持多任务。
而为了适配这类输入,研究团队还在架构中设计了一种带键值缓存(KVCache)的块注意力机制,该设计可以确保条件token不受噪声token的影响,且后续可以缓存并复用条件token的KV特征,提升长视频生成效率。
其中最瞩目的长视频生成能力,主要通过原生预训练设计和交互式生成支持两大核心特性实现。
首先LongCat-Video摒弃了传统的“先训练基础视频生成能力,再针对长视频任务微调”的训练路径,而是直接在视频续生任务上预训练。
这样做可以直接从源头解决长视频生成中的累积误差问题,在生成分钟级视频的同时,避免色彩漂移和质量下降。
另外LongCat-Video还支持交互式长视频生成,允许用户为不同片段设置独立指令,进一步扩展了长视频创作的灵活性。
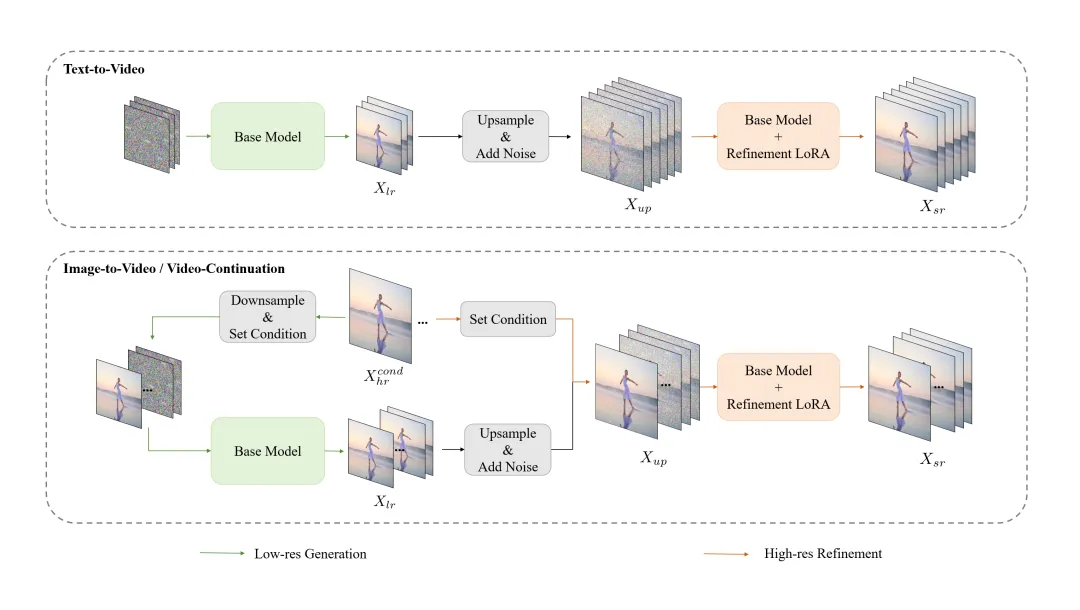
为了提高视频生成的推理效率,团队提出了一种从粗到精的生成范式,先是让模型生成480p、15fps的低分辨率低帧率视频,再通过三线性插值将分辨率升级至720p、30fps,同时由一个LoRA训练的精炼专家模型进行细节优化。
再引入块稀疏注意力,将注意力计算量降至原始的10%以下,配合上下文并行的环形块稀疏注意力,进一步优化高分辨率生成效率。
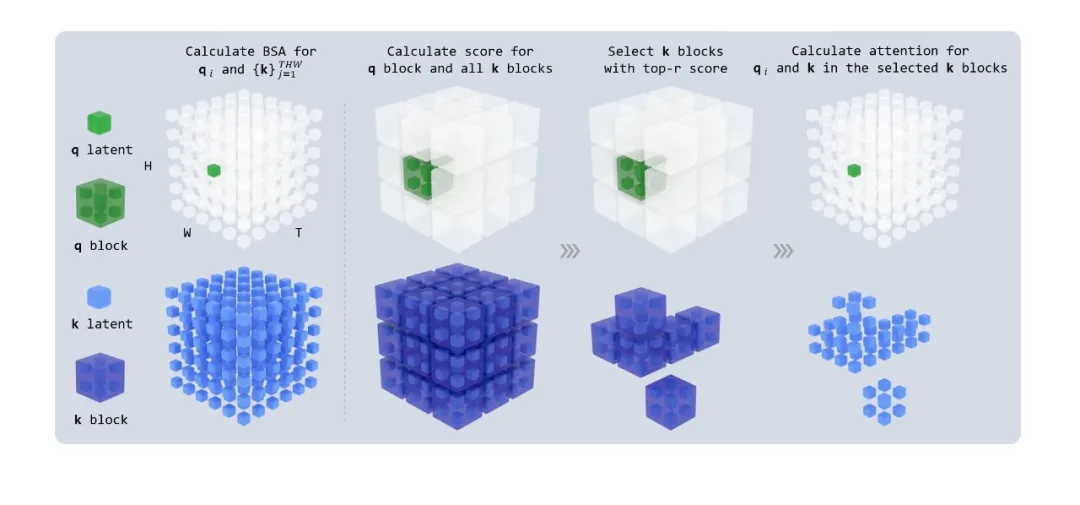
结合CFG蒸馏和一致性模型(CM)蒸馏,将采样步数从50步缩减至16步,实现在单H800 GPU上,单个720p、30fps视频生成可在分钟内完成,效率提升超10倍。
另外针对视频生成场景,使用组相对策略优化 (GRPO)算法,提升GRPO在视频生成任务中的收敛速度与生成质量。
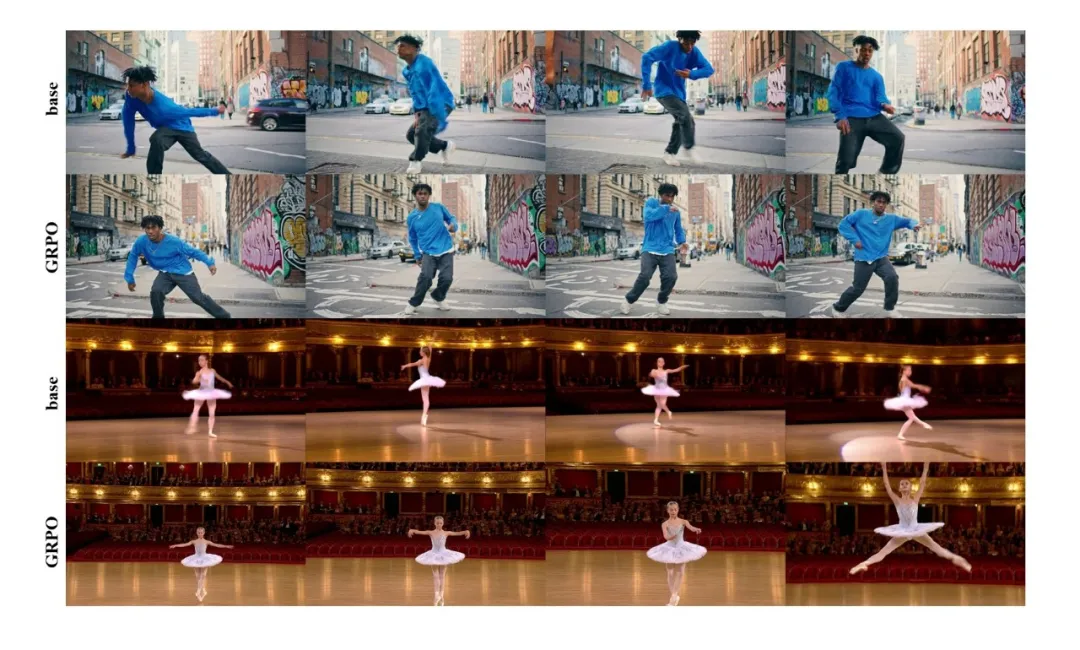
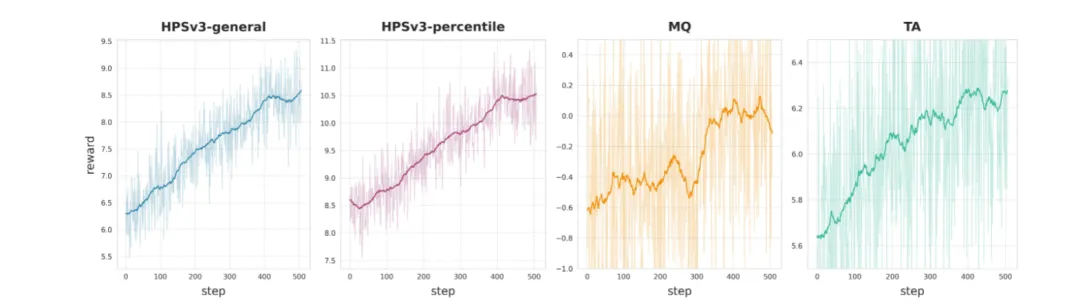
在训练过程中,分别采用三类专用奖励模型:
视觉质量
(VQ):结合HPSv3-general和HPSv3-percentile进行评估。
运动质量
(MQ):基于VideoAlign模型微调,并使用灰度视频训练避免色彩偏好。
文本-视频对齐度
(TA):同样基于VideoAlign模型微调,但保留原始的彩色输入。
然后进行多奖励加权融合训练,避免单一奖励的过拟合和奖励欺骗问题,实现视觉、运动、对齐能力的均衡提升。
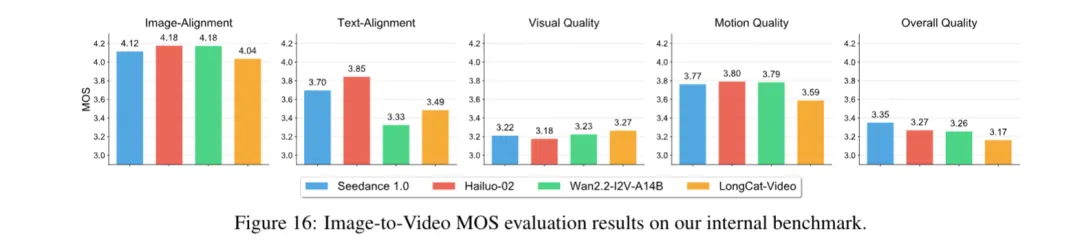
在完成数据构建和模型训练后,研究团队首先对其进行内部基准测试,主要评估文生视频和图生视频性能。
其中文生视频,包含文本对齐、视觉质量、运动质量、整体质量四个维度。
实验结果表明,LongCat-Video在整体质量得分中超越PixVerse-V5和Wan2.2-T2V-A14B,视觉质量接近Wan2.2-T2V-A14B,仅略逊于闭源模型Veo3。
图生视频则在此基础上,新增图像对齐维度评估,最终结果中LongCat-Video的视觉质量得分最高(3.27),说明整体质量具有竞争力,但图像对齐与运动质量仍有提升空间。
另外研究团队还进行了VBench 2.0的公开基准测试,LongCat-Video总得分位列第三(62.11%),仅次于Veo3(66.72%)和Vidu Q1(62.7%)。
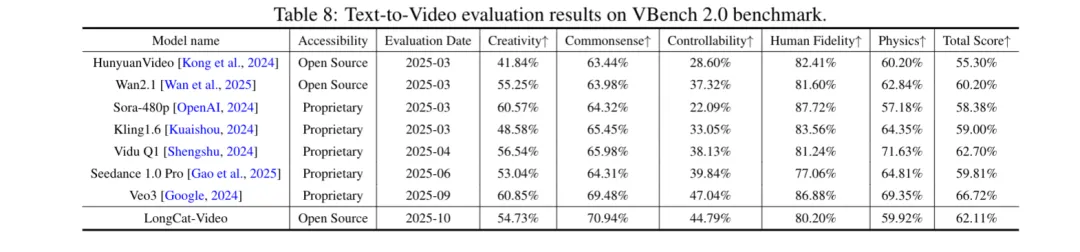
值得注意的是,LongCat-Video在常识性维度(运动合理性、物理定律遵循)上处于第一的领先优势,凸显出该模型优秀的物理世界建模能力。
⏩安装部署
1、克隆项目
git clone https://github.com/meituan-longcat/LongCat-Video
cd LongCat-Video
2、安装依赖
# create conda environment
conda create -n longcat-video python=3.10
conda activate longcat-video

# install torch (configure according to your CUDA version)
pip install torch==2.6.0+cu124 torchvision==0.21.0+cu124 torchaudio==2.6.0 --index-url https://download.pytorch.org/whl/cu124

# install flash-attn-2
pip install ninja
pip install psutil
pip install packaging
pip install flash_attn==2.7.4.post1

# install other requirements
pip install -r requirements.txt
3、模型下载
pip install "huggingface_hub[cli]"
huggingface-cli download meituan-longcat/LongCat-Video --local-dir ./weights/LongCat-Video
文本转视频
# Single-GPU inference
torchrun run_demo_text_to_video.py --checkpoint_dir=./weights/LongCat-Video --enable_compile

# Multi-GPU inference
torchrun --nproc_per_node=2 run_demo_text_to_video.py --context_parallel_size=2 --checkpoint_dir=./weights/LongCat-Video --enable_compile
图像转视频
# Single-GPU inference
torchrun run_demo_image_to_video.py --checkpoint_dir=./weights/LongCat-Video --enable_compile

# Multi-GPU inference
torchrun --nproc_per_node=2 run_demo_image_to_video.py --context_parallel_size=2 --checkpoint_dir=./weights/LongCat-Video --enable_compile
视频延续
# Single-GPU inference
torchrun run_demo_video_continuation.py --checkpoint_dir=./weights/LongCat-Video --enable_compile

# Multi-GPU inference
torchrun --nproc_per_node=2 run_demo_video_continuation.py --context_parallel_size=2 --checkpoint_dir=./weights/LongCat-Video --enable_compile
长视频生成
# Single-GPU inference
torchrun run_demo_long_video.py --checkpoint_dir=./weights/LongCat-Video --enable_compile

# Multi-GPU inference
torchrun --nproc_per_node=2 run_demo_long_video.py --context_parallel_size=2 --checkpoint_dir=./weights/LongCat-Video --enable_compile
GPU 推理
# Single-GPU inference
streamlit run ./run_streamlit.py --server.fileWatcherType none --server.headless=false
⏩视觉表现
细节仍有AI痕迹,但整体自然流畅。
根据社区测试视频与官方样例,LongCat 的视频表现大致可以用以下几个关键词描述:
时间一致性良好:人物动作连贯,镜头切换自然; 物理世界理解较好:重力、光影、流体等表现合理; 人物表情自然:动作不生硬; 细节仍有AI痕迹:局部边缘、指尖、衣纹仍存在轻微错乱;
⏩应用前景
广告与短视频自动生成:根据产品文案,自动生成可播视频素材; 视频续写与剧情创作:AI编剧、AI导演工具可以调用LongCat,实现镜头接续、场景连贯。 数字人视频生成:与语音模型结合,可实现从文本到完整讲述视频。 游戏与虚拟世界生成:自动生成动态场景、角色交互视频,用于游戏预演或动画素材。
⏩写在最后
相比 Sora 或 Kling 的“短平快”,LongCat-Video 的长视频一致性亮眼:颜色不漂移、画质不崩盘、环境稳定,细节虽有 AI 痕迹,但整体逼真度已接近商用级。
它可能不会像Sora那样精致、像Kling那样商业化,但它带来了更重要的东西——可研究、可复现、可创新的长视频生成框架。
在不久的将来,我们也许可以只用一句话,让AI帮我们拍出几分钟的短片、广告甚至微电影。
GitHub 开源项目:https://github.com/meituan-longcat/LongCat-Video
