
 语音小管家
论文题目:《TASU: Text-Only Alignment for Speech Understanding》
01、引言:为啥要搞TASU?
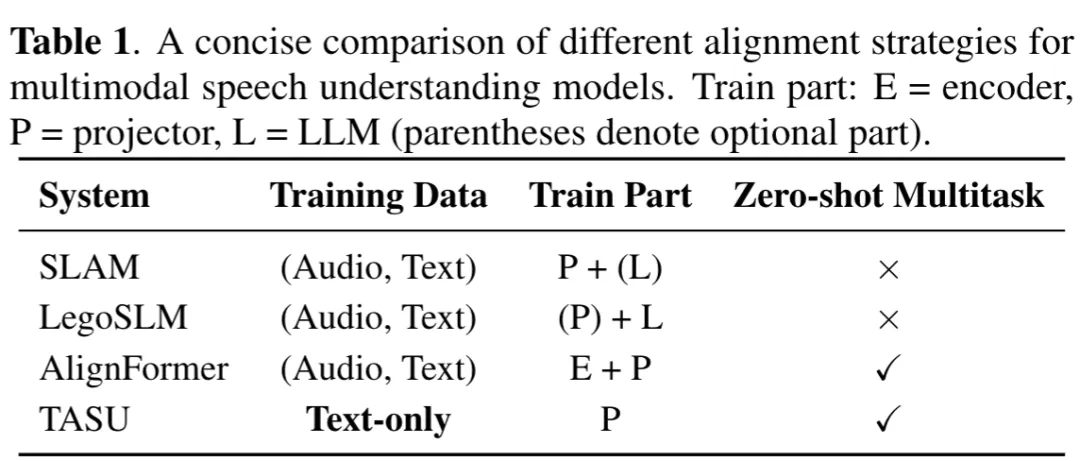
一是用“连续特征投影”对齐语音和文本时,会引入很多冗余信息,不仅训练推理费资源,还容易过拟合; 二是要想性能好,得靠海量音文配对数据和复杂训练流程,碰到没见过的领域或任务,泛化能力就拉胯。
02、相关工作:前人的方法差在哪?
AlignFormer:虽然能用CTC信号下采样音频特征,还有点指令跟随能力,但一旦只有少量音文数据,多任务性能暴跌(比如选择题准确率快接近瞎蒙);
LegoSLM:用CTC后验给LLM的词嵌入加权,虽然特征更规整,但牺牲了多任务能力,还得用大规模数据重新对齐LLM的词汇表。
03、TASU核心方法:两大模块+训练推理流程
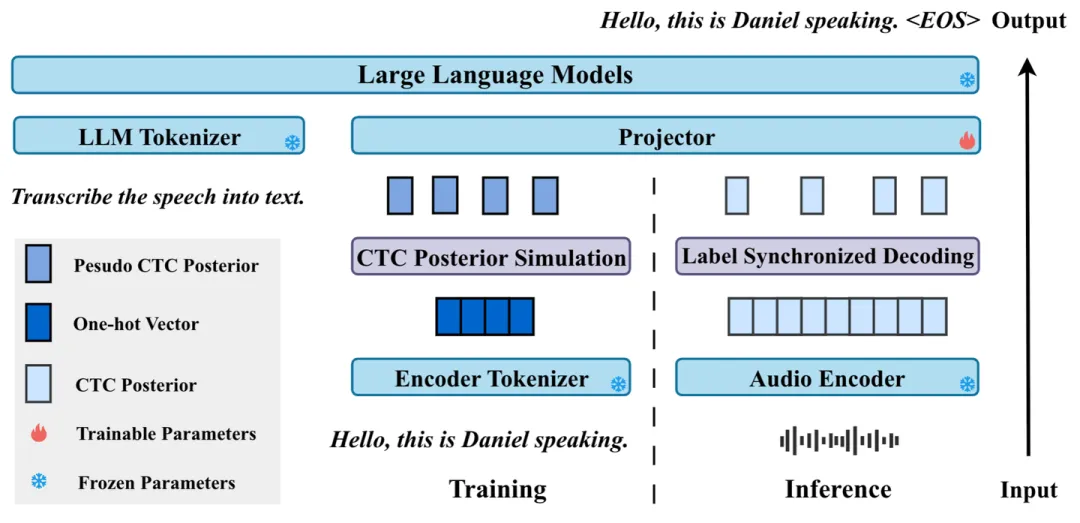
删空白帧:设个阈值τ(实验里用0.9),如果某帧“空白符号”的概率超过0.9,直接扔了这帧;
合并连续帧:如果有多帧的“最可能token”一样,就把这些帧的向量求平均,消除重复冗余。
随机标签平滑:把文本token的one-hot向量,和均匀分布混一下(混合系数α在0.8-1.0之间随机),模拟真实音频后验的不确定性;
随机删除:每个伪后验元素有5%概率被删掉,模拟CTC对齐时偶尔丢token的情况;
随机插入:按5%的插入率,要么插“前一帧的复制”,要么插“空白向量”,模拟CTC的重复和空白分离特性。
训练(只用文本):文本先转成one-hot向量→CPS生成伪CTC后验→训练一个“投影器”(Linear-SiLU-Linear结构),把伪后验映射到冻结的LLM输入空间(LLM参数不动,保留多任务能力); 推理(用语音):语音经Audio Encoder(用的是SenseVoice-Small)生成真实CTC后验→LSD压缩后验→预训练好的投影器把压缩后验送进LLM,输出识别结果或其他任务预测。
04、实验细节:用啥模型、数据和指标?
模型架构:语音编码器是SenseVoice-Small,LLM用Qwen2.5-1.5B(全程冻结),投影器是Linear-SiLU-Linear(只训它),投影器瓶颈维度平时1024,多任务时2048; 数据:ASR用LibriSpeech(经典数据集)、SlideSpeech、CommonVoice4;语音翻译(ST)用CoVoST2(英转中);指令理解用SLURP;领域泛化测试用TED-LIUM 3(讲座领域,跟源域差异大); 评估指标:ASR看WER(词错误率,越低越好),ST看BLEU(越高越好),多任务看MMSU的ACC(准确率,越高越好); 关键参数:LSD的τ=0.9,CPS的α范围0.8-1.0、删除/插入概率都是0.05,学习率5e-5,训练5个epoch。
05、实验结果:TASU到底行不行?
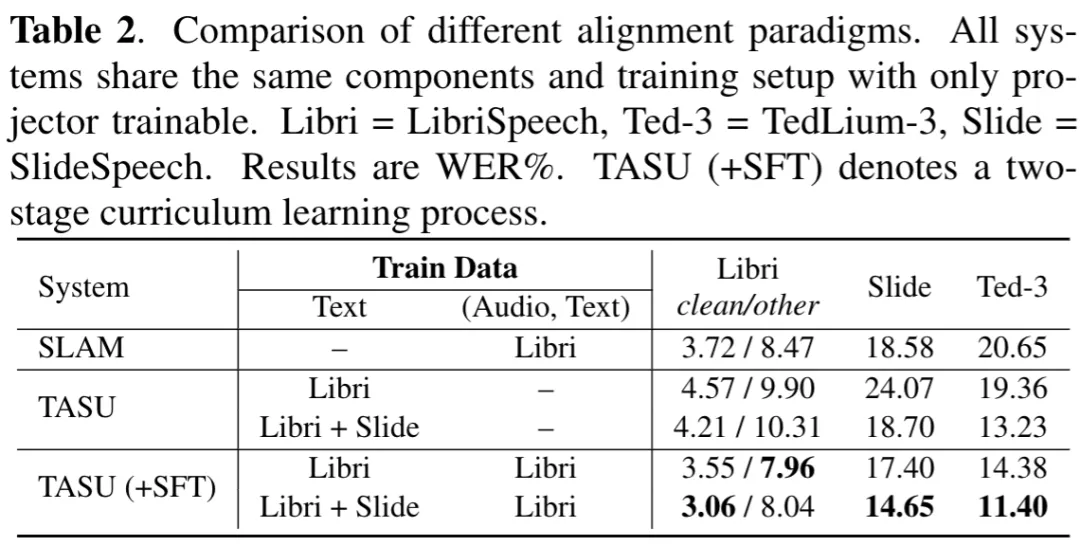
零样本能力:在LibriSpeech的clean/other测试集上,TASU的WER是4.57%/9.90%,SLAM是3.72%/8.47%,差距不到1.5%——说明只用文本训练,也能做到接近音文监督的对齐效果;
加文本数据的提升:如果TASU训练时加入SlideSpeech的文本,在TED-LIUM 3(新领域)的WER从19.36%降到13.23%,甚至超过了SLAM的20.65%;
课程学习(TASU + SFT):先文本预训练TASU,再用少量音文数据微调(SFT),效果更炸——LibriSpeech的WER降到3.55%/7.96%(比SLAM还低),TED-LIUM 3降到14.38%,SlideSpeech降到17.40%,既保了源域 accuracy,又提了泛化。
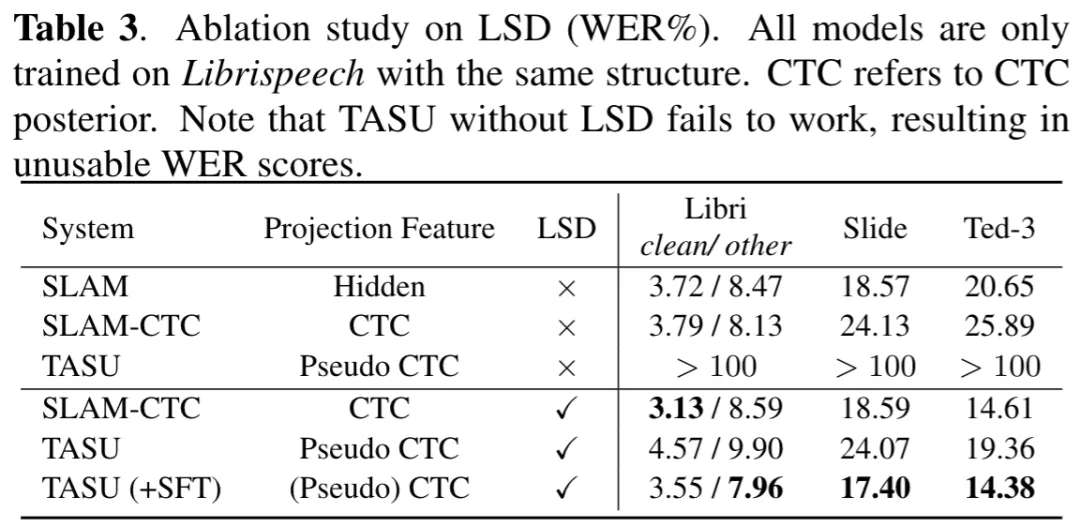
没LSD的TASU:WER全超过100%,完全没法用——说明LSD压缩冗余、保留语义的作用是不可替代的;
有LSD的对比:SLAM-CTC(用CTC后验+LSD)的Libri clean WER从3.79%(没LSD)降到3.13%,Ted-3从25.89%降到14.61%;TASU(伪CTC+LSD)也能正常工作,进一步证明LSD是TASU的核心。
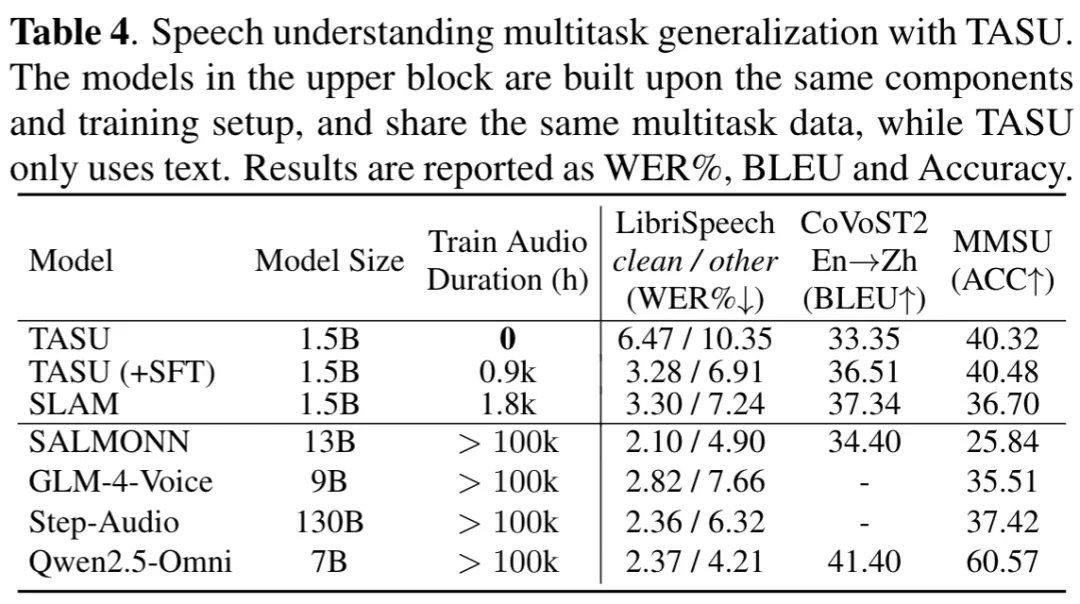
零样本多任务:TASU(1.5B参数,0小时音频)的MMSU ACC是40.32%,比用了1.8k小时音频的SLAM(36.70%)还高——说明纯文本训练的对齐效果比音文训练还好;
SFT后的提升:TASU (+SFT) 用了0.9k小时音频微调后,ASR的Libri clean/other WER降到3.28%/6.91%,ST的BLEU升到36.51%,MMSU还能保持40.48%(没掉)——说明微调只提任务性能,不丢泛化;
跟大模型对比:TASU(1.5B)的MMSU ACC超过了SALMONN-13B(25.84%)、GLM-4-Voice(35.51%)、Step-Audio(130B,37.42%),虽然比Qwen2.5-Omni(7B,60.57%)低,但TASU模型小、用的音频少,性价比极高。
06、结论&未来计划
结论很简单:TASU靠纯文本训练,搞定了三个事——零样本语音识别(差距小)、课程预训练提泛化、多任务零样本性能强,是个高效的Speech LLM对齐范式。 未来要做的:一是改进CPS,让文本模拟的伪CTC后验更接近真实音频的后验;二是用更多文本数据,看看TASU的扩展能力和性能上限能到哪。
范式创新:首次实现“纯文本训练”的Speech LLM对齐,彻底摆脱对音文配对数据的依赖;
效率创新:LSD实现6倍下采样,既减训练推理成本,又缓解过拟合;
方法创新:CPS通过三步随机操作,精准模拟CTC后验特性,让文本替代音频训练成为可能;
性能创新:零样本和多任务能力都超过主流方法,小模型也能打赢大参数Speech LLM。
