
 语音小管家
零样本语音转换(Zero-shot VC)旨在保留语音语言内容的同时,将源说话人音色迁移至任意未见过的目标说话人。日益丰富的应用场景对模型的流式推理能力提出迫切需求,亟需兼具快速、轻量与高保真特性的解决方案。然而现有流式方法依赖自回归(AR)或非自回归(NAR)框架 —— 前者需庞大参数量才能保障性能,后者则难以泛化到未见过的目标说话人,均存在明显局限。为此我们提出轻量级流式零样本语音转换方法MeanVC,通过融合 AR 与 NAR 范式优势的块级自回归去噪扩散 Transformer,结合均值流实现单次采样高效转换,辅以扩散对抗性后训练优化质量,有效平衡了快速、轻量、高保真三大需求。目前模型已经开源,技术报告已公开,欢迎大家使用。
作者列表:马国斌,姚继珣,宁子谦,姜月鹏,熊玲欣,谢磊,朱鹏程
合作单位:吉利汽车研究院
开源地址:https://github.com/ASLP-lab/MeanVC
样例展示:https://aslp-lab.github.io/MeanVC
预印版:https://arxiv.org/pdf/2510.08392
零样本语音转换(Zero-shot VC)旨在根据目标说话人一段语音样本即可迁移源说话人音色至未该目标说话人,同时保留语言内容,广泛应用于电影配音、隐私保护等场景。尽管现有深度学习模型在自然度和相似度上表现突出,但实时部署需求下,计算成本、延迟与保真度的平衡成为核心瓶颈,亟需快速、轻量、高保真的流式模型。
现有流式零样本 VC 主要分为两类架构:自回归(AR)框架(如 StreamVoice 系列)虽能输出高保真结果,但串行解码导致高延迟,且模型规模庞大(超 100M 参数),难以满足轻量和快速要求;非自回归(NAR)框架(如 DualVC2、Seed-VC)通过并行生成降低延迟,但存在泛化能力不足或长时上下文碎片化问题,牺牲了保真度与一致性。两者的矛盾使得领域内缺乏能融合速度优势与质量优势的统一框架。
Interspeech2023 | DualVC—基于模型内蒸馏与混合预测编码的双模语音转换模型
ICASSP2024 | DualVC 2:基于动态掩蔽卷积的流式与非流式统一语音转换模型
INTERSPEECH2024 | DualVC 3:利用LM生成伪上下文的端到端低延迟流式语音转换
为此,本文提出轻量级流式框架 MeanVC,通过块级自回归去噪保证说话人特征一致性,借助平均流(Mean Flows)使扩散模型 1 次评估即可生成高质量结果,再经扩散对抗性后训练(DAPT)优化语音质量。该模型仅 14M 参数,有效平衡了快速、轻量、高保真三大需求,主观与客观评估均优于现有系统。
如图 1 所示,MeanVC 基于主流的 “识别 - 合成” 框架构建[1],包含流式自动语音识别(ASR)模块、说话人编码器、音色编码器、扩散 Transformer (DiT)[2]解码器及声码器。预训练流式 ASR 模型先从源语音波形中提取瓶颈特征(BNFs);这些 BNFs 随后被输入音色编码器,与从参考梅尔频谱图中提取的细粒度音色信息融合,生成音色增强BNFs(timbre BNFs)。与此同时,预训练说话人编码器从参考语音波形中提取说话人嵌入向量。DiT 解码器以说话人嵌入向量和 timbre BNFs 为条件,生成转换后的梅尔频谱图。生成阶段,源语音梅尔频谱图被拼接于前端作为缓存,为块级自回归去噪提供支撑,最终输出具备目标说话人音色的转换频谱图。
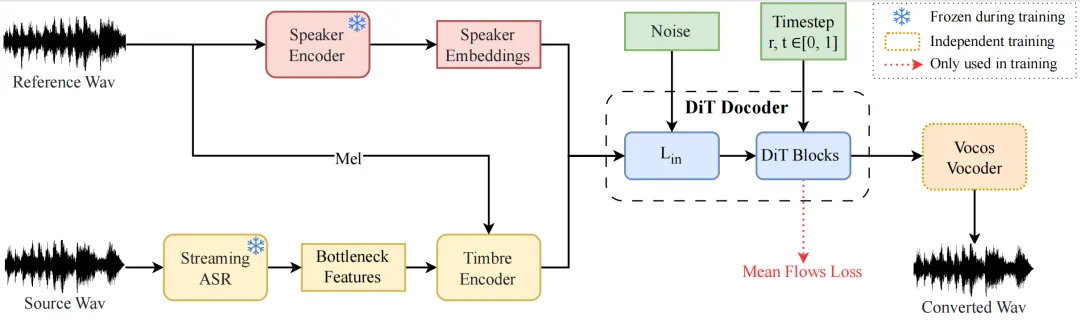
图1 MeanVC 模型结构
块级自回归去噪
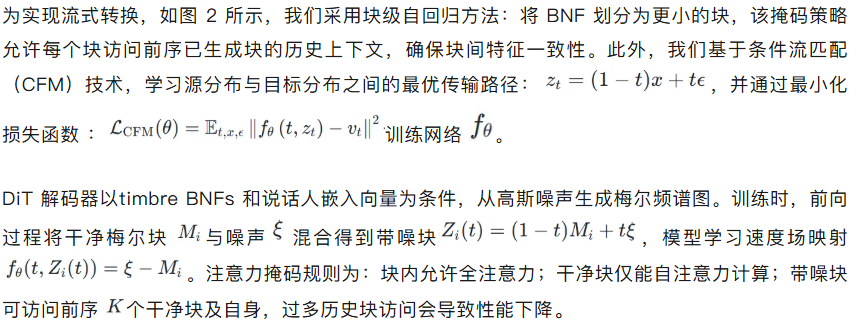
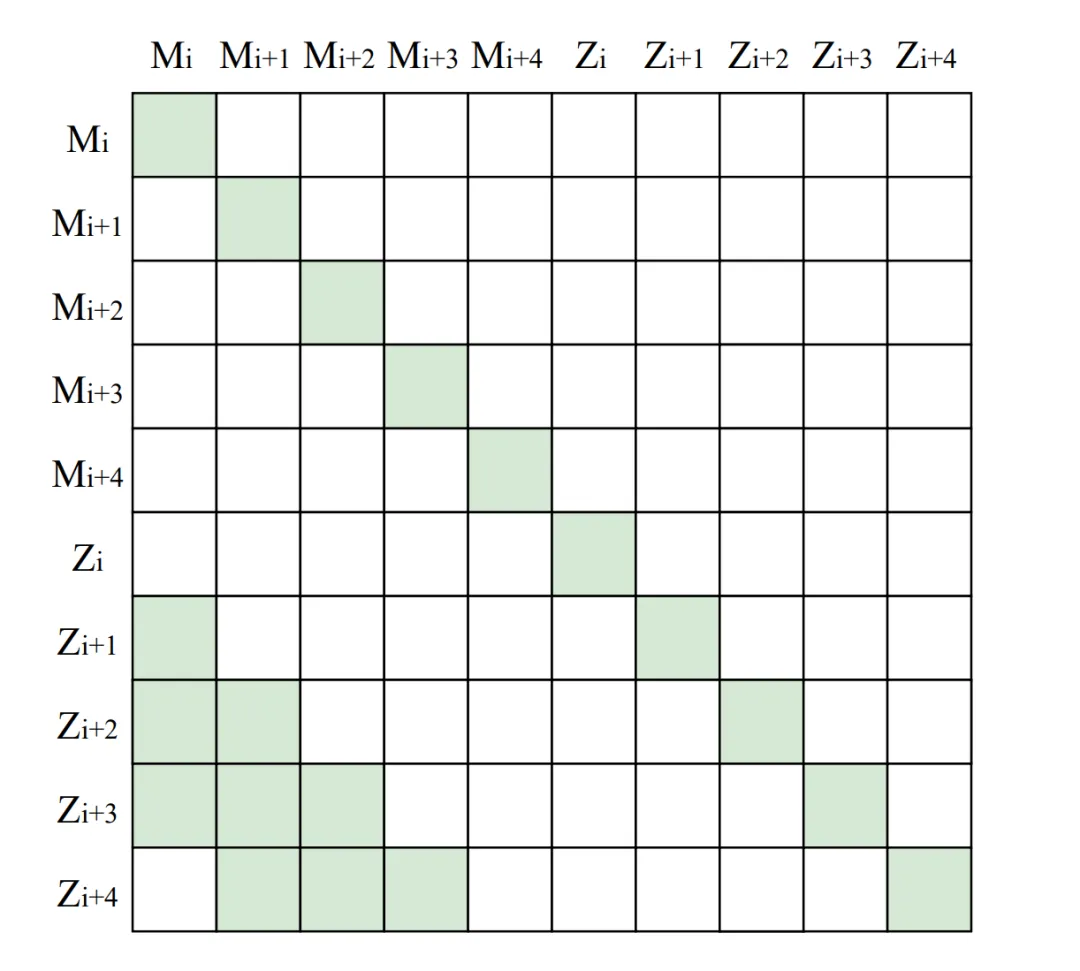
图2 块级自回归掩码
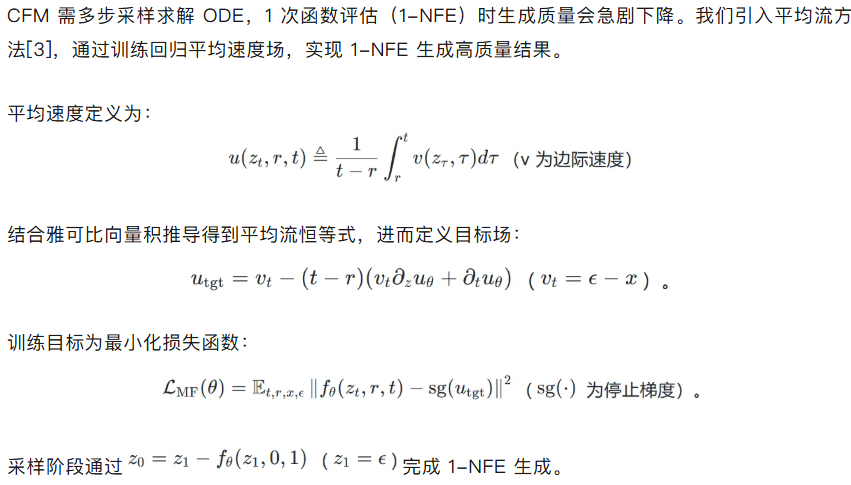
面向生成模型的平均流
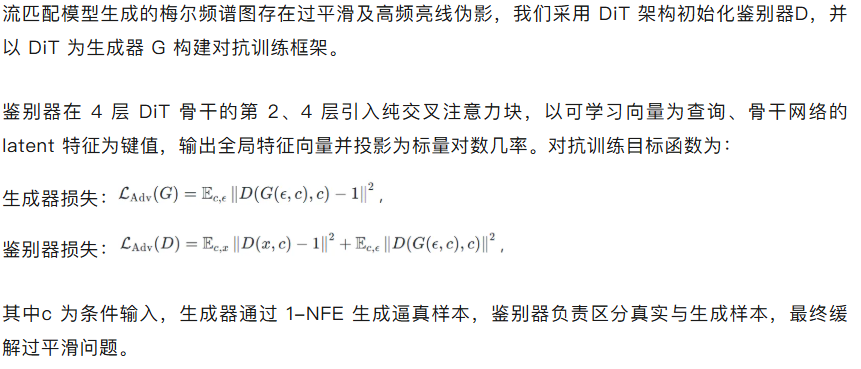
扩散对抗性后训练
实验数据:数据为Emilia,采用DNSMOS指标过滤掉DNSMOS得分低于3.4的音频,最终保留10,000小时的中文数据。
对比系统:
StreamVoice[4]:基于语言模型的系统,采用完全因果的上下文感知机制,通过交替处理语义特征与声学特征实现流式零样本语音转换;
Seed-VC[5]:基于扩散模型的NAR系统,通过外部音色迁移器缓解音色泄露问题,并借助滑动窗口流水线实现流式零样本语音转换;
DualVC2[6]:基于Conformer架构的轻量级NAR系统,采用传统非因果卷积与动态掩码卷积,实现流式“any-to-many”语音转换。
零样本评估
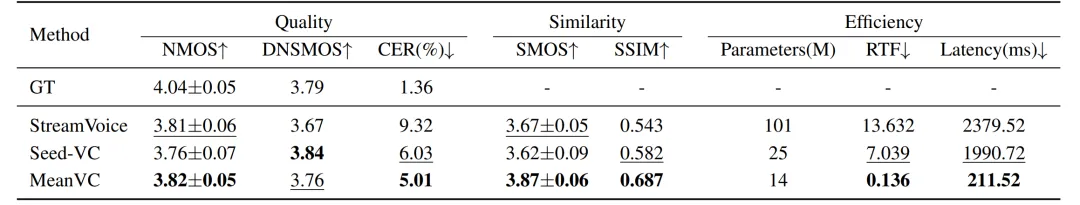
如表 1 所示,MeanVC在主观指标SMOS与NMOS上均优于所有基线系统,且在客观指标CER与SSIM上取得最优性能,充分验证了其在零样本语音转换任务中的优异表现。不过,MeanVC的DNSMOS得分略低于Seed-VC,我们认为这一差异主要源于其参数量远小于Seed-VC。
效率方面,MeanVC的语音转换核心模块在单核单线程AMD EPYC 7542 CPU上的实时因子(RTF)为0.136,显著低于各基线系统。实时处理的核心要求是RTF<1.0,而MeanVC完整流水线(含RTF=0.120的ASR编码器与RTF=0.066的声码器)的总RTF仅为0.322,完全满足实时处理约束。延迟表现上,160毫秒块大小配置下,模型推理延迟为51.52毫秒;包含块时长的总流水线延迟为211.52毫秒(160毫秒+51.52毫秒),性能显著优于基线系统。需说明的是,所有实验的效率指标均未采用量化等优化手段,实际部署中性能仍有提升空间。
表1 零样本性能(未见过的说话人场景)
数据集内评估
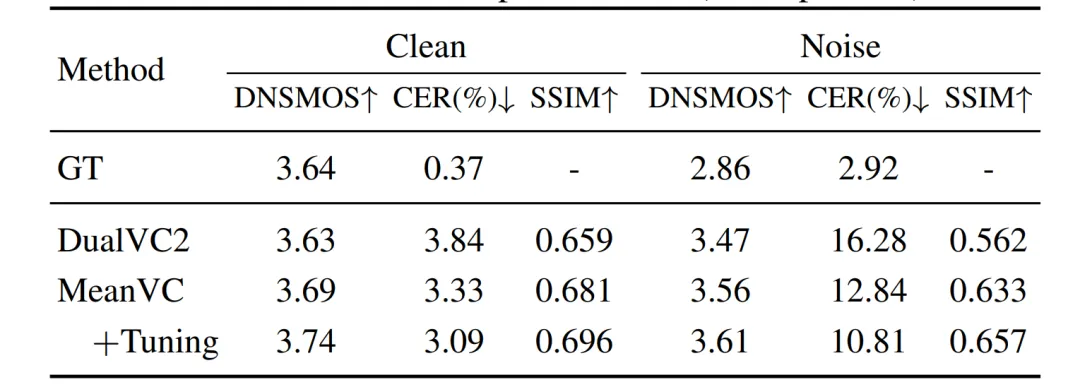
为深入剖析MeanVC的性能边界,我们在已知目标说话人场景下开展评估:在Aishell3数据集上对模型进行微调,选取4名说话人作为目标对象,并与“any-to-many”语音转换模型DualVC2进行对比。具体而言,我们采用与MeanVC参数量相当的模型配置,分别在Emilia和Aishell3数据集上从头训练DualVC2。如表 2 所示,即便不进行微调,MeanVC在所有评估指标上均优于DualVC2,且在带噪输入场景下优势更为显著,证明其具备更强的鲁棒性与转换能力。若能获取目标说话人的少量语音样本,通过微调可进一步提升性能——这一结果表明,MeanVC在“有无目标说话人先验样本”的各类实际场景中均具备出色的适用性。
表2 数据集内性能(见过的说话人场景)
消融实验
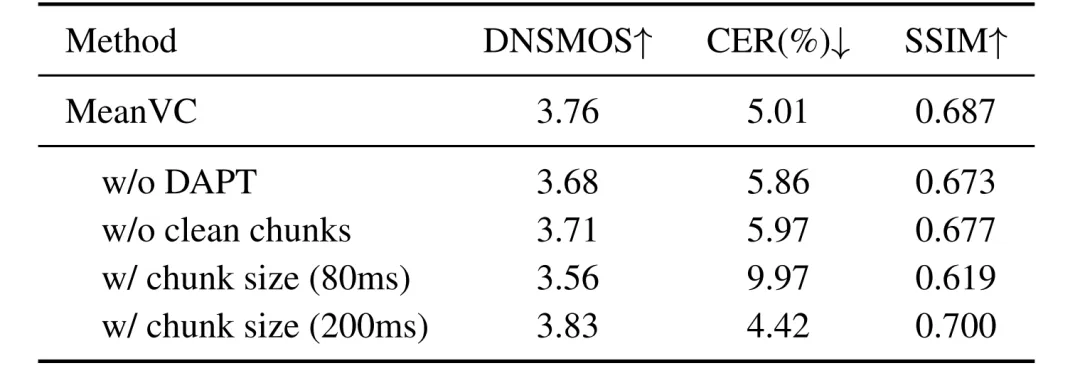
为验证MeanVC核心组件的有效性及超参数的影响规律,我们开展了一系列消融实验,结果如表 3 所示。
核心模块有效性:移除扩散对抗性后训练(DAPT)模块后,各项评估指标均出现明显下降,证实该模块在缓解生成语音过平滑、提升语音自然度与细节丰富度方面的关键作用;禁用干净梅尔频谱图缓存机制后,模型性能显著下滑,说明该机制能有效降低训练和推理之间的不匹配,保障语音内容可懂度。
块大小对性能与延迟的权衡:将流式块大小从默认160毫秒调整为80毫秒时,推理延迟减半,但性能明显下降,归因于上下文信息不足导致声学建模精度降低;将块大小增至200毫秒时,更丰富的声学上下文信息促使各项指标均显著提升,但总延迟增加25%。这些结果清晰展现了流式流水线中“性能-延迟”的权衡关系。
表3 消融实验结果
[1] Jing-Xuan Zhang, Zhen-Hua Ling, and Li-Rong Dai, “Nonparallel sequence-to-sequence voice conversion with disentangled linguistic and speaker representations,” IEEE ACM Trans. Audio Speech Lang. Process., vol. 28, pp. 540–552, 2020.
[2] William Peebles and Saining Xie, “Scalable diffusion models with transformers,” in ICCV. 2023, pp. 4172–4182, IEEE.
[3] Zhengyang Geng, Mingyang Deng, Xingjian Bai, J. Zico Kolter, and Kaiming He, “Mean flows for one-step generative modeling,” CoRR, vol. abs/2505.13447, 2025.
[4] Zhichao Wang, Yuanzhe Chen, Xinsheng Wang, Lei Xie, and Yuping Wang, “Streamvoice: Streamable context-aware language modeling for real-time zero-shot voice conversion,” in ACL (1). 2024, pp. 7328–7338, Association for Computational Linguistics.
[5] Ziqian Ning, Yuepeng Jiang, Pengcheng Zhu, Shuai Wang, Jixun Yao, Lei Xie, and Mengxiao Bi, “Dualvc 2: Dynamic masked convolution for unified streaming and non-streaming voice conversion,” in ICASSP. 2024, pp. 11106–11110, IEEE.
[6] Songting Liu, “Zero-shot voice conversion with diffusion transformers,” CoRR, vol. abs/2411.09943, 2024.
